Perché una replica fedele della SAE non ha comunque prodotto sparsità
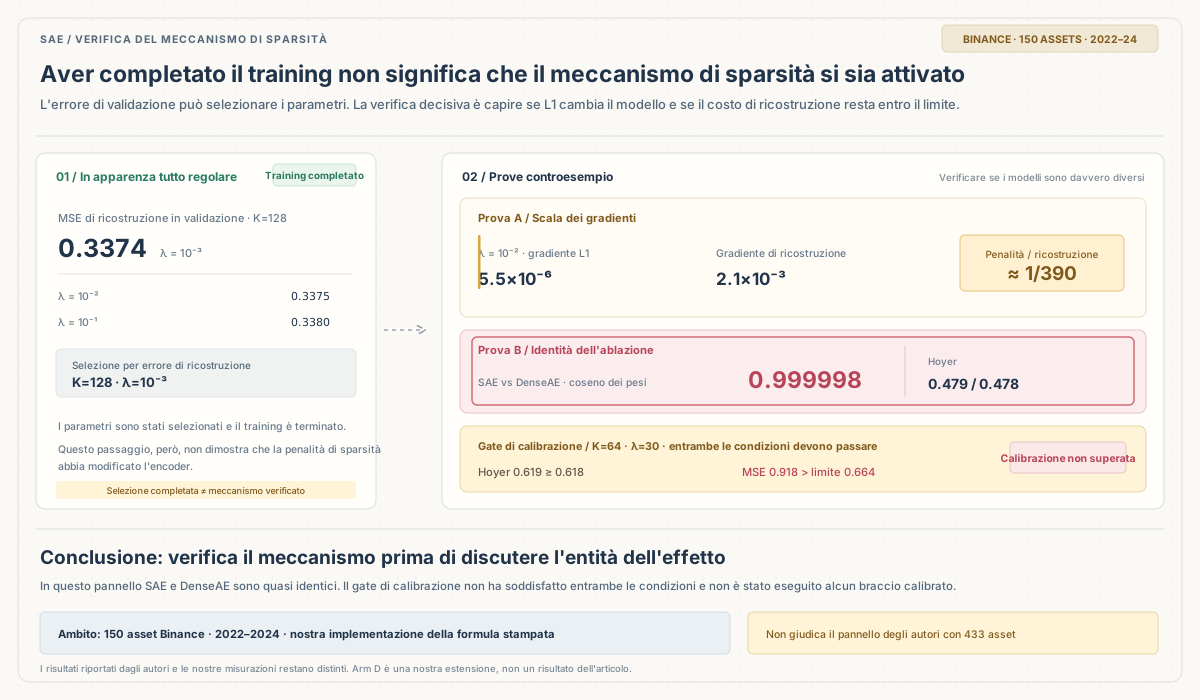
Quando il primo modello di confronto ha terminato l’addestramento, ho confrontato i pesi della SAE con quelli del controllo denso (DenseAE, λ=0). I pesi sono condivisi: encoder e decoder usano gli stessi parametri. La similarità coseno di questi pesi era 0.999998. In altre parole, il modello con la penalità di sparsità e quello senza penalità erano, in pratica, lo stesso modello. Anche la sparsità Hoyer (scala 0–1, valori più alti indicano maggiore sparsità) era quasi identica: 0.479 contro 0.478. Aggregando i cinque fold, entrambi avevano un prediction IC di +0.0073 e i risultati di portafoglio erano quasi sovrapposti.
Non mi aspettavo di imbattermi in questo già al primo confronto. Nell’articolo che cercavo di riprodurre, la sparsità è il motore dell’intera spiegazione: la penalità L1 dovrebbe rendere i codici abbastanza sparsi da far sì che i basket selezionati tramite il ranking di ricostruzione siano meno correlati tra loro e abbiano una volatilità più bassa. Se la sparsità non compare affatto, numeri successivi simili non convalidano il meccanismo dell’articolo.
Questo articolo documenta l’intero percorso della replica: cosa ha coinciso, cosa no e, soprattutto, fin dove le prove permettono di risalire alle cause delle differenze.
Che cosa sostiene l’articolo e quale forza ha ciascuna prova
Il lavoro di Han e Qu (University of Washington) è stato accettato a ICAIF ‘26. La domanda è precisa: fornire rendimenti cross-sectional giornalieri a uno Sparse Autoencoder a singolo livello, ordinare gli asset in base ai valori ricostruiti e formare portafogli contrarian per quintili. Il rischio diminuisce grazie alla sparsità stessa?
Gli autori distinguono i risultati principali in tre livelli. La distinzione conta:
- Confermato in modo rigoroso: dopo aver selezionato in anticipo K=128 e λ=0.1 sui primi 748 giorni, i basket SAE hanno avuto una volatilità in scala rank inferiore del 20–26% rispetto a PCA con lo stesso K in tutti e cinque i fold di conferma.
- Esplorativo: con K=64 la volatilità era inferiore del 32–37% (20.0% contro 27.3% in scala money). La finestra di selezione, però, si sovrapponeva ai primi fold di test; quindi è solo evidenza esplorativa. Il meccanismo proposto era una correlazione media a coppie più bassa all’interno dei basket: 0.008 contro 0.039 per PCA.
- Esplicitamente negato dagli autori: SAE non aggiungeva Sharpe rispetto alla più semplice baseline di reversal nello stesso giorno (differenza −2.48 in scala money); l’identità dei fattori non si riproduceva tra seed casuali (coseno del matching del decoder 0.13 contro 0.117 per un dizionario casuale di riferimento); inoltre un overlay di minima varianza Ledoit–Wolf recuperava circa il 73% del vantaggio di volatilità di SAE rispetto alla baseline naive.
Gli autori dichiarano anche tre limiti: i segnali sono formati alla chiusura del giorno t ed eseguiti alla stessa chiusura, cosa che definiscono “non eseguibile nella pratica”; i costi sono esclusi ovunque; la selezione dell’universo crypto usa informazioni dell’intero periodo e non è point-in-time. C’è un’altra omissione importante: al 2026-11-01 né l’articolo né la pagina arXiv collegavano codice, e la lista esatta dei 433 asset non era pubblicata. Ogni replica deve quindi reimplementare il protocollo stampato e il pannello sarà inevitabilmente diverso. Questo determina il perimetro della mia conclusione: verifico se le affermazioni sono trasferibili, non giudico se l’esecuzione degli autori sul loro pannello fosse giusta o sbagliata.
La mia configurazione di replica: prima le differenze
Ho usato candele giornaliere spot USDT di Binance tramite API pubblica. Non servivano account né chiavi API. La regola per congelare l’universo è stata fissata prima del training: dei 519 pair attualmente quotati, 285 avevano dati nella finestra 2022–2024; 245 superavano la soglia di almeno 252 giorni osservati. Ho quindi selezionato i 150 asset con la mediana più alta del quote volume giornaliero. Lista e hash sono stati salvati prima dell’addestramento. Gli asset disponibili ogni giorno erano da 89 a 150, in media 119.
Le differenze rispetto all’articolo sono esplicite: 150 asset anziché 433, limitati al sottoinsieme più liquido; 2022–2024 anziché 2019–2024; e una lista ricavata dai pair ancora negoziati oggi, quindi con survivorship tilt. L’articolo manteneva gli asset delistati fino all’ultima quotazione. Il filtro di sopravvivenza riduce sistematicamente la volatilità di questo pannello, e la volatilità è proprio il confronto centrale di questo articolo. Non è possibile ricostruire l’entità di questo bias: gli asset delistati non compaiono più nella lista di trading corrente e non si possono contare da questa fonte. Il trattamento del pannello segue l’articolo: winsorization cross-sectional giornaliera all’1/99%, forward-fill dei mancanti per un massimo di tre giorni e successiva mascheratura, quindi trasformazione rank inverse-normal con clipping. La finestra di selezione usa i primi 500 giorni di rendimento (450 training / 50 validation). I parametri vengono scelti solo in base al reconstruction error di validation, nella griglia K∈{32,64,128} × λ∈{10⁻³,10⁻²,10⁻¹} × learning rate. Seguono cinque fold expanding walk-forward, ciascuno con 119 giorni di segnale. L’ultimo giorno di segnale di ogni fold viene escluso perché serve il rendimento del giorno successivo per il PnL; restano 590 giorni di valutazione. I portafogli sono quintili contrarian ordinati per ricostruzione, equal-weighted, con gross 1 per leg. I rendimenti t+1 mancanti sono trattati come zero. Queste scelte coincidono con l’articolo.
Ho preregistrato anche due gate. La condizione di stop è semplice: se la direzione della volatilità non si riproduce nell’universo ridotto, si riporta onestamente non-replication. Non si amplia l’universo e non si regolano i parametri finché non cambia il segno. Il gate di calibrazione consente un braccio aggiuntivo nella finestra di selezione solo se la diagnostica mostra che λ non ha fatto presa: si può scegliere un λ che soddisfi “obiettivo di sparsità raggiunto e costo di ricostruzione controllato”. Se nessun valore soddisfa entrambe le condizioni, il braccio non viene eseguito. Non è neppure consentito modificare la regola dopo aver guardato il test set.
Il primo problema: su questo pannello λ è inerte
Partiamo dalla selezione dei parametri. Con K=128, il validation reconstruction MSE è quasi piatto al variare di λ: 0.3374 con λ=10⁻³, 0.3375 con 10⁻² e 0.3380 con 10⁻¹. La configurazione rigorosa scelta dalla regola è K=128, λ=10⁻³. Sul pannello degli autori è stato scelto lo stesso K, ma con il λ più forte, 0.1. La stessa regola di selezione ha prodotto preferenze opposte per la forza della penalità nei due pannelli. Scegliere solo in base all’errore di ricostruzione favorisce strutturalmente la penalità più debole, perché L1 può solo rendere più difficile la ricostruzione. La mia scelta di 10⁻³ era quindi quasi inevitabile secondo la regola. L’articolo, invece, dichiara di aver selezionato il valore più forte, 0.1, con la stessa regola descritta. Questa tensione merita di essere annotata: forse sul loro pannello una penalità forte non danneggiava davvero la ricostruzione, oppure una parte del processo di selezione non è stata descritta.
La misurazione del gradiente è più diretta. Con λ=10⁻², la configurazione esplorativa dell’articolo, il valore medio assoluto del gradiente dei pesi del termine L1 è 5.5×10⁻⁶, contro 2.1×10⁻³ per il termine di ricostruzione. La penalità è solo circa 1/390 del termine principale: non sono nella stessa scala. In una diagnostica separata — riaddestramento sui primi 500 giorni e valutazione sulla finestra del primo fold — ho portato λ a 1.0 come stress test, cento volte il valore esplorativo 10⁻² dell’articolo. Anche così, Hoyer è passato solo da 0.474 a 0.514. Il modello era ancora lontano dall’essere davvero sparso.
Nessun λ ha superato il gate di calibrazione. In una scansione su λ∈{0.3,1,3,10,30} (K=64, finestra di selezione), Hoyer è salito da 0.483 a 0.619 per poi saturarsi, mentre il validation MSE è passato dal valore DenseAE di 0.554 a 0.918, un aumento del 66%. La mia regola richiedeva che Hoyer superasse DenseAE di almeno 0.15 e che MSE restasse entro 1.2 volte il valore denso. Con λ=30, Hoyer 0.619 supera appena la soglia 0.618 (in questa misurazione DenseAE è 0.468, più 0.15). Ma MSE 0.918 è circa 1.4 volte il limite consentito di 0.664. Secondo la regola preregistrata, il braccio di calibrazione non viene eseguito. Tuttavia, “dose insufficiente” spiega solo metà del risultato. Con lo stesso protocollo, il gradiente della penalità a λ=30 era già circa 7.7 volte il gradiente di ricostruzione. La dose era più che sufficiente, eppure Hoyer si è saturato intorno a 0.62 e la ricostruzione è crollata per prima. Su questo pannello i λ nell’intervallo dell’articolo sono inerti; oltre quell’intervallo compare un altro limite. Con questi dati, sembra difficile rendere i codici molto più sparsi senza perdere qualità di ricostruzione. La causa specifica di questo limite non è stata misurata, quindi resta aperta.
Perché la stessa equazione e la stessa griglia di λ possono ridurre la correlazione interna ai basket a un quinto sul pannello dell’articolo, mentre qui non riescono nemmeno a cambiare il modello? La parte misurata è chiara: la scala relativa del gradiente della penalità e di quello di ricostruzione. Da lì in poi si tratta di un’inferenza, e ne segnalo il limite. La forza relativa di L1 dipende dalla scala tipica del codice, che cambia con il numero di asset e la struttura cross-sectional. L’articolo usa 433 asset dal 2019 al 2024; il mio pannello ha 150 asset liquidi dal 2022 al 2024. λ=0.1 può essere una dose efficace alla loro scala e agire quasi come un placebo alla mia. Non si può escludere un’altra spiegazione: dettagli implementativi non pubblicati potrebbero far sì che l’effetto effettivo della penalità differisca dall’equazione stampata. Per esempio, il training a minibatch o la convenzione di riduzione della loss. Le equazioni stampate non specificano se il termine di ricostruzione venga sommato o mediato su N asset, né se il termine L1 venga sommato o mediato su K dimensioni nascoste. La combinazione di questi due denominatori potrebbe da sola introdurre una scalatura implicita di centinaia di volte nella penalità effettiva. Senza codice ufficiale, questa possibilità resta aperta e non permette di trarre conclusioni sugli autori.
C’è un punto che non dipende da queste inferenze: con un’implementazione standard fedele alle equazioni stampate, i λ dell’articolo non sono costanti trasferibili a un altro pannello senza calibrazione. Chi applica direttamente λ=0.1 ai propri dati e poi riporta “l’effetto di diversificazione della SAE” potrebbe descrivere un meccanismo che non si è mai attivato.
Della volatilità resta solo la direzione; il meccanismo si inverte
Risultati aggregati sui cinque fold (590 giorni, scala money):
| Metodo | Volatilità annualizzata | Sharpe |
|---|---|---|
| Reversal naive dello stesso giorno | 31.39% | +1.69 |
| PCA K=64 | 29.54% | +1.75 |
| PCA K=128 | 30.39% | +1.32 |
| SAE K=64 (λ=10⁻²) | 29.90% | +0.65 |
| SAE K=128 (λ=10⁻³, selezionato) | 28.97% | +0.96 |
| DenseAE K=64 (λ=0) | 29.96% | +0.65 |
SAE-128 ha una volatilità inferiore del 4.7% rispetto a PCA-128 (per fold: −4.0, −4.2, +3.1, −3.0, −10.0; la direzione coincide con quella dell’articolo in 4 fold su 5). È circa un quinto del risultato rigoroso dell’articolo, −20–26%. Anche il dettaglio statistico conta: la media delle cinque differenze per fold è −3.6% (diversa dal −4.7% aggregato; una media tra fold, l’altra aggrega le osservazioni giornaliere), con t circa −1.7 (n=5). Non è significativo. La conclusione possibile si limita a direzione e magnitudine. K=64 non mantiene nemmeno la direzione: la volatilità SAE è superiore dell’1.2% a PCA. Alla luce della sezione precedente, non sorprende. La “SAE” selezionata con λ=10⁻³ è quasi densa, quindi il piccolo vantaggio rispetto a PCA sembra più una proprietà della ricostruzione di un autoencoder ordinario che un effetto della sparsità.
Per rendere visibile la variazione tra fold, ecco i valori di volatilità annualizzata in scala money per ciascun fold:
| Metodo | Fold 1 | Fold 2 | Fold 3 | Fold 4 | Fold 5 |
|---|---|---|---|---|---|
| Reversal naive | 22.12% | 31.31% | 32.00% | 31.37% | 37.93% |
| PCA K=64 | 21.71% | 30.42% | 27.16% | 26.53% | 39.22% |
| SAE K=64 | 20.16% | 30.32% | 30.54% | 30.56% | 35.91% |
| PCA K=128 | 21.65% | 30.88% | 29.05% | 29.51% | 38.26% |
| SAE K=128 | 20.78% | 29.58% | 29.95% | 28.61% | 34.42% |
Sul piano del meccanismo il risultato è ancora più netto. Seguendo la definizione dell’articolo, ho calcolato la correlazione media a coppie all’interno dei basket sulla scala rank, con una finestra mobile di 60 giorni. Il basket long di SAE-64 era 0.0215 e quello short 0.0297. PCA-64 era 0.0201 / 0.0261. Il reversal naive era ancora più basso: 0.0136 / 0.0148. L’articolo riporta SAE 0.008 contro PCA 0.039. Nel mio pannello l’ordine è invertito. Sulla scala dei rendimenti raw, tutti i metodi si concentrano tra 0.56 e 0.60 (domina il fattore di mercato comune), quindi neppure lì emerge un vantaggio SAE. Solo un sotto-risultato ha la stessa direzione dell’articolo: la volatilità individuale degli asset nei basket SAE è leggermente superiore a quella PCA (0.0478 giornaliero contro 0.0466). SAE non ha quindi semplicemente scelto asset più tranquilli, ma gli asset scelti non erano nemmeno meno correlati.
| Metodo | Correlazione basket long | Correlazione basket short |
|---|---|---|
| SAE K=64 | 0.0215 | 0.0297 |
| PCA K=64 | 0.0201 | 0.0261 |
| Reversal naive | 0.0136 | 0.0148 |
| Articolo: SAE / PCA | 0.008 / 0.039 | 0.010 / 0.044 |
La mia lettura della prima affermazione dell’articolo è quindi questa: a K=128 la direzione compare in parte, ma la magnitudine non si riproduce; K=64 e l’affermazione sul meccanismo non si riproducono. Questo non falsifica il risultato degli autori sul loro pannello: pannello, periodo e implementazione sono diversi. Mostra però che non si dovrebbe considerare l’affermazione automaticamente trasferibile tra pannelli senza calibrazione.
Alcune conclusioni dell’articolo coincidono con la mia replica, altre no
Un aspetto da riconoscere è che gli autori non equiparano la riduzione del rischio a un Alpha negoziabile. Dichiarano esplicitamente che SAE non aggiunge Sharpe, che l’identità dei fattori non è stabile tra seed casuali e che l’IC non migliora. Dichiarano anche che l’esecuzione allo stesso close non è praticabile, che i costi sono esclusi e che la selezione dell’universo non è point-in-time. Nella mia replica, la direzione di questi risultati negativi coincide con quanto riportato dagli autori. La separazione della sparsità, però, non si riproduce; l’overlay non può essere valutato in modo pulito perché i dettagli di costruzione non sono specificati.
- Nessuno Sharpe incrementale: il reversal naive ha uno Sharpe money di +1.69, contro +0.65 per SAE-64 e +0.96 per SAE-128. Anche la capacità predittiva non è migliorata: IC del reversal +0.0073 per SAE-64 contro +0.0146 per PCA-64 (l’articolo riporta +0.016 contro +0.021, stesso ordine).
- L’identità dei fattori non si riproduce tra seed: l’Hungarian matching di tre coppie di seed dà cosine del decoder tra 0.217 e 0.220, contro una reference di dizionario casuale pari a 0.198 (95° percentile 0.203). È appena sopra il caso — forse per una direzione di mercato condivisa — ma lontano da “lo stesso insieme di fattori”. L’articolo riporta 0.13 contro 0.117. Le magnitudini differiscono perché cambia il numero di asset e quindi la baseline casuale, ma la conclusione è la stessa.
- La separazione della sparsità non si riproduce: i valori Hoyer dell’articolo sono 0.497 per SAE contro 0.303 per DenseAE; i miei sono 0.479 contro 0.478. Il confronto mostra dove si trova la differenza: il lato SAE cambia pochissimo (0.497 contro 0.479); tutta la separazione mancante è sul lato della baseline densa (0.303 contro 0.478). Ho misurato anche il motivo: la quota di codici esattamente zero è 47.7% per SAE e 47.6% per DenseAE. In questo pannello, i codici ReLU sono già quasi per metà zero senza alcuna penalità. Il modello denso è “sparso” per costruzione e la differenza scompare. È l’altra faccia del risultato precedente: sul pannello degli autori la separazione c’è, sul mio no.
Non posso dare un verdetto netto sull’overlay, quindi registro i risultati così come sono. La versione preregistrata usava pesi di minima varianza Ledoit–Wolf per leg, covarianza dei rendimenti raw e scala money. Dopo l’overlay la volatilità è salita al 59.96% perché i pesi si sono concentrati troppo. Nella versione su scala rank, la volatilità è stata 8.19 (scala rank, non percentuale), inferiore alla naive a 8.97 e a entrambe le varianti SAE. L’articolo dice soltanto che una covarianza LW mobile a 60 giorni viene applicata al portafoglio naive per quintili, senza fissare i dettagli di costruzione. Non posso stabilire quale delle mie due implementazioni, se una, sia “la loro”. Ho scomposto la mia costruzione: ogni leg ha circa 28 asset e la mediana del numero di condizione della covarianza LW a 60 giorni è circa 94; la matrice non è mal condizionata. Il problema sono i pesi: la soluzione di minima varianza concentra ogni leg in circa sei posizioni effettive (mediana del peso massimo di un singolo asset: 27%). La volatilità del 59.96% è dovuta alla concentrazione dei pesi, non a una matrice singolare. Questo punto resta inconclusive: i dettagli della costruzione della mia replica non sono determinabili con quanto pubblicato.
Con un timing eseguibile, i rendimenti spariscono prima; la volatilità no
La sezione seguente non è nell’articolo. È una mia estensione e le sue conclusioni non vanno attribuite agli autori.
La valutazione dell’articolo forma il segnale alla chiusura del giorno t e lo esegue allo stesso prezzo di chiusura. Gli stessi autori dichiarano che non è eseguibile. Ho spostato gli stessi basket all’esecuzione alla chiusura del giorno successivo (il primo momento realmente eseguibile in questo schema) e ho aggiunto costi stilizzati di 10 / 25 bps in base al turnover. Il turnover giornaliero è circa 3.1 (somma delle variazioni assolute giornaliere dei pesi combinati delle due gambe; il massimo è 4, quindi il portafoglio viene quasi completamente sostituito ogni giorno).
| Metodo | Sharpe lordo stesso close | Lordo close successivo | Netto stesso close 10 bps | Netto close successivo 25 bps |
|---|---|---|---|---|
| SAE-128 | +0.98 | +0.05 | −2.98 | −10.07 |
| SAE-64 | +0.67 | +0.26 | −3.12 | −9.34 |
| Reversal naive | +1.71 | −0.10 | −1.86 | −9.62 |
Nota: Arm D è stato ricalcolato su 589 giorni usando i basket memorizzati (un giorno in meno rispetto all’aggregato dei cinque fold). Per questo lo Sharpe same-close differisce leggermente dalla tabella aggregata, ad esempio +0.98 contro +0.96 per SAE-128. La differenza deriva solo da quel giorno.
Ritardare l’esecuzione di un giorno porta lo Sharpe lordo di tutti e tre i metodi vicino a zero. Non sorprende: il reversal giornaliero guadagna nel primo giorno dopo la formazione del segnale. Aggiungendo 10 bps di costo, tutti i risultati diventano negativi; con 25 bps le perdite sono ampie. Serve una precisazione sulla convenzione di mercato: le crypto scambiano 24/7 e non hanno un’asta di chiusura. La “chiusura giornaliera” è solo uno snapshot in un momento specifico. Per questo la colonna same-close con costi è in realtà l’approssimazione più vicina a un’esecuzione praticabile (latenza e slippage reali andrebbero comunque sottratti). L’esecuzione al close successivo importa una convenzione conservativa dal mercato azionario: misura il limite superiore del gap di esecuzione, non il comportamento normale del mercato crypto. La volatilità cambia pochissimo tra varianti di timing e costi e resta tra 28 e 31%: i costi sono un freno graduale, mentre lo spostamento temporale elimina il premio del reversal stesso. Nessuno dei due cambia il livello di rischio.
Gli autori non hanno mai sostenuto che la strategia fosse negoziabile. Questa sezione quantifica la dimensione pratica del disclaimer che hanno scritto: tra “evidenza del segnale” e “conclusione negoziabile” c’è un intero insieme di ipotesi di esecuzione. Qualsiasi modello cross-sectional giornaliero che riporti Sharpe con esecuzione allo stesso close dovrebbe superare questo controllo prima di fare affermazioni più forti.
I controlli che eseguirò per primi quando valuto articoli ML sui fattori
Questa replica mi ha lasciato una checklist più duratura del risultato principale. Anche l’ordine ora è fisso:
- Controllo di identità dell’ablazione: spegnere il meccanismo dichiarato (qui λ=0) e confrontare pesi, statistiche del meccanismo (qui Hoyer) e metriche a valle. Se i due modelli sono indistinguibili, riportare prima “il meccanismo non si è attivato”, senza discutere subito la magnitudine dell’effetto. Se avessi fatto questo controllo per primo, avrei evitato una lunga deviazione.
- La baseline più semplice possibile: il reversal naive dello stesso giorno ha ottenuto lo Sharpe più alto o quasi più alto su entrambi i pannelli. Un modello complesso deve prima batterlo.
- L’overlay da manuale: se un overlay di covarianza può recuperare gran parte del vantaggio, il contributo incrementale del modello è solo il residuo. Questa volta non sono riuscito a riprodurlo in modo pulito, ma il controllo deve restare.
- Stabilità tra seed: riaddestrare con seed diversi, abbinare i fattori e confrontare con una reference casuale. Se il controllo fallisce, “abbiamo scoperto dei fattori” significa soltanto “questa esecuzione ha prodotto alcune direzioni”.
Torniamo allo 0.999998 iniziale. Probabilmente è il numero più informativo di questa replica. Le equazioni, i parametri e il protocollo di valutazione dell’articolo si possono copiare parola per parola. Che il meccanismo si attivi davvero non è scritto sulla pagina: va misurato sul proprio pannello. Che la volatilità scenda di un quarto o del 4.7%, finché la sparsità non è confermata sono solo numeri di un modello di ricostruzione.
Limiti della replica e materiali: le conclusioni qui valgono solo per l’universo ridotto (150 asset liquidi, 2022–2024, con survivorship tilt) e per la mia implementazione delle equazioni stampate (NumPy, gradienti verificati con differenze finite). Questo articolo non conferma né confuta i risultati degli autori sul loro pannello di 433 asset del 2019–2024. I dati sono candele giornaliere pubbliche di Binance e possono essere ricostruiti con le regole descritte. Al momento della stesura il codice ufficiale degli autori non era pubblicato. I valori dell’articolo sono identificati come riportati dagli autori. Questo articolo tratta solo metodi di replica e limiti delle evidenze; non è consulenza finanziaria.
Il codice di replica, la lista congelata degli asset (con hash), i risultati per fold e le note interpretative sono pubblici. Il pacchetto include SHA256SUMS per verificare ogni file singolarmente.
vxime/sae-crypto-factor-replication
Per inserire questa replica in un flusso di ricerca quantitativa più ampio, puoi leggere anche Come verificare se un fattore quantitativo è utile e Come regolare in sicurezza i pesi di un modello multi-fattore. Il primo verifica se l’evidenza di ranking regge; il secondo tratta il controllo delle modifiche ai pesi quando quell’evidenza entra in un modello.