114 esecuzioni nello stesso nanosecondo: dove sbaglia la verosimiglianza di Hawkes
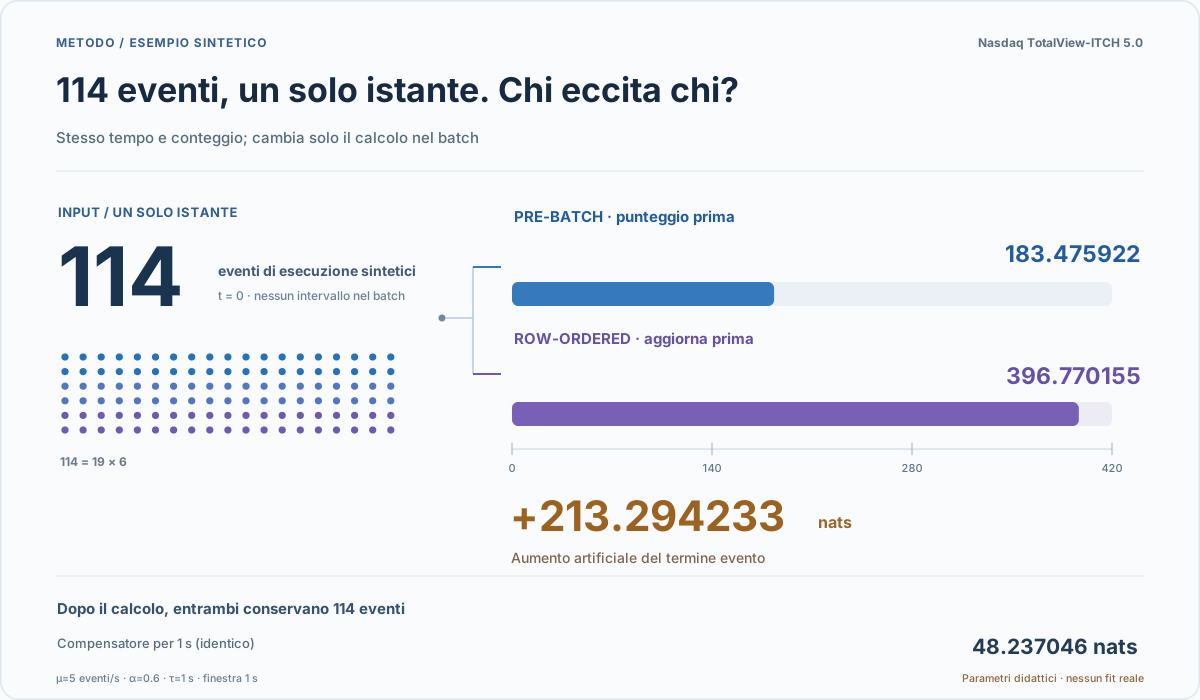
Mentre riordinavo un campione di eventi NASDAQ ITCH, ho trovato un numero che non potevo affidare senza pensarci a un normale ciclo Hawkes che aggiorna lo stato dopo ogni riga: 114.
Nella sessione ordinaria AAPL del 30 luglio 2019, una singola marca temporale al nanosecondo contiene 114 messaggi execution. Compaiono anche un batch da 131 e uno da 187 righe, una volta ciascuno. Più in generale, 30,080 dei 49,172 messaggi di esecuzione (61.17%) condividono il timestamp con altre righe. I pareggi temporali sono comuni; batch con centinaia di righe appartengono alla coda estrema.
Per «evento di esecuzione» intendiamo qui una riga di messaggi ITCH secondo la definizione dello studio, non 114 ordini diversi né la prova che 114 esecuzioni siano avvenute nello stesso istante fisico.
L’errore è aggiornare l’eccitazione riga per riga: anche se la differenza temporale registrata è zero, la riga 114 riceve l’eccitazione delle 113 righe precedenti. Con una matrice asimmetrica fra tipi, basta permutare le righe del file per alterare il punteggio. Quale ordine di precedenza può assumere un modello all’interno dello stesso timestamp?
Prima del fitting abbiamo fissato una convenzione: raggruppare per simbolo e nanosecondo intero; valutare tutti gli eventi usando la storia precedente al batch; solo dopo aggiornare la storia con le molteplicità effettive. L’ordine di invio dei messaggi della Borsa è informazione utile, ma senza un modello osservativo non è una misura del tempo fisico sotto il nanosecondo.
I timestamp coincidenti sono comuni; 114 righe sono un batch estremo
La specifica ufficiale Nasdaq TotalView-ITCH 5.0 definisce il timestamp come nanosecondi dalla mezzanotte. E è Order Executed e C Order Executed With Price; uno stesso riferimento d’ordine può comparire in più messaggi di esecuzione parziale.
Nel nostro studio le tre classi sono add=A/F, cancel_delete=X/D, execution=E/C. In C contiamo sia Printable=Y sia Printable=N; non sono soltanto scambi stampabili. P (Trade relativo a ordini non visualizzati) e Q (Cross Trade) restano fuori. È una classificazione scelta per il modello, non la tassonomia universale di tutte le negoziazioni Nasdaq.
Questa aggregazione interna riguarda AAPL il 2019-07-30, dalle 09:30 alle 16:00 ora di Borsa della costa orientale USA, ossia l’intera sessione regolare:
| Indicatore | Valore osservato |
|---|---|
Righe di messaggi execution | 49,172 |
| Timestamp distinti in nanosecondi | 29,379 |
| Timestamp con più righe | 10,287 |
| Righe che condividono il timestamp | 30,080 (61.17%) |
| Mediana / moda della dimensione dei batch con pari timestamp | 2 / 2 righe |
| Batch di 2–3 righe | 8,439 (82.04% dei batch con timestamp condiviso) |
| Batch con esattamente 114 righe | 1 |
| Batch più grandi da 131 e 187 righe | 1 ciascuno |
In precedenza avevamo confrontato più giorni nella finestra comune 09:30–11:00: non bisogna confonderne i numeri con quelli della sessione completa. L’istogramma conservato descrive la dimensione dei batch, non le identità di ogni ordine o un ordine fisico sotto il nanosecondo.
La media fra tutti i 29,379 timestamp è 1.67 righe per timestamp. Fra i 10,287 batch con almeno due righe la media è 2.92 e mediana e moda sono entrambe 2. Un batch da 114 è circa 39 volte quella media. Solo tre batch raggiungono almeno 114 righe: 114, 131 e 187. Sono ottimi test di stress, non il caso tipico.
Neppure la quota del 61.17% dimostra da sola che i parametri non siano identificabili: la regola pre-batch non utilizza intervalli intra-batch non osservati, mentre distanze e combinazioni di tipi tra batch contribuiscono ancora all’identificazione.
Allo stesso istante, chi può eccitare chi?
Per un Hawkes a tre tipi con kernel esponenziale, l’intensità condizionata è:
lambda_k(t-) = mu_k(t)
             + sum_j [alpha[k,j] / tau
               * sum_{u<t} m_j(u) * exp(-(t-u)/tau)]
k indica il tipo bersaglio, j il tipo sorgente; m_j(u) è il numero effettivo di messaggi sorgente al tempo u. La matrice ha orientamento bersaglio × sorgente. mu_k si misura in eventi/s, tau in secondi e alpha[k,j] è l’eccitazione integrata adimensionale per evento sorgente. Il coefficiente istantaneo è quindi alpha[k,j]/tau (1/s), mentre l’integrale nel tempo contiene alpha.
La condizione cruciale è u<t. Il batch corrente non deve entrare nella storia usata per valutarlo. Il suo termine di eventi è:
event_term(t) = sum_k m_k(t) * log(lambda_k(t-))Calcoliamo tutti i lambda_k(t-) dalla stessa storia passata, moltiplichiamo per i conteggi reali m_add, m_cancel_delete, m_execution, e solo dopo aggiorniamo lo stato una volta. Un batch da 114 non è un unico evento. I test sintetici controllano permutazioni delle righe, isolamento tra simboli e azzeramento della storia tra sessioni.
Valutare in ordine di trasmissione potrebbe essere un’altra scelta di modellazione, se si dichiara come l’ordine si traduca in tempi e intensità. Non è un’ottimizzazione innocua della stessa verosimiglianza.
Un esempio artificiale da 114 righe quantifica la differenza
Questo non è un fitting su AAPL: è un controesempio eseguibile con la sola libreria standard di Python. Supponiamo 114 eventi dello stesso tipo all’inizio della sessione, nessuna eccitazione precedente, mu=5 eventi/s, alpha=0.6, tau=1 s, seguiti da un secondo di osservazione.
import math

m, mu, alpha, tau, horizon = 114, 5.0, 0.6, 1.0, 1.0

# Valuta tutto il batch con l'intensità prima del batch
pre_batch = m * math.log(mu)

# Controesempio: righe precedenti nello stesso istante eccitano le seguenti
row_ordered = math.fsum(
    math.log(mu + alpha * i / tau) for i in range(m)
)

# La LL completa sottrae l'integrale su tutta la finestra
baseline_area = mu * horizon
excitation_area = alpha * m * (-math.expm1(-horizon / tau))
compensator = baseline_area + excitation_area

print(f"prebatch_event_log_term: {pre_batch:.6f}")
print(f"row_ordered_event_log_term: {row_ordered:.6f}")
print(f"artificial_excess: {row_ordered - pre_batch:.6f}")
print(f"one_second_compensator: {compensator:.6f}")
print(f"one_second_full_LL: {pre_batch - compensator:.6f}")
L’esecuzione reale in Python 3.13.5 su Linux isolato è terminata con codice 0:
prebatch_event_log_term: 183.475922
row_ordered_event_log_term: 396.770155
artificial_excess: 213.294233
one_second_compensator: 48.237046
one_second_full_LL: 135.238876
Consentire alle righe precedenti dello stesso istante registrato di eccitare le successive aumenta artificialmente il termine logaritmico degli eventi di 213.294233 nats. Eppure entrambe le convenzioni mantengono gli stessi 114 eventi nella storia dopo il batch. Poiché il batch ha durata zero, il compensatore del secondo successivo è identico: 48.237046 nats. Il punteggio LL completo è 348.533109 nel caso riga per riga, 135.238876 per pre-batch, sempre con 213.294233 nats di differenza.
Questa non è una migliore previsione di mercato né il confronto tra due verosimiglianze esatte dello stesso modello osservativo continuo. Pre-batch non cancella l’eccitazione futura: un secondo dopo, con questi parametri fittizi, i 114 eventi aggiungono 114 × 0.6 × exp(-1) ≈ 25.163 eventi/s all’intensità del proprio tipo.
Senza compensatore il termine di eventi non è la LL completa
Sommare log(lambda) nei tempi degli eventi e chiamare il totale «log-verosimiglianza» significa dimenticare l’intensità sostenuta anche quando non avvengono eventi. Va sottratto l’integrale di intensità su tutta la finestra valida di osservazione:
LL = sum_k sum_batches m_k(t) * log(lambda_k(t-))
     - sum_k integral_session lambda_k(t) dt
Prima della stima abbiamo fissato la baseline intraday in 78 intervalli di cinque minuti dalle 09:30 alle 16:00 (390 minuti). L’integrale di base usa l’intersezione esatta di intervalli semiaperti con la sessione; quello del kernel esponenziale usa la molteplicità effettiva di ciascun batch passato:
baseline_area[k] = sum_r mu[k,r] * overlap_seconds(r, session)

excitation_area[k] = sum_j sum_{u in session}
    alpha[k,j] * m_j(u) * (1 - exp(-(end-u)/tau))
Il calcolo adopera -expm1(-(end-u)/tau) per evitare cancellazioni numeriche con intervalli molto piccoli. Nell’esempio artificiale di un secondo l’area base è 5, l’eccitazione integrata circa 43.237046, e il compensatore totale 48.237046. La LL pre-batch completa è dunque 135.238876, non soltanto il termine eventi 183.475922.
Che cosa dice un istogramma reale con parametri ipotetici?
Il controesempio di 114 righe mostra il meccanismo. Abbiamo poi usato soltanto l’istogramma già salvato delle dimensioni dei batch execution AAPL del 2019-07-30, intera sessione regolare, come molteplicità per scenari con parametri artificiali. Non abbiamo riletto i messaggi ITCH grezzi né stimato parametri Hawkes reali.
Consideriamo esclusivamente l’autoeccitazione positiva del tipo execution. Se l’intensità prima del batch lambda^- è almeno una mu>0 scelta per lo scenario, l’incremento del punteggio introdotto dall’autoeccitazione interna riga per riga per un batch da m righe soddisfa:
0 <= Delta(m) = sum_{i=0}^{m-1} log(1 + alpha*i/(tau*lambda^-))
   <= sum_{i=0}^{m-1} log(1 + alpha*i/(tau*mu))
Il lato destro è un limite superiore condizionato per questa sola classe, non un limite sull’errore della LL Hawkes completa a tre tipi. Le intensità precedenti effettive e gli altri tipi simultanei non sono noti.
Con mu=5 eventi/s, usando le frequenze osservate nell’istogramma, i limiti complessivi risultano:
| alpha ipotetico | tau=0.1 s | tau=1 s | tau=10 s |
|---|---|---|---|
| 0.1 | 8,392.65 | 1,436.32 | 178.46 |
| 0.3 | 17,088.26 | 3,472.79 | 500.41 |
| 0.6 | 25,186.19 | 5,837.61 | 928.45 |
Tutti i valori sono in nats e alpha/tau sono ipotesi. Nello scenario centrale mu=5, alpha=0.3, tau=1 il limite cumulato è 3,472.79 nats, ossia 0.0706 nats per riga dopo la divisione per 49,172 righe. Un batch tipico da 2 o 3 righe ha limiti individuali di 0.0583 e 0.1716 nats. Cambiando il minimo ipotetico mu a 1 o 20, i limiti totali diventano 11,044.42 e 1,125.70 nats.
Fra le nove combinazioni il limite condizionato varia da 178.46 a 25,186.19 nats, cioè 0.00363–0.51221 nats/riga. Queste cifre non permettono di risalire all’errore di LL di AAPL né a parametri stimati sul mercato.
Escludendo i batch maggiori dallo scenario centrale:
| Batch maggiori esclusi | Riduzione del limite superiore (nats) | Quota del limite iniziale |
|---|---|---|
| 187 righe (top 1) | 321.54 | 9.26% |
| 187, 131, 114 righe (top 3) | 665.62 | 19.17% |
| Primi 10 batch | 1,123.57 | 32.35% |
I tre batch più grandi rappresentano soltanto 432 righe, ma quasi un quinto del limite di questo specifico scenario ipotetico. Nell’istogramma archiviato non restano gli orari intraday dei batch estremi: non possiamo attribuirli all’apertura, alla chiusura, al matching o alla codifica dei timestamp.
Per l’istogramma e questa analisi ipotetica sono passati 13/13 test distinti, separati dai 99 test sintetici della parte di ricerca.
Che cosa hanno verificato davvero i 99 test?
L’aggregazione reale di AAPL prova l’esistenza e le dimensioni dei batch con lo stesso timestamp. I test sintetici a parametri noti verificano invece che punteggi, compensatori e aggiornamenti seguano la convenzione matematica. Non vanno confusi.
| Gruppo di test sintetici | Cosa è stato verificato |
|---|---|
| Punteggio a batch (10) | Intensità comune prima del batch, molteplicità preservata, invarianza all’ordine delle righe |
| Verosimiglianza completa (33) | Compensatori di base e kernel, integrazione analitica e numerica |
| Contratti M0/M1/M2 (34) | Poisson omogeneo, NHPP stagionale con 78 intervalli, Hawkes a tre tipi con parametri noti |
| Eventi sintetici (22) | Ogata thinning con seme fisso, somme storiche indipendenti, determinismo tra processi |
| Totale | 99/99 test di ricerca superati (Python 3.13.5, Linux x86_64 isolato) |
Un fixture di stress costruito apposta comprende 209 eventi sintetici in quattro gruppi temporali: 90 Add all’inizio, 114 Execution a +1 s, 3 Cancel/Delete a +2 s, poi 1 Add e 1 Execution insieme a +3 s. Le dimensioni sono 90/114/3/2. Il massimo scarto assoluto rispetto a una seconda implementazione indipendente di somma storica e integrazione è stato circa 1.42e-14; invertire le righe in ingresso non ha cambiato il punteggio.
Due ulteriori flussi sintetici a tempo continuo, generati con Ogata thinning, contenevano 285 e 265 eventi. La differenza massima con il calcolo indipendente della LL è stata circa 7.11e-15. Questi flussi non hanno prodotto naturalmente 114 eventi esattamente coincidenti; il batch grande è un input di stress deliberato.
I 99 test sono stati eseguiti in passato su Python 3.13.5 e Linux x86_64 isolato. Non sono un PASS di GitHub Actions sul HEAD editoriale attuale. Non abbiamo ancora un fit di mercato, un test fuori campione o evidenza di superiorità di Hawkes rispetto al NHPP stagionale.
Il limite della verosimiglianza di lavoro pre-batch
In un processo puntuale continuo semplice, arrivi perfettamente simultanei hanno normalmente probabilità zero. Il timestamp ITCH è un valore osservato/codificato in nanosecondi; l’ordine di trasmissione non rivela gli istanti fisici più fini. La nostra verosimiglianza di lavoro pre-batch (o punteggio di pseudo-verosimiglianza) è quindi una convenzione esplicita, non una densità congiunta esatta derivata per timestamp quantizzati. Senza definirne densità componenti e dipendenze non è nemmeno corretto chiamarla composite likelihood.
Se interessano conteggi in intervalli fissi, si può studiare un modello discreto di conteggi. Se si vogliono inferire gli arrivi latenti dentro l’intervallo, serve un modello per dati censurati per intervallo. Cambiare l’ordine dei piccoli batch è un’analisi di sensibilità, non una sostituzione universale.
Se due modelli valutano gli stessi dati, con gli stessi gruppi e lo stesso modello osservativo e omettono la medesima costante C(D) indipendente dai parametri, allora (LL_A+C(D))-(LL_B+C(D))=LL_A-LL_B: la costante si annulla nella differenza. In certi modelli discreti il termine -sum log(m!) può avere questa proprietà. Non significa che il valore assoluto della LL sia invariato né che aggiungere un fattoriale renda esatta la pseudo-verosimiglianza. Cambiando raggruppamento o convenzione temporale non è garantito che la costante sia comune.
Anche un test classico del rapporto di verosimiglianze basato su chi-quadrato non è automaticamente valido: i parametri di eccitazione non negativi sono sul bordo e quelli di decadimento possono non essere identificabili sotto l’ipotesi nulla.
Come controllare i residui con timestamp identici
Trattare 114 messaggi con lo stesso timestamp come 114 arrivi ordinati crea molti intervalli nulli e distorce i controlli del riscalamento temporale. Il piano prestabilito forma i residui su timestamp unici per tipo di evento, riportando a parte la molteplicità del batch. Grafici QQ, autocorrelazione e distanza KS descrivono lo scostamento; i normali p-value KS basati su arrivi continui senza pareggi non sono inferenza formale in questo contesto. Un eventuale bootstrap o test di permutazione dovrà specificare prima ipotesi nulla, generatore e unità di ricampionamento che rispetti la dipendenza nei batch.
Il primo controllo è evitare che l’ordine delle righe nel file diventi di nascosto il tempo causale del modello.
Materiali pubblici per riprodurre: Script Python, istogramma, test e checksum SHA-256.