Esposizione dei dati della KV Cache tra richieste, secondo Cloudflare: perché SGLang ha inoltrato una richiesta rifiutata all'handoff?
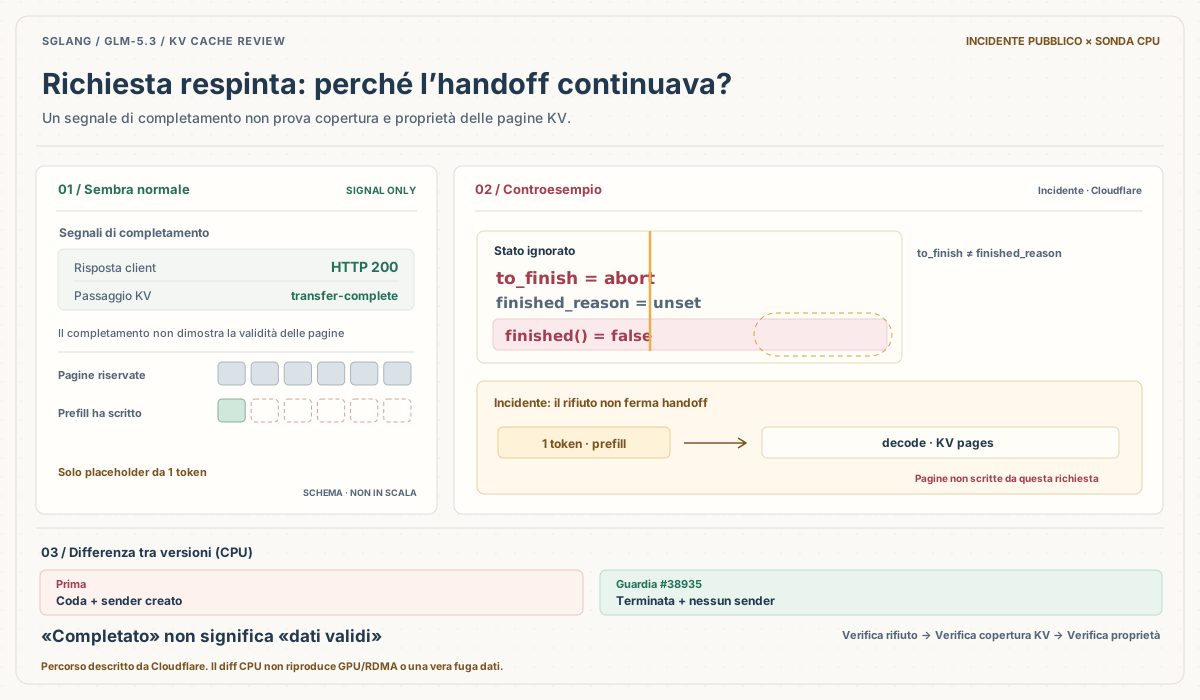
Nell’ottobre 2026 Cloudflare ha divulgato un’esposizione della KV cache tra richieste su GLM-5.3 in Workers AI. Secondo il rapporto, l’incidente si è verificato dal 27 agosto al 9 settembre: sono state coinvolte 155 risposte e tutti i prompt interessati superavano 681,280 token. Il rapporto non indica il numero totale di richieste nello stesso periodo, quindi non è possibile calcolare una percentuale di impatto sulla base dei dati pubblicati. Rapporto dell’incidente Cloudflare · Divulgazione coordinata SGLang.
Prima una conclusione per chi non gestisce un cluster di inferenza: non è un rischio generalizzato per tutte le API di IA. Cloudflare ha dichiarato che gli altri modelli Workers AI non erano coinvolti e che GLM-5.3 è stato corretto e ripristinato il 9 settembre. L’ambito esplicitamente indicato riguarda le richieste GLM-5.3 con input superiori a 681,280 token durante la finestra dell’incidente. Se usi soltanto un’API, verifica prima se il tuo caso rientra in questo scenario. Se gestisci un cluster SGLang con prefill e decode separati, puoi passare direttamente alle quattro verifiche di accettazione alla fine.
La domanda utile non è la generica «come può un modello esporre dati?», ma un confine di stato più preciso: perché una richiesta già destinata al rifiuto poteva entrare nell’handoff prefill/decode con un placeholder di un solo token? La richiesta era stata rifiutata, ma l’elaborazione proseguiva: è questo il punto anomalo. Si sono combinati due problemi: il limite di context dichiarato era superiore alla lunghezza che il KV pool reale poteva contenere e, nel punto d’ingresso della inferenza disaggregata dell’epoca, lo stato di rifiuto non terminava la richiesta abbastanza presto. Il primo problema attivava il rifiuto; il secondo lasciava proseguire la richiesta rifiutata lungo un percorso che non avrebbe dovuto seguire.
I sette passaggi del percorso di produzione descritti da Cloudflare (la PR #36988 era già stata unita il 6 settembre, ma non era ancora arrivata in produzione Cloudflare quando il 9 settembre è stata distribuita la correzione dell’engine): ① Bootstrap: il router comunica a decode la lunghezza originale del prompt e decode prenota le pagine KV corrispondenti. ② Prefill admission: admission controlla req.finished(), ma la causa del rifiuto era registrata in to_finish, non in finished_reason; perciò la richiesta poteva sembrare ancora non terminata ed essere ammessa. ③ Prefill forward: l’input di prefill viene sostituito con un placeholder da 1 token. ④ KV transfer: prefill invia soltanto la pagina KV corrispondente al placeholder, ma emette il segnale transfer-complete. ⑤ Decode admission: anche il controllo dello stato finale sul lato decode accetta l’handoff. ⑥ Decode attention: decode legge le pagine KV fino alla lunghezza prenotata, sebbene soltanto la prima sia stata scritta dalla richiesta corrente; le altre possono contenere dati lasciati da una richiesta precedente. ⑦ Response: Cloudflare ha riferito che il client ha ricevuto HTTP 200 anziché l’HTTP 400 atteso e che la risposta conteneva dati della sessione di un altro utente. Il rapporto Cloudflare descrive la sequenza passo per passo. SGLang issue #30233 e PR #38935 permettono di confrontare il problema di stato e la correzione dell’admission.
Preso singolarmente, ogni passaggio sembra funzionare normalmente. È l’insieme a rivelare il problema: il rifiuto non diventava effettivo in tempo, mentre le fasi successive continuavano a trattare la richiesta come una richiesta normale.
681,280 e 1,048,576 rappresentano capacità diverse
Nella configurazione descritta da Cloudflare, la lunghezza di context del modello era impostata a 1,048,576 token, mentre la capacità del KV pool sulla GPU di prefill al momento dell’incidente era di 681,280 token. In seguito Cloudflare ha portato il pool a circa 2.04 milioni di token e aggiunto una protezione di rifiuto a livello di engine. Dettagli sulla capacità e sulle correzioni Cloudflare.
Nel medesimo rapporto, il valore 681,280 indica due cose diverse: la soglia di lunghezza del prompt delle richieste coinvolte e la capacità del KV pool sulla GPU di prefill in quel momento. Il numero coincide, ma il ruolo no. Il primo descrive quali richieste sono state coinvolte; il secondo quanto poteva effettivamente contenere il worker in esecuzione.
Sono due limiti distinti. La context length è il limite configurato entro cui può arrivare una richiesta; il KV pool è il pool di memoria che in esecuzione può realmente allocare e conservare lo stato key/value dei token. Aumentare la context configurata non espande automaticamente il KV pool alla stessa capacità. Una richiesta può quindi rimanere sotto il limite di context dichiarato e superare comunque lo stato KV che il worker attuale è in grado di mantenere.
Un pool insufficiente dovrebbe causare il rifiuto. Il problema reale era che lo stato di rifiuto non fermava l’handoff successivo. Sia la divulgazione Cloudflare sia il codice upstream indicano una lacuna nella propagazione dello stato abort nel percorso di inferenza disaggregata.
Registrare il motivo del rifiuto non significa che admission abbia terminato la richiesta
Nel percorso SGLang interessato, Req.set_finish_with_abort() registra il motivo del rifiuto in to_finish e contemporaneamente sostituisce il prompt in ingresso con un placeholder da 1 token. Tuttavia, il controllo finished() dell’epoca leggeva finished_reason. In altre parole, il motivo del rifiuto era presente nell’oggetto richiesta, ma il controllo usato per stabilire se «la richiesta è terminata» poteva ancora trattarla come una richiesta normalmente schedulabile. Vedi la spiegazione della causa radice nella SGLang PR #38935.
La discrepanza di stato è più facile da verificare direttamente nel sorgente. Questi sono estratti non consecutivi dal commit fissato; le righe omesse sono indicate. Il contesto completo è disponibile in set_finish_with_abort() (L2053–2072), finished() (L1479–1481) e update_finish_state() (L1842–1848):
# Req.set_finish_with_abort() — excerpt
self.origin_input_ids = array(
    "q", [0]
)  # set it to one token to skip the long prefill
# ... omitted ...
self.to_finish = FINISH_ABORT(error_msg, status_code, err_type)

# Req.finished()
return self.finished_reason is not None

# Req.update_finish_state()
if self.to_finish:
    self.finished_reason = self.to_finish
    self.to_finish = None
Questo non significa che to_finish non venga mai applicato: in seguito update_finish_state() lo trasferisce in finished_reason. Il problema è che admission controlla finished() prima che avvenga questa transizione.
Prima che Cloudflare distribuisse la correzione dell’engine il 9 settembre, questa discrepanza di stato poteva propagarsi attraverso il flusso prefill/decode separato. Admission considerava la richiesta ammissibile; decode prenotava un numero sufficiente di pagine KV; prefill elaborava però soltanto il placeholder da 1 token e generava e trasferiva uno stato KV insufficiente. Di conseguenza, decode poteva leggere pagine che la richiesta corrente non aveva sovrascritto. Cloudflare ha attribuito l’esposizione effettiva ai dati KV lasciati dalle richieste precedenti. Rapporto Cloudflare · Issue upstream correlata #30233.
Qui è facile confondere tre segnali di «completamento»:
- HTTP 200 indica che il client ha ricevuto uno stato HTTP positivo. Non dimostra che il significato della risposta sia corretto, né che le pagine KV appartengano alla richiesta corrente.
- Prefill completion / transfer-complete indica che una fase di elaborazione o di handoff ha emesso un segnale di completamento. Non garantisce automaticamente che il numero di token trasferiti copra tutte le pagine prenotate da decode.
- Decode che legge pagine KV complete e valide è un controllo più vicino alla condizione dei dati che conta. Se si verifica soltanto che il flusso è terminato, senza controllare l’intervallo realmente scritto e la proprietà delle pagine, si può confondere «il trasferimento è finito» con «i dati sono completi e appartengono alla richiesta corrente».
Un flusso completato non significa che i dati siano corretti.
#36988, #38935 e #38704 non erano la stessa correzione
La sequenza temporale e il ruolo di ciascun record upstream sono importanti.
| Data / record | Stato | Che cosa ha risolto davvero |
|---|---|---|
| 2026-07-06, issue #30233 | Chiuso | Segnalazione precedente di un problema simile in PD disaggregation, in cui un prompt lungo trasferiva soltanto 1 token. Non è una riproduzione indipendente dell’intero incidente di produzione Cloudflare. |
| 2026-09-06, PR #36988 | Unita; Cloudflare l’ha associata alla release v0.5.20 | Corregge la terminazione e la pulizia dei risultati di prefill abortiti: cancella lo stato dei chunk in attesa, non reinserisce i risultati abortiti nella coda delle richieste incomplete, libera risorse come metadata/KV/HiCache/Mamba e ignora i risultati tardivi delle richieste già ritirate. Risolve un difetto di correttezza. |
| 2026-09-16, PR #38935 | Unita; Cloudflare l’ha associata alla release v0.5.21 | Termina prima, agli ingressi admission di prefill e decode, le richieste rifiutate che non sono ancora entrate, evitando bootstrap, metadata buffer, inizializzazione sender/receiver e forward pass inutili. L’autore ha chiarito che riduce spreco di risorse e latenza, non che sia una seconda correzione indipendente di correctness dopo #36988. |
| Creata il 2026-09-09, chiusa il 2026-10-10, PR #38704 | Chiusa, non unita; nessuna release | Un’altra protezione proposta da Cloudflare. Non va descritta come una correzione entrata nella linea principale upstream. |
La descrizione di #38935 fornisce un riferimento temporale importante: su un main che includeva #36988, decode non inviava più l’handoff insufficiente. La PR upstream mostra anche un confronto prima/dopo 1P1D (2×H200): dopo l’unione di #38935, decode passava da un timeout dopo 300 secondi a una risposta immediata 400; bootstrap e metadata buffer non venivano più creati e lo stub batch passava da 1 a 0. È un confronto pubblicato da upstream, non un test prestazionale eseguito per questo articolo.
Per questo la guardia d’ingresso non può essere semplificata in «se to_finish non è vuoto, termina la richiesta». #38935 usa is_unadmitted_reject per identificare una richiesta rifiutata che non è ancora entrata né ha acquisito responsabilità sulle risorse. Una richiesta rientrante o preempted potrebbe già detenere risorse KV o metadata; non va eliminata in anticipo solo perché presenta un marcatore abort. Anche decode deve considerare il percorso di rientro, perché parte dello stato delle risorse potrebbe non rimanere nell’oggetto Req. Una terminazione troppo precoce potrebbe saltare la pulizia affidata al normale percorso di scheduling, ad esempio l’active slot detach di una streaming session (rilascio dello slot attivo occupato dalla sessione). SGLang PR #38935.
In seguito sono state aggiunte altre difese correlate ma rivolte a problemi diversi. PR #39500 ha introdotto un checksum KV opzionale per l’handoff. Cloudflare ha descritto anche KV canary, che rileva e registra possibili corruzioni, e read-time page tagging. Quest’ultimo era un prototipo testato nell’estate 2026, provato su GLM-5.2 e poi disattivato per problemi di affidabilità; dipende da specifici attention backend e architetture di modello, quindi non è una difesa universale attualmente distribuita. Cloudflare ha spiegato che checksum e canary non coprivano ancora tutte le architetture, e il supporto a GLM-5.3 era in espansione. Il checksum dell’handoff verifica il trasferimento da prefill a decode, non ogni successiva lettura di decode.
PR #40645 e PR #41402 correggono insieme conferme drain perse o la mancata copertura di tutti i decode peer. PR #41404 estende il deferred release anche ad altri transfer failure, non soltanto agli abort avviati da decode, per evitare che le pagine vengano liberate o riutilizzate mentre scritture RDMA in corso potrebbero ancora toccarle. Queste correzioni riguardano le race sul ciclo di vita delle pagine KV e rappresentano un percorso di errore distinto dall’handoff insufficiente deterministico di una richiesta rifiutata. Difese e versioni descritte da Cloudflare.
Validazione CPU con versione fissata: percorsi di codice verificati, nessuna fuga tra tenant riprodotta
La verifica non si è limitata a leggere il rapporto e le PR. È stata divisa in tre livelli, ciascuno con un ambito probatorio diverso.
| Evidenza | Risultato osservato | Che cosa supporta |
|---|---|---|
| Macchine a stati sintetiche in Python, costruite ad hoc | Modello handoff 6/6; modello admission / re-entry 9/9 | Le guardie nei modelli semplificati costruiti si comportano come previsto; non dimostra il comportamento runtime di SGLang. |
| Test unitari CPU upstream di SGLang con commit fissato (P1) | 19 passed complessivi su due file; il test admission include anche 12 subtests | È stato eseguito codice upstream reale di mixin, queue e retire nella versione fissata. Alcuni collaboratori di transport/cache/scheduler erano ancora Mock. Non è stato avviato un vero cluster prefill/decode. |
| Differenze prima/dopo (P2) | Osservati cambiamenti sia nella differenza admission di #38935 sia nella pulizia prefill di #36988 | Gli input fissati hanno seguito percorsi di codice diversi nelle due versioni. I risultati sono limitati al codice CPU e al comportamento delle sonde. |
P1 è fissato al commit SGLang 8f3d6944b76c428d884582cb6c82a39db1465360 (sorgente fissato). Sono stati eseguiti i test upstream test_prefill_abort_result_cleanup.py (11 passed) e test_admission_abort_not_enqueued.py (8 passed, più 12 subtests), per un totale di 19 passed. L’ambiente era una VM Linux solo CPU con Python 3.12.3, pytest 9.2.0 e torch per CPU. Non sono stati usati GPU, pesi del modello, RDMA o dati dei tenant.
P2 ha isolato le versioni precedenti e successive di ogni PR per evitare di mescolare più correzioni nello stesso confronto:
- Esperimento A: ingresso admission di #38935 (base 17ba2c2e → head 8f3d6944). Prima della correzione, le richieste rifiutate all’ingresso entravano comunque in coda e provocavano la creazione di sender/receiver. Dopo, venivano terminate all’ingresso senza creare quegli oggetti di handoff. Le richieste valide e quelle rientranti con metadata buffer sono state mantenute in entrambi gli alberi; non è stato osservato un loro ritiro errato.
- Esperimento B: pulizia dei risultati prefill di #36988 (base 9c254df8 → head 2ee5742a). La sonda ha osservato che prima della correzione il risultato finale di un abort poteva essere trattato come cache incompleta e reinserito nella coda inflight; un risultato tardivo di una richiesta già ritirata poteva ancora inviare un KV chunk. Dopo la correzione, la pulizia è terminata come previsto e i risultati tardivi non hanno più prodotto questi effetti collaterali.
Il 7/7 di P2 e gli 11 passed di P1 provengono da versioni differenti. P2 usa i sette casi presenti all’head #36988 2ee5742a. Nella versione fissata 8f3d6944 di P1 sono stati aggiunti in seguito test parametrizzati sampling-mask, portando quel file a undici casi. Quindi 0/7 → 7/7 confronta gli stessi sette casi prima e dopo la correzione e non va sommato agli undici passed di P1. I sette errori pre-fix di P2 erano sei eccezioni AttributeError e una ValueError, causate dal passaggio del codice nel percorso transfer normale che lo stub di test non modellava. Non erano sette assertion funzionali fallite. Le evidenze più significative sono gli effetti osservati di reinserimento in coda, pulizia e invio ritardato.
Evidenze pubbliche per la verifica
Ho pubblicato le due probe differenziali, quattro output JSON originali, la ricevuta P2 e l’elenco dei checksum SHA-256 nel pacchetto pubblico delle evidenze. Sono fissate entrambe le coppie di commit base/head e sono documentati i limiti dei collaboratori Mock e dell’ambiente solo CPU. Lo 0/7 pre-fix deriva dallo stub fall-through (sei AttributeError e un ValueError), non da sette assertion fallite. Questi artefatti mostrano differenze osservate nei percorsi di codice tra versioni fissate; non riproducono una fuga reale tra tenant né un problema GPU/RDMA.
Quattro verifiche da eseguire in produzione
Se gestisci inferenza multi-tenant o un’architettura SGLang con prefill/decode separati, viene spontaneo pensare: «Aggiorno a v0.5.22, invio un prompt lungo, vedo HTTP 400 e ho finito». Non basta. Configurazione e ciclo di vita delle risorse hanno percorsi che il solo numero di versione non copre. Separerei l’accettazione in quattro gate indipendenti:
- Pool / context gate: configurazione e capacità runtime coincidono? Dopo l’avvio del worker, confronta la capacità KV pool realmente stampata nei log di avvio con la configurazione context. Ricontrolla i log dopo modifiche a configurazione, partizione GPU o concorrenza. Includi un caso negativo in cui l’input non supera il limite context ma supera la capacità del KV pool corrente, e verifica che il sistema lo rifiuti esplicitamente anziché continuare l’handoff.
- Reject / admission gate: il rifiuto diventa effettivo all’ingresso? Verifica che una richiesta rifiutata venga terminata prima di bootstrap, queue admission, allocazione del metadata buffer e inizializzazione sender/receiver. Non testare solo richieste nuove: includi richieste valide, rientro, preemption e richieste che detengono ancora risorse KV, Mamba o metadata. Non scartare tutte le richieste con stato abort, altrimenti potresti violare la responsabilità di cleanup delle risorse.
- Transfer / read gate: l’intervallo trasferito copre quello letto? Confronta il numero di token/pagine prenotati con l’intervallo valido realmente scritto e trasferito. HTTP 200 e transfer-complete non sostituiscono i controlli di lunghezza e proprietà. Prima di usare
—disaggregation-enable-kv-checksumo—kv-canary, verifica che il modello e il backend correnti siano supportati e controlla nei log che la validazione sia stata davvero eseguita. Quando Cloudflare ha divulgato l’incidente, questi meccanismi non coprivano tutte le architetture, inclusa GLM-5.3. Un’opzione non supportata non conta come difesa efficace; il checksum handoff non verifica ogni lettura decode. - Lifetime / ownership gate: dopo un errore, quando si possono liberare o riutilizzare le pagine? Aggiungi test negativi per abort, risultati tardivi e scritture RDMA in corso. Assicurati che scritture non concluse non contaminino pagine riassegnate, che i risultati tardivi di richieste ritirate non inviino altri chunk e che ogni risorsa venga liberata una sola volta. Verifica che deferred KV release sia attivo sia su prefill sia su decode. Per Mooncake, controlla anche che il limite del transfer batch e il release timeout siano compatibili, per evitare una coda lunga di scritture in corso dopo un timeout. Le versioni che includono PR #41023 attivano deferred release per impostazione predefinita nei backend supportati, ma fanno fede versione e configurazione effettivamente in esecuzione. #40645 e #41402 riguardano le conferme drain; #41404 la release differita per altri transfer failure. Questi rischi del ciclo di vita vanno verificati separatamente dal difetto originale di handoff deterministico.
SGLang v0.5.22 è stato pubblicato il 19 ottobre 2026. Cloudflare ha consigliato v0.5.22 o successivo, oppure il backport delle correzioni pertinenti quando necessario. Ma «versione aggiornata» non significa «deploy che ha superato la verifica d’isolamento». Bisogna controllare la versione realmente in esecuzione, la configurazione pool/context, i casi negativi admission e il ciclo di vita delle pagine. Se checksum o altre funzioni non sono attivi, non vanno conteggiati come difese operative.
La lezione non è che un singolo booleano fosse sbagliato. Stato di rifiuto, integrità dei dati e proprietà delle risorse sono confini diversi. Un motivo di rifiuto registrato nell’oggetto richiesta non garantisce che admission lo riconosca; un transfer completato non significa che ogni pagina letta da decode sia stata scritta dalla richiesta corrente; l’emissione di abort non significa che tutte le scritture in corso siano terminate. Verificare separatamente ogni confine evita di scambiare un percorso di richiesta dall’aspetto riuscito per una prova di reale isolamento dei dati.
Data dei test: 28 ottobre 2026.
SGLang: percorso dell'incidente in sette passaggi
Esamina come una richiesta rifiutata attraversò admission, trasferimento KV e decode. È una guida alla divulgazione Cloudflare, non un'esecuzione di SGLang nel browser.
Tutti i sette passaggi restano leggibili senza JavaScript.
- Incidente divulgato da Cloudflare
1. Bootstrap: prenotare pagine KV
Il router comunica a decode la lunghezza del prompt; decode prenota le pagine KV.
La prenotazione segue il prompt; non prova che il trasferimento copra tutta la lunghezza.
- Differenziale CPU su sorgente fissata
2. Prefill admission: il rifiuto non ha bloccato l'ammissione
Il controllo leggeva finished_reason, ma il rifiuto era in to_finish; il vecchio percorso poteva considerare la richiesta non terminata.
Nel differenziale CPU la richiesta rifiutata entrava in coda e creava sender prima della correzione; la versione corretta la ritirava in admission.
Sorgente fissata · 8f3d6944b76c · L1479-L1481Prove locali: probe-admission-pre-20261028.jsonProve locali: probe-admission-post-20261028.json
- Incidente divulgato da Cloudflare
3. Prefill forward: l'input diventa un token
Per saltare un prefill lungo, l'input è stato sostituito da un placeholder di un token; non dimostrava che lo stato KV originale fosse completo.
Il placeholder è un segnale di controllo, non una prova di contenuto KV completo.
- Incidente divulgato da Cloudflare
4. KV transfer: una pagina e segnale di completamento
Prefill inviò solo la pagina KV del placeholder ma segnalò il completamento; il segnale non verificava la copertura.
Questo passaggio proviene da Cloudflare; GPU/RDMA non è stato riprodotto indipendentemente.
Sorgente fissata · 8f3d6944b76c · L2053-L2072Prove locali: sglang-cpu-p2-receipt.json
- Differenziale CPU su sorgente fissata
5. Decode admission: lo stesso controllo la ammette di nuovo
Anche decode accettò l'handoff; il differenziale CPU mostra un receiver nella versione vecchia e il ritiro all'ingresso in quella corretta.
Il differenziale CPU mostra un receiver nella versione vecchia e il ritiro in admission in quella corretta.
Sorgente fissata · 8f3d6944b76c · L1479-L1481Prove locali: probe-admission-pre-20261028.jsonProve locali: probe-admission-post-20261028.json
- Incidente divulgato da Cloudflare
6. Decode attention: lettura oltre le scritture valide
Decode leggeva fino alla lunghezza prenotata, ma solo la prima pagina era stata scritta dalla richiesta corrente.
Percorso divulgato; i differenziali CPU verificano abort, coda e pulizia, non GPU attention.
Sorgente fissata · 8f3d6944b76c · L1479-L1481Prove locali: probe-prefill-pre-20261028.jsonProve locali: probe-prefill-post-20261028.json
- Incidente divulgato da Cloudflare
7. Response: HTTP 200 non significa dati corretti
Cloudflare ha riferito HTTP 200 invece dell'HTTP 400 previsto, con contenuti di un'altra sessione.
Questo esito proviene dal fornitore; non è stata riprodotta una risposta reale tra tenant.
Sorgente fissata · 8f3d6944b76c · L1479-L1481Prove locali: sglang-cpu-p2-receipt.json