Serve una memoria separata all'Agent se il contesto ingegneristico è già in GitHub?
I primi due articoli della serie hanno trattato i passaggi GitHub-first tra strumenti e i confini tra Local-first e GitHub-first. Resta una domanda: se il contesto ingegneristico è già nel repository, cosa aggiunge una memoria separata per l’Agent?
La risposta breve è: non aggiungere un livello di memoria solo perché speri di scrivere codice più in fretta. Se l’Agent può dedurre una regola da README, AGENTS.md, Makefile e test, lasciala lì. La memoria indipendente merita di essere valutata per decisioni storiche che il repository attuale non spiega più. In questi tre cicli, il recupero tra Harness è avvenuto davvero, ma il risultato della verifica indipendente del task consumer non è migliorato.
Se il repository conosce già la risposta, non attribuirla alla memoria
Il primo ciclo ha usato Beacon 1.3.46 (build f8177a68) e Codex CLI 0.162.1 su macOS arm64 con endpoint Local. Il progetto sintetico includeva una definizione API, un README che indicava il codice generato come già versionato, un target Makefile e test di coerenza.
All’inizio sembrava che il controllo A0 senza memoria fallisse mentre il percorso Beacon superava 3/3 test. La revisione successiva ha trovato due fattori confondenti: A0 era in una sandbox di sola lettura e non poteva modificare file; inoltre l’errore del primo ciclo rivelava make gen. Non era un controllo valido e non era una prova dell’effetto della memoria.
Nel secondo ciclo la sandbox era scrivibile e l’indizio rimosso. A0 senza memoria ha letto README, Makefile e test, dedotto la regola di generazione e superato 1/1 test. Ho cancellato l’affermazione secondo cui la memoria avrebbe causato il riuso della regola. Se il repository contiene già la risposta, attribuirne il merito a Memory è solo marketing.
| Esperimento | Risultato osservato | Conclusione consentita |
|---|---|---|
| Ciclo 1: A0 / Beacon | A0 non valido; il candidato Beacon approvato è diventato uno Skill e letto in una nuova sessione, poi 3/3 test superati | Non si può inferire un beneficio causale della memoria |
| Ciclo 2: A0 senza memoria | Regola dedotta dal repository; 1/1 test superato | Per questo task bastavano le informazioni del repository |
| Checkpoint manuale | Letto CHECKPOINT.md; 2/2 test superati | Anche un passaggio esplicito e versionato funziona; nessun confronto equo dei tempi |
| Training ciclo 3 | Test pubblici TSV 3/3 PASS e controllo nascosto del controller PASS | Non dimostra distillazione automatica o riuso cross-Harness |
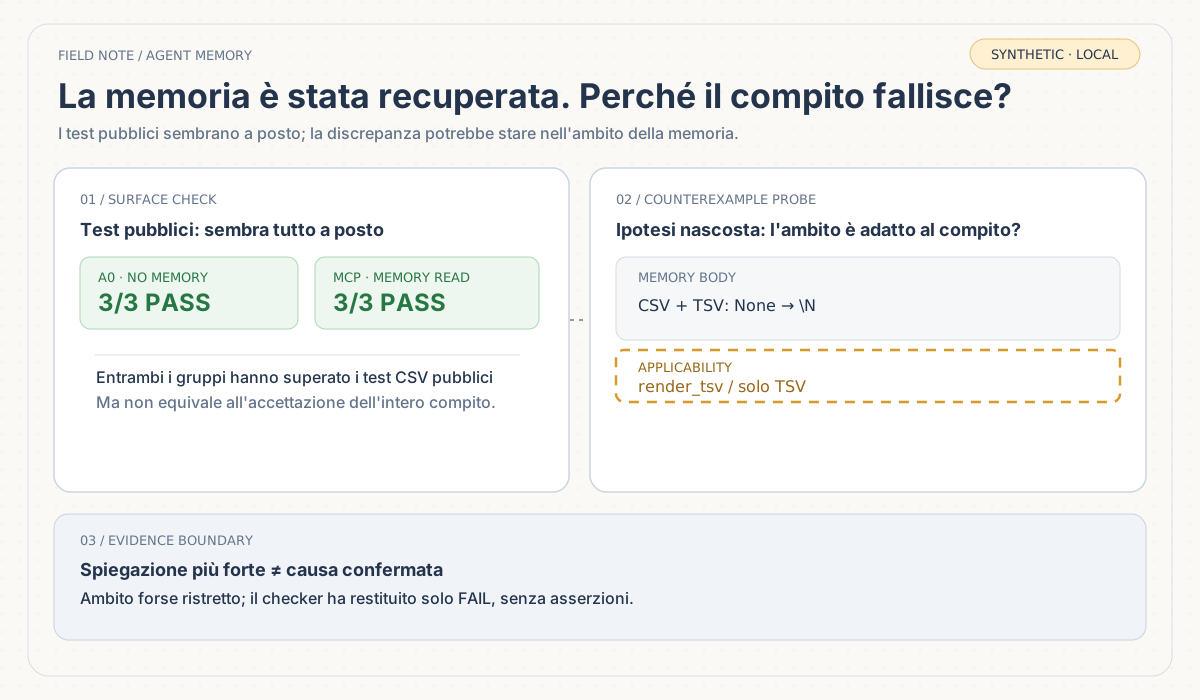
| Consumer ciclo 3 | A0 e MCP di Antigravity: test CSV 3/3 PASS, controlli nascosti entrambi FAIL | Il recupero è avvenuto; il miglioramento del task non è provato |
Ogni ciclo ha usato un fixture sintetico diverso. I valori 1/1, 2/2, 3/3 e 4/4 non formano una singola suite cumulativa.
Checkpoint e Agent Memory hanno ruoli diversi
Non ho misurato tempo e token di Checkpoint manuale e Beacon con lo stesso metodo, e le procedure di correzione erano diverse. Inventare a posteriori numeri comparabili sarebbe falsa precisione.
La differenza ingegneristica è chiara: Checkpoint è un passaggio visibile, versionato con Git e revisionabile; Agent Memory assomiglia a un quaderno che accumula esperienza automaticamente. Il quaderno può conservare il motivo di una decisione, ma anche una decisione ormai superata.
| Conoscenza | Dove metterla prima | Memoria separata? |
|---|---|---|
| Vincoli attuali, passi di build e invarianti | README, AGENTS.md, Makefile, test | Di solito no; il repository resta la fonte autorevole |
| Stato del task, SHA verificato, blocchi e prossima azione | Issue, PR, Checkpoint, record CI | Solo se esiste una vera lacuna tra sessioni |
| Decisioni storiche assenti dal repository | Decision record revisionabile o memoria approvata | Possibile, con fonte e ambito |
| Regole cambiate ed eccezioni temporanee | Aggiornare i fatti del repository e ritirare la vecchia regola | Non basta aggiungere nuove memorie |
| Contesto che non deve oltrepassare un confine dati | Mantenerlo entro il perimetro locale autorizzato | Non copiarlo nel cloud solo per ricordarlo |
Ciclo tre: la memoria è stata letta, ma il task è fallito
Questo ciclo ha testato una regola di compatibilità storica che il repository attuale non permetteva di dedurre: nell’esportazione CSV e TSV, Python None deve diventare il valore letterale \N; le stringhe vuote restano campi vuoti e la stringa NULL rimane invariata.
La traccia di training di Codex è stata trasformata in un candidato, revisionata, approvata e materializzata. Poi Antigravity ha letto la memoria approvata tramite Beacon Local MCP. Il riepilogo locale registra una chiamata a get_memory e due a search_memory. Questo prova il recupero in quella esecuzione, non il riuso corretto.
| Gruppo consumer Antigravity | Memoria letta? | Test CSV pubblici | Controllo nascosto indipendente |
|---|---|---|---|
| A0 senza memoria | No | 3/3 PASS | FAIL |
| MCP con memoria | Sì | 3/3 PASS | FAIL |
L’indizio principale è la discrepanza di ambito. Il testo della memoria cita CSV e TSV, ma i metadati applicability indicano solo render_tsv / compatibilità TSV. Secondo il riepilogo di esecuzione, Antigravity ha considerato le due funzioni di esportazione implementazioni separate e non ha applicato al CSV una regola etichettata per TSV.
È una spiegazione forte, non una causa unica confermata: il checker nascosto ha restituito solo un FAIL complessivo, senza l’asserzione precisa. Poiché entrambi i gruppi consumer hanno fallito, il risultato non dimostra nemmeno che la memoria abbia peggiorato il task. C’era un solo task sintetico per gruppo e le impostazioni dei modelli sottostanti non erano documentate come confronto controllato.
Dopo il FAIL, allargare manualmente l’applicabilità fino a ottenere PASS avrebbe misurato la mia capacità di regolare la memoria conoscendo la risposta, non la cattura e il riuso naturali della conoscenza storica. Ho quindi fermato l’esperimento senza costruire un lieto fine artificiale.
Memoria obsoleta, log locali e confini del codice
In un fixture separato, il target Makefile è passato da gen a generate, ma il vecchio Skill continuava a indicare make gen. L’Agent ha incontrato l’errore, riletto il Makefile, usato make generate e superato 4/4 test. Il vecchio Skill è rimasto. Questo mostra che l’Agent può recuperare controllando i fatti correnti del repository; non dimostra che Beacon aggiorni o ritiri automaticamente le memorie obsolete.
Nel log runtime locale, il marcatore sintetico PLUMOTTER9917 è comparso letteralmente e le righe corrispondenti sono passate da 7 a 25. Il canary simile a un token sk-canaryfake è passato da 0 a 4, mentre REDACTED da 1 a 6. Non ho esaminato le quattro righe del canary, quindi non posso dire se contenessero il valore di test, un prefisso residuo o testo di ricerca/test registrato. L’esito della redazione resta incerto. Beacon Cloud non era collegato: i log locali non provano un inoltro al cloud.
La revisione del codice è fissata al commit Beacon d7a3a72. La logica di redazione dipende dai nomi dei campi e da pattern noti, non è un rilevatore universale di segreti nel linguaggio naturale. Nello snapshot fissato non ho trovato una mappatura per eventi Codex File/MCP nella matrice di raccolta o nel convertitore OTLP. È un’ispezione del codice, non una cattura di pacchetti runtime. Anche l’evaluator Jev è stato soltanto esaminato nel sorgente, mai eseguito: non esistono punteggi o misure di precisione della distillazione.
La memoria deve colmare i vuoti del repository, non duplicarlo
Questi esperimenti non dimostrano né l’efficacia generale di Agent Memory né la sua inutilità. Terrei nel repository i fatti attuali e verificabili, userei Checkpoint per passaggi espliciti e riserverei la memoria separata alle decisioni storiche assenti dal repository, con fonte e ambito. Le memorie obsolete devono poter essere individuate, limitate e ritirate. Log locali, MCP, valutazione ospitata e inoltro al cloud vanno verificati separatamente.
Il verdetto è semplice: il recupero cross-Harness è stato verificato; un beneficio aggiuntivo sul task no. Il prossimo esperimento utile dovrebbe mostrare l’asserzione nascosta e usare task controllati e ripetibili, invece di ritoccare i metadati dopo aver visto il fallimento.
Date degli esperimenti: cicli uno e due il 26 ottobre 2026; test consumer Antigravity MCP il 27 ottobre 2026.