Errore fino a 0,45× con il disegno allineato, fino a 2,03× con quello sbagliato: audit con verità nota del campionamento delle superfici IV
Un corpus filtrato della catena di opzioni NVDA proveniente da OptionsDX — 753 giorni di contrattazione dal 2019–2021, 432.529 record di contratti che hanno superato i filtri OTM, scadenza, quotazione e qualità della IV (circa 574 al giorno). Compilare una superficie di volatilità implicita — 4 bande di moneyness × 3 scadenze, 12 celle in tutto — non richiede davvero l’intera catena: se ne può scartare metà, o perfino tre quarti, e la superficie si compila lo stesso. L’unica questione è quali contratti scartare. Un chiarimento preliminare: la «superficie» qui è la griglia di queste 12 medie di IV per cella, non un fit parametrico continuo di tipo SVI; ciò che questo articolo valuta è la precisione di ricostruzione campionaria delle medie per cella.
Il paper di Bastola e Prushansky (arXiv:2610.33438) sposta il problema nel quadro del campionamento d’indagine: una catena di opzioni è una popolazione finita, compilare una superficie è stimare medie per cella, e un disegno di campionamento deve prima rispondere a «qual è l’obiettivo?». La loro risposta è netta: se l’obiettivo è una superficie a pesi uguali, si alloca in modo stratificato secondo la dispersione di ciascuna cella del giorno precedente; se l’obiettivo è una superficie ponderata per la liquidità, si usa il PPS di liquidità (probabilità proporzionale alla dimensione); sbagliare moltiplica l’errore.
Ho rieseguito l’intero protocollo su una catena di opzioni sintetica con verità nota: le affermazioni centrali del lato a pesi uguali si sono riprodotte, e anche la direzione della penalità da disallineamento; ma la frase più bella del paper, «vince per costruzione», non si è riprodotta così com’è scritta. Nella mia popolazione, il PPS di liquidità batte ancora il campionamento casuale sul suo obiettivo abbinato (rapporti 0,50–0,81), ma perde a ogni tasso di ritenzione contro la più semplice stratificazione a celle uguali: ciò che ha perso è la parola «inevitabile», non il PPS in sé. Questo articolo tratta tre cose: perché l’allineamento paga, perché il disegno sbagliato raddoppia l’errore, e perché il «necessario per costruzione» regge solo quando obiettivo e budget vivono allo stesso livello.
Prima i confini: tutte le cifre del paper provengono da un unico sottostante, NVDA, tutte dichiarate dagli autori, su tre archi di dati diversi (longitudinale 2018–2025, corpus trasversale 2019–2021, intraday 2022–2025); la mia riverifica usa una popolazione sintetica ed esamina il meccanismo e l’ordinamento, non le grandezze di NVDA. Non ho testato le parti del paper sull’equivalenza dell’addestramento longitudinale né sulla previsione della IV; quando appariranno più sotto, saranno marcate come dichiarate dagli autori.
Il protocollo del paper: prima l’obiettivo in una frase, poi il campionamento
Lo studio trasversale del paper (§3) ha solo quattro disegni. Il campionamento casuale semplice (SRS) è il riferimento. Il PPS di liquidità assegna a ogni contratto una dimensione (w=(\text{volume}+1)/(\text{spread relativo}+10^{-4})); la probabilità di inclusione è proporzionale a (w), troncata a 1 per le unità certe, e l’estrazione avviene con campionamento sistematico di Madow (punti equidistanti sulla scala di probabilità cumulata).
Gli altri due sono disegni stratificati: prima si divide secondo la griglia 4×3, poi si alloca usando la deviazione standard della IV interna alla cella del giorno di contrattazione precedente (con un giorno di ritardo, contro l’anticipazione): l’allocazione di Neyman (n_h \propto N_h S_{h,t-1}) corrisponde all’obiettivo ponderato per la popolazione, e l’allocazione a celle uguali (n_h \propto S_{h,t-1}) all’obiettivo delle 12 celle a pesi uguali (allocazione secondo la dispersione ritardata interna alla cella, non lo stesso numero per cella). Lo stimatore cambia con l’obiettivo: Hájek per i pesi uguali, uno stimatore di rapporto di Horvitz–Thompson per i pesi di liquidità. Entrambi sono medie ponderate normalizzate dai pesi; differiscono solo nel fatto che il peso sia l’inverso della probabilità di inclusione oppure quell’inverso moltiplicato per il punteggio di liquidità. Se una cella non estrae nulla, la riempie una media globale ponderata dal disegno.
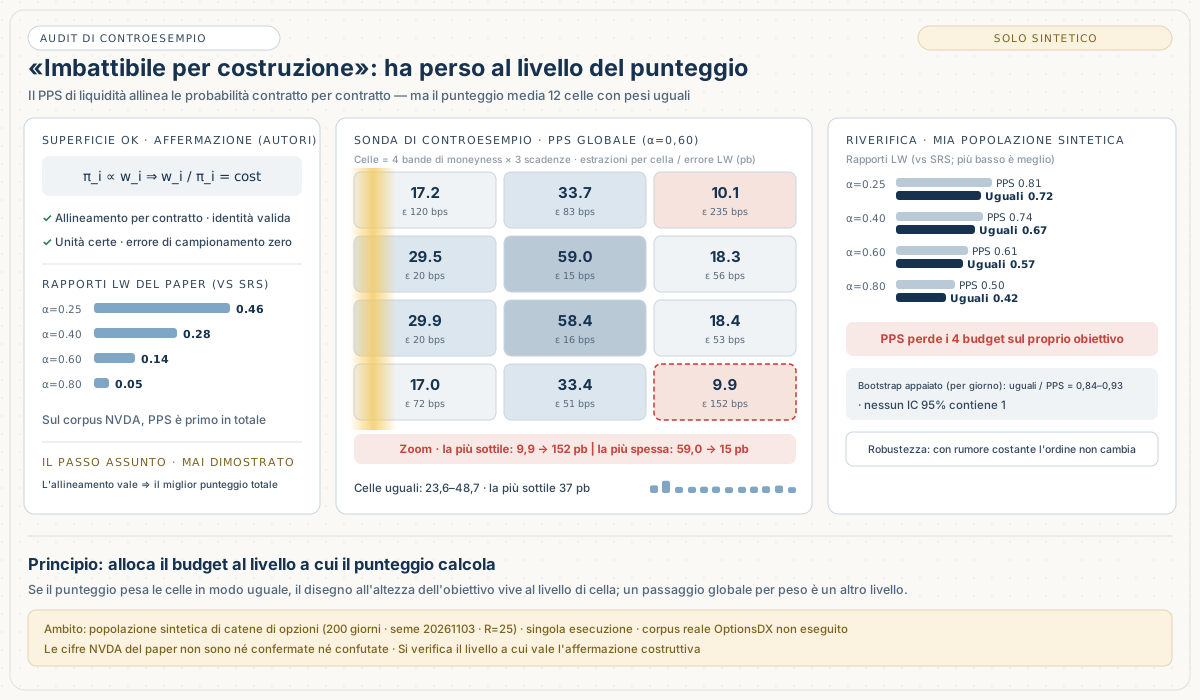
Risultati dichiarati dagli autori (sul corpus filtrato OptionsDX di cui sopra): sull’obiettivo a pesi uguali, celle uguali e Neyman battono SRS a tutti e quattro i tassi di ritenzione (α = 0,25 / 0,40 / 0,60 / 0,80); con α=0,25 l’RMSE di griglia scende da 124,0 pb a 84,8 (rapporto 0,68) e 94,9 (0,77), con α=0,80 i rapporti arrivano a 0,47 e 0,69, con copertura stratificata delle celle al 100 %. Sull’obiettivo ponderato per la liquidità, il PPS di liquidità affonda il rapporto a 0,46 / 0,28 / 0,14 / 0,05 — gli autori stessi annotano che ciò vale «per costruzione», perché le probabilità di inclusione sono i pesi dell’obiettivo —; ma lo stesso PPS, applicato all’obiettivo a pesi uguali, gonfia l’RMSE a 2,47–3,90 volte quello di SRS.
La mia riverifica: catena sintetica con verità nota, parametri congelati prima
Il corpus reale di NVDA non è ottenibile (i dati stanno dietro una licenza del fornitore e gli script si richiedono agli autori), e anche con esso la «verità» sarebbe solo approssimata dal campione completo. Il vantaggio di una popolazione sintetica è una verità esatta: ho generato 200 giorni di contrattazione di catene di opzioni da una superficie parametrizzata (livello, asimmetria, curvatura e struttura a termine variabili per giorno): 111.573 contratti in tutto (mediana di 534 al giorno, la stessa classe di densità del corpus del paper), ogni contratto con volume e spread relativo, con IV osservata = verità + rumore di quotazione proporzionale allo spread. I parametri della popolazione e il seme casuale sono stati congelati per iscritto prima di eseguire qualsiasi confronto tra disegni; nulla è mai stato ritoccato a metà per inseguire i rapporti del paper.
Il protocollo di campionamento segue alla lettera i §3.1–3.2 del paper: gli stessi limiti di griglia, la stessa dispersione ritardata, la stessa allocazione proporzionale con arrotondamento per resto massimo, lo stesso PPS sistematico di Madow con troncamento di certezza, gli stessi due stimatori e la stessa regola di riempimento delle celle vuote. Ogni giorno, α e disegno riceve 25 estrazioni (il paper ne usa 3; io ne estraggo di più solo per ridurre il rumore di Monte Carlo, in modo identico per tutti i disegni), e l’incertezza dei rapporti è intervallata con un bootstrap a grappoli di giornate intere (1.000 repliche). La parte degli orologi è riverificata a parte, su un processo intraday con raggruppamento di volatilità GARCH; dettagli più sotto.
Risultato 1: l’allineamento si riproduce — celle uguali 0,45, Neyman 0,72
Sull’obiettivo a pesi uguali, i miei rapporti (rispetto a SRS; più bassi è meglio). Tabella 1: rapporti di RMSE di griglia rispetto a SRS sull’obiettivo di superficie IV a pesi uguali:
| Disegno | α=0,25 | α=0,40 | α=0,60 | α=0,80 |
|---|---|---|---|---|
| Allocazione a celle uguali | 0,73 | 0,68 | 0,59 | 0,45 |
| Allocazione di Neyman | 0,82 | 0,83 | 0,78 | 0,72 |
| PPS di liquidità | 1,66 | 1,84 | 1,96 | 2,03 |
Celle uguali e Neyman battono SRS a tutti e quattro gli α, e l’intervallo al 95 % di ogni rapporto esclude 1; entrambi i disegni stratificati coprono il 100 % delle celle a ogni α (SRS arriva al 99,7 % con α=0,25, PPS al 98,9 %). L’ordinamento coincide esattamente con quello del paper (celle uguali < Neyman < SRS), e anche il gradiente del vantaggio al crescere di α: il paper va da 0,68 a 0,47, il mio da 0,73 a 0,45. I livelli assoluti differiscono (il mio RMSE di SRS parte da 288,5 pb, quello del paper da 124,0 pb; la struttura di rumore sintetica è più grossolana), ma è esattamente ciò che era stato preregistrato: l’affermazione è l’ordinamento, non la grandezza. Si noti anche che i due estremi del titolo (0,45 e 2,03) escono entrambi dall’obiettivo a pesi uguali con α=0,80; con α=0,25 sono 0,73 e 1,66: con budget più stretti, il divario si restringe in entrambe le direzioni.
Il meccanismo non è difficile da vedere: un obiettivo a pesi uguali dà a ogni cella lo stesso peso, incluse le celle molto fuori dal denaro, con pochi contratti e alta dispersione. Il campionamento uniforme cade in proporzione al numero di contratti, così le celle sottili ricevono una manciata di estrazioni e il loro rumore di media domina l’errore di griglia; allocare secondo la dispersione ritardata sposta il budget di campione dove l’errore si produce davvero. È direttamente utilizzabile da chiunque sottocampioni una catena di opzioni: scriva prima se il suo obiettivo è una superficie a celle uguali o una media di popolazione, e lasci che la formula di allocazione segua l’obiettivo.
Risultato 2: con il disegno sbagliato, l’errore raddoppia
Sull’obiettivo a pesi uguali, il PPS di liquidità registra 1,66 / 1,84 / 1,96 / 2,03: la stessa direzione del 2,47–3,90 del paper, con una grandezza di un gradino minore. Non è che il PPS sia «cattivo»; è che il PPS ottimizza un obiettivo che non è nella stanza: le probabilità di inclusione proporzionali al punteggio di liquidità ammucchiano quasi tutte le estrazioni vicino al denaro e alla scadenza breve, mentre l’obiettivo a pesi uguali conta una cella molto OTM e lunga esattamente quanto una vicina al denaro. Quelle celle o non estraggono nulla (la copertura scende già al 98,9 % con α=0,25) e vengono riempite con la media globale, o sopravvivono con una o due estrazioni, e l’errore raddoppia.
Questo risultato porta l’avvertimento pratico più affilato: in molte pipeline, il «campionamento per importanza» o «campionare per liquidità» è una mossa predefinita, che equivale a scambiare in silenzio l’obiettivo con un mondo ponderato per la liquidità. Chi fa quel passo raramente si accorge di aver cambiato l’obiettivo.
Risultato 3: «vince per costruzione» perde
Il terzo insieme di cifre è quello che merita di essere scritto. Si cambia l’obiettivo in quello ponderato per la liquidità — il terreno proprio del PPS — e i rapporti diventano:
| Disegno (obiettivo LW) | α=0,25 | α=0,40 | α=0,60 | α=0,80 |
|---|---|---|---|---|
| Allocazione a celle uguali | 0,72 | 0,67 | 0,57 | 0,42 |
| Allocazione di Neyman | 0,83 | 0,83 | 0,77 | 0,69 |
| PPS di liquidità | 0,81 | 0,74 | 0,61 | 0,50 |
Il PPS batte sì SRS (0,50–0,81; con α=0,80 il suo intervallo al 95 % rispetto a SRS è [0,48, 0,52], quello di celle uguali [0,40, 0,44]), ma perde contro l’allocazione a celle uguali a ogni α. Nel paper, la stessa posizione legge 0,46 / 0,28 / 0,14 / 0,05: con α=0,80 l’errore del PPS è un ventesimo di quello di SRS. Nella mia popolazione, quel dominio non esiste.
Prima la precisione: questo non costituisce una confutazione delle cifre NVDA del paper; le grandezze non sono mai state nell’ambito dell’affermazione. E vanno separate due proprietà compresse nella sola frase «vince per costruzione»: quando π è proporzionale a w, w/π è costante per le unità non certe e le unità certe non apportano errore di campionamento; questa è un’identità analitica, vale anche nella mia popolazione, e non l’ho rovesciata. Ciò che ha perso è l’inferenza che scivola fuori dall’identità: l’identità parla dell’allineamento contratto per contratto, mentre il punteggio del paper (la sua Eq. 9) calcola prima le medie LW delle 12 celle e poi le media con pesi uguali tra celle, e il budget del PPS viene allocato in una volta, globalmente, per peso — allineamento al livello del contratto, allocazione al livello globale, punteggio al livello di cella; quando i tre non sono allo stesso livello, l’identità non può garantire il punteggio totale. La densità di contratti della mia popolazione è nella classe del corpus del paper (mediana di 534 al giorno contro circa 574), e il gradiente di peso totale tra celle è ripido (mediana del rapporto tra la cella più spessa e la più sottile: 21,8×); la struttura di rumore è, per ammissione, più grossolana (il mio RMSE di SRS parte da 288,5 pb contro 124,0 pb). Va escluso anche un accoppiamento: il mio rumore di osservazione è generato in proporzione allo spread, e il peso del PPS porta proprio lo spread relativo al denominatore, così i contratti di peso alto portano rumore basso di fabbrica. Ho rieseguito l’intero insieme con rumore costante indipendente dallo spread (con la media allineata a quella del disegno originale): sull’obiettivo LW, il PPS registra 0,51–0,86 e celle uguali 0,35–0,52; celle uguali resta sotto a ogni budget. L’accoppiamento è escluso; ciò che resta è il disallineamento di livello in sé.
Il meccanismo si vede al livello di cella. Ho ricontrollato la struttura della mia popolazione: il peso di liquidità dentro ogni cella non è disperso — i primi 5 contratti concentrano una quota mediana di 0,56 del peso della cella — e con α=0,60 il PPS ha una mediana di 165 contratti al giorno come unità certe. In altre parole, la via «il PPS fissa la media ponderata afferrando i contratti di testa» è aperta anche nella mia popolazione, e ha perso lo stesso. Le celle con poco peso totale ricevono anche poche estrazioni, così le loro medie LW si reggono su una manciata di campioni; l’allocazione a celle uguali dà un pavimento a ogni cella e aggiunge secondo la dispersione, e la copertura stessa diventa precisione. La scomposizione per cella sostiene questa lettura (α=0,60): sotto PPS, la cella più sottile riceve in media solo 9,9 estrazioni, con un errore LW di cella di 152 pb; la più spessa, 59 estrazioni e 15 pb — una dispersione di estrazioni di circa 6 volte tra celle. L’allocazione a celle uguali comprime le estrazioni tra 23,6 e 48,7, con un errore della cella più sottile di 37 pb. E questa «sconfitta» non è un’illusione della stima puntuale: accoppiando giorno per giorno gli RMSE di celle uguali e PPS in un bootstrap a grappoli di giornate intere, i rapporti celle uguali/PPS ai quattro α sono 0,89 / 0,90 / 0,93 / 0,84, con intervalli al 95 % di [0,86, 0,92], [0,87, 0,94], [0,89, 0,97] e [0,80, 0,88], nessuno dei quali contiene 1. Mi sono anche autoispezionato prima nell’implementazione: sull’obiettivo LW, i quattro disegni sono punteggiati con lo stesso campione sotto lo stimatore di rapporto HT; campionamento e punteggio sono due scelte indipendenti. I disegni stratificati mostrano rapporti quasi identici su entrambi gli obiettivi (differenze di 0,00–0,03) proprio perché le loro allocazioni non dipendono dall’obiettivo: lo stesso campione, ripunteggiato con un altro peso di normalizzazione. Solo il PPS, le cui probabilità di inclusione sono generate direttamente da w, si ribalta con l’obiettivo. Nel corpus NVDA, la precisione interna alla cella del PPS globale si rivela abbastanza alta perché il vantaggio dell’identità si incassi come primo posto totale; è la distribuzione del corpus ad appianare il divario di livello, non un contenuto dell’identità stessa. Detto pianamente: ponderi l’obiettivo come vuole — allochi il budget al livello a cui il punteggio calcola. Quando il punteggio pondera le celle in modo uguale, l’allocazione al livello di cella è il disegno che sta al livello dell’obiettivo. Ciò non dipende da alcun corpus particolare; lo fissa la struttura del protocollo. Le condizioni della distribuzione muovono la dimensione del divario, non questo giudizio strutturale.
Questa è anche la postura metodologica più imparabile del paper: gli autori hanno scritto «by construction» in bella vista, il che equivale a lasciare ai lettori un’interfaccia falsificabile. La mia riverifica ha semplicemente usato quell’interfaccia.
La parte degli orologi: code più sottili, raggruppamento intatto
Il secondo protocollo del paper sono gli orologi di attività: le barre non si tagliano a minuti fissi, ma per volume o per volume in dollari, con soglie calibrate causalmente sulla media mobile degli ultimi 60 giorni di contrattazione. Dichiarato dagli autori: sotto un’espansione di prezzo di 18,9× tra picco e valle, gli orologi mobili di volume/dollari mantengono circa 7,5–9,0 barre al giorno (base dei rendimenti interni 7,49 / 7,99; base del campione completo 8,49 / 8,99), la curtosi in eccesso interna è compressa a 1,83 / 2,49 (barre temporali 5,00; standardizzato per stagionalità intraday 5,09); ma l’autocorrelazione del primo ordine dei rendimenti al quadrato resta a 0,170 / 0,215 — il raggruppamento non si muove; e la precisione di direzione della barra successiva è 48,6–51,0 %, senza che nemmeno l’alfa appaia dal nulla.
Ho riverificato su un processo intraday sintetico di 320 giorni di contrattazione (stagionalità intraday a U, varianza al minuto GARCH(1,1), shock t5, salti, espansione di prezzo di 8,6×; i primi 60 giorni calibrano, il resto è punteggiato con il protocollo mobile di 60 giorni). Prima, un episodio da dichiarare: nella prima versione della popolazione avevo impostato l’accoppiamento di volume troppo forte — i giorni di volume estremo spingevano le soglie mobili così in alto che un giorno tipico tagliava solo circa 4 barre, e il processo non conteneva affatto un raggruppamento intraday da misurare. Quella versione è stata scartata prima di qualsiasi verdetto — sulla base di controlli di validità precedenti a qualsiasi giudizio sugli orologi (la distribuzione del volume è sensata? il raggruppamento esiste? il tasso di barre è in una grandezza punteggiabile?) — e le modifiche hanno toccato solo i parametri della popolazione (accoppiamento con tetto, GARCH aggiunto); l’intero episodio è agli atti. I risultati rivisti:
- Tasso di barre: volume mobile 9,40 ± 3,20 barre/giorno, medie per tratto 10,1 / 9,1 / 9,7, attaccate all’obiettivo (8,75 è la frequenza obiettivo che ho prefissato per questa popolazione sintetica; la costante del paper, calibrata sul suo pannello di 967 sessioni, è 8,273, e il meccanismo di soglia causale mobile di 60 giorni è conservato tale e quale); dollari mobili 11,28 ± 4,67, tratti 12,3 / 10,8 / 11,6, senza tendenza temporale, ma assestati circa tre decimi sopra l’obiettivo (prima riserva). Nel gruppo di controllo, la soglia statica dei dollari sale nella stessa finestra da circa 15 a circa 53 (in totale 30,41 ± 18,29): la calibrazione mobile stabilizza la tendenza, non il livello.
- Curtosi: prima l’aggregazione raggruppata che il paper riporta — volume mobile 0,69 (intervallo di bootstrap a grappoli di giornate [0,15, 1,54]), dollari mobili 0,55 ([0,27, 0,81]), contro barre temporali 8,73 e standardizzato intraday 6,83 ([3,02, 11,22]); le differenze di curtosi raggruppata di entrambi gli orologi mobili rispetto al controllo intraday sono −6,14 e −6,29, con intervalli che escludono lo 0: la compressione raggruppata regge; nell’ultimo 40 % di giorni riservato, entrambi gli orologi mobili restano molto sotto i controlli (0,41 / 0,56 contro 12,64 / 8,18). Ma l’aggregazione per giorno si divide: la differenza giornaliera del volume è −0,13 ([−0,22, −0,04]), a sostegno; quella dei dollari è +0,13 ([+0,02, +0,23]), in senso contrario. Così «code più sottili» è una conclusione valida in entrambe le aggregazioni per l’orologio di volume, e solo nell’aggregazione raggruppata per quello dei dollari (seconda riserva).
- Raggruppamento e direzione: l’autocorrelazione raggruppata del primo ordine dei rendimenti al quadrato è positiva sotto tutti e sei gli orologi (0,05–0,18); nessun orologio la porta a zero. La precisione di direzione della barra successiva è 0,493–0,510, sovrapposta alla banda di caso del paper. Chiariamo il peso di questo punto: il mio processo ha media condizionale zero per costruzione, così la direzione è imprevedibile in principio; ciò che questo controllo esamina non è se un orologio possa creare prevedibilità dal nulla, ma se la trasformazione dell’orologio fabbrichi prevedibilità spuria: non lo fa.
La conclusione coincide con quella degli stessi autori: gli orologi di attività sono uno strumento di conformazione della distribuzione incondizionale, non una soluzione per la dinamica della volatilità, né una fonte di segnale. Chi legge la bassa curtosi di una barra di volume come «il rischio è sparito» ha confuso la conformazione con l’eliminazione.
Ciò che non ho testato: l’onestà dichiarata degli autori
Ci sono due parti del paper che non ho toccato, e stanno qui perché il lettore ne conosca il peso (tutto dichiarato dagli autori):
Nel campionamento longitudinale delle finestre di addestramento, PPS e Neyman con α=0,60 trattengono più finestre di volatilità di coda (ritenzione del decile superiore 81,2 % / 73,7 % contro 59,9 % di SRS), tutti e tre i disegni sono equivalenti all’addestramento completo entro un margine TOST prefissato e si risparmia il 21–22 % di tempo di calcolo; ma gli autori riportano anche che il guadagno predittivo incrementale dei disegni informativi rispetto a SRS non è stabilito (test appaiati p ≥ 0,608): il campionamento risparmia calcolo, non precisione.
La parte di previsione è il caso classico: HAR-IV registra un’abilità MSE raggruppata di +21,0 %, l’LSTM di livello 2 un +17,2 % senza battere HAR-IV (test DM a grappoli p=0,61). Gli stessi autori forniscono il registro di concentrazione: i primi 5 giorni di contrattazione apportano il 144–157 % del miglioramento netto dell’errore quadratico, il test a grappoli di giornate contro il riferimento di persistenza non è significativo (p=0,34) e la persistenza vince nel 57,3 % dei giorni. Estrarre il +21 % e diffonderlo da solo è leggere male questo paper: gli autori hanno stampato la cautela sulla stessa pagina della cifra.
Quattro regole da portare via
- Scriva prima l’obiettivo, poi scelga il disegno. Una superficie a celle uguali, una media di popolazione e una superficie ponderata per la liquidità sono tre estimandi distinti, che corrispondono rispettivamente all’allocazione a celle uguali, di Neyman e PPS; il disegno sbagliato può raddoppiare l’errore (nel mio caso 1,66–2,03×; nel paper, 2,47–3,90×).
- La copertura è una metrica dura (copertura delle celle). Se l’obiettivo è una grandezza per cella, qualsiasi disegno che non garantisca la copertura delle celle deve prima passare la barriera della copertura; che il campionamento probabilistico globale lasci affamate le celle sottili è il modo di fallimento più comune di un «vantaggio costruttivo».
- Allinei al livello a cui si punteggia. L’allineamento costruttivo è contratto per contratto (π ∝ w è un’identità); se il punteggio pondera le celle in modo uguale, l’allocazione del budget deve avvenire al livello di cella — un passaggio globale per peso non è allo stesso livello di un punteggio a celle uguali, e l’«imbattibile» non ha dove appoggiarsi. Le condizioni della distribuzione fissano la dimensione del divario, non questo giudizio strutturale.
- Conformare non è eliminare (tail shaping, not elimination). Gli orologi di attività comprimono la curtosi e stabilizzano i tassi di barre, ma non muovono il raggruppamento di volatilità e non producono segnali di direzione; nel valutare qualsiasi metodo che «doma le code», si chieda prima se agisce sulla distribuzione incondizionale o sulla dinamica condizionale.
Nota di evidenza e replicazione: le cifre di prima mano di questo articolo provengono da due esecuzioni con protocollo congelato su popolazioni sintetiche (popolazione di catene di opzioni: 200 giorni, seme 20261103; processo intraday: 320 giorni, seme 20261104), con il protocollo reimplementato dalle specifiche stampate nei §3.1–3.2 e §5 del paper; i parametri del braccio catene sono stati congelati prima di qualsiasi confronto, e la specifica finale del braccio orologi è stata congelata dopo una calibrazione pilota (lo scarto della v1 è agli atti) e non è stata cambiata di nuovo prima del confronto finale. Le ricevute complete, una corrispondenza affermazione per affermazione e il codice sono pubblici su github.com/vxime/iv-surface-sampling-replication (verificabili via SHA256SUMS). Il braccio del corpus reale OptionsDX non è stato eseguito — quel corpus si ottiene tramite l’account e il processo di pagamento del negozio del fornitore, che non è stato autorizzato per questo audit — così questo articolo non afferma alcuna replicazione con corpus reale. Le cifre del paper (Bastola e Prushansky, arXiv:2610.33438v1) sono tutte dichiarate dagli autori, e le sue parti di equivalenza longitudinale e di previsione non sono state riverificate da me. Questo articolo tratta solo di metodologia di campionamento e valutazione e non costituisce consulenza d’investimento.