Error de hasta 0,45× con el diseño alineado y de hasta 2,03× con el equivocado: auditoría con verdad conocida del muestreo de superficies IV
Un corpus filtrado de la cadena de opciones de NVDA procedente de OptionsDX: 753 días de negociación de 2019–2021, 432.529 registros de contratos que pasaron los filtros de OTM, vencimiento, cotización y calidad de IV (unas 574 por día). Compilar una superficie de volatilidad implícita —4 bandas de moneyness × 3 vencimientos, 12 celdas en total— no necesita en realidad la cadena completa: se puede descartar la mitad, o incluso tres cuartas partes, y la superficie se sigue compilando. La única cuestión es qué contratos descartar. Una aclaración previa: la «superficie» aquí es la rejilla de estas 12 medias de IV por celda, no un ajuste parametrizado continuo de tipo SVI; lo que este artículo evalúa es la precisión de reconstrucción muestral de las medias por celda.
El artículo de Bastola y Prushansky (arXiv:2610.33438) traslada el problema al marco del muestreo de encuestas: una cadena de opciones es una población finita, compilar una superficie es estimar medias por celda, y un diseño de muestreo debe responder primero a «¿cuál es el objetivo?». Su respuesta es tajante: si el objetivo es una superficie de pesos iguales, se asigna de forma estratificada según la dispersión de cada celda del día anterior; si el objetivo es una superficie ponderada por liquidez, se usa PPS de liquidez (probabilidad proporcional al tamaño); equivocarse multiplica el error.
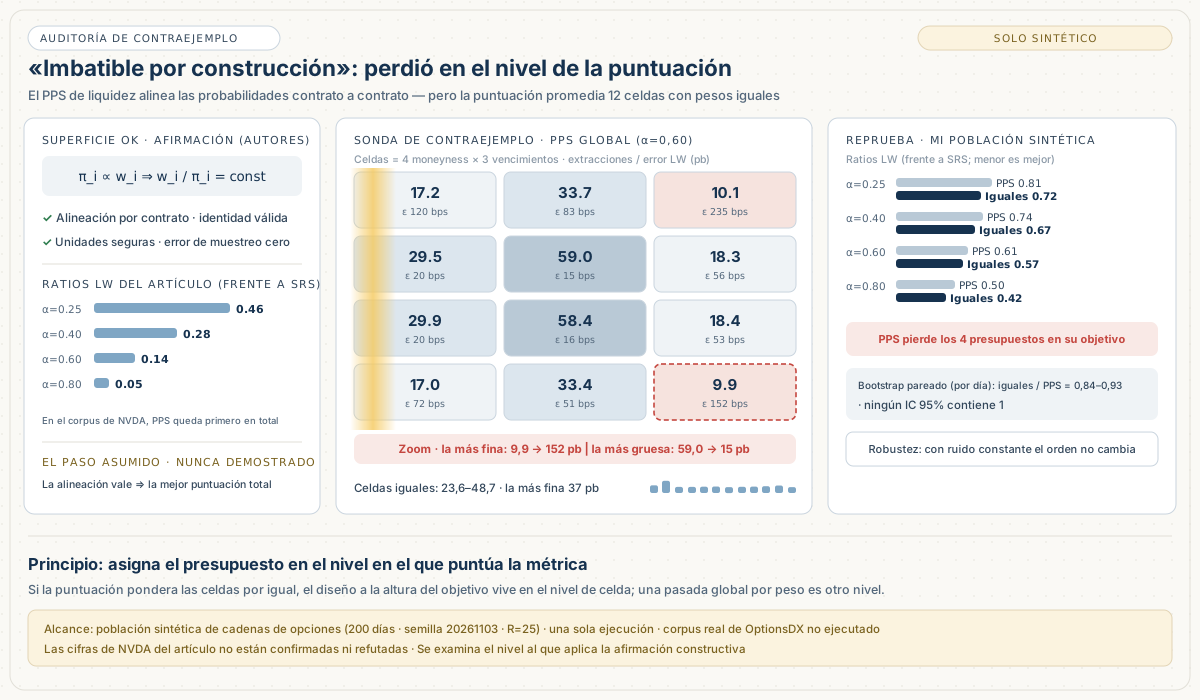
Repetí el protocolo completo sobre una cadena de opciones sintética con verdad conocida: las afirmaciones centrales del lado de pesos iguales se reprodujeron y la dirección de la penalización por desajuste también; pero la frase más bonita del artículo, «gana por construcción», no se reprodujo tal como está escrita. En mi población, el PPS de liquidez sigue ganando al muestreo aleatorio en su propio objetivo emparejado (ratios 0,50–0,81), pero pierde en todas las tasas de retención frente a la estratificación por celdas iguales, la más sencilla: lo que perdió fue la palabra «inevitable», no el PPS en sí. Este artículo trata de tres cosas: por qué la alineación vale, por qué el diseño equivocado duplica el error, y por qué lo «necesario por construcción» solo se sostiene cuando el objetivo y el presupuesto viven en el mismo nivel.
Primero, los límites: todas las cifras del artículo proceden de un único subyacente, NVDA, todas según sus autores, en tres tramos de datos distintos (longitudinal 2018–2025, corpus transversal 2019–2021, intradía 2022–2025); mi reprueba usa una población sintética y examina el mecanismo y el orden, no las magnitudes de NVDA. No probé las partes de equivalencia de entrenamiento longitudinal ni de predicción de IV del artículo; cuando aparezcan más abajo, irán marcadas como según los autores.
El protocolo del artículo: primero el objetivo en una frase, luego el muestreo
El estudio transversal del artículo (§3) tiene solo cuatro diseños. El muestreo aleatorio simple (SRS) es la referencia. El PPS de liquidez da a cada contrato un tamaño (w=(\text{volumen}+1)/(\text{spread relativo}+10^{-4})); la probabilidad de inclusión es proporcional a (w), truncada en 1 para las unidades seguras, y la extracción se realiza con muestreo sistemático de Madow (puntos equidistantes sobre la escala de probabilidad acumulada).
Los otros dos son diseños estratificados: primero se divide por la rejilla 4×3 y después se asigna usando la desviación típica de la IV dentro de cada celda del día de negociación anterior (con un día de retardo, contra la anticipación): la asignación de Neyman (n_h \propto N_h S_{h,t-1}) corresponde al objetivo ponderado por población, y la asignación de celdas iguales (n_h \propto S_{h,t-1}) al objetivo de 12 celdas con pesos iguales (asignación según la dispersión retardada dentro de la celda, no el mismo número por celda). El estimador cambia con el objetivo: Hájek para pesos iguales, un estimador de razón de Horvitz–Thompson para pesos de liquidez. Ambos son medias ponderadas normalizadas por los pesos; difieren solo en si el peso es el inverso de la probabilidad de inclusión o ese inverso multiplicado por la puntuación de liquidez. Si una celda no extrae nada, la rellena una media global ponderada por el diseño.
Resultados según los autores (sobre el corpus filtrado de OptionsDX mencionado): en el objetivo de pesos iguales, celdas iguales y Neyman ganan al SRS en las cuatro tasas de retención (α = 0,25 / 0,40 / 0,60 / 0,80); con α=0,25 el RMSE de rejilla baja de 124,0 pb a 84,8 (ratio 0,68) y 94,9 (0,77), con α=0,80 los ratios llegan a 0,47 y 0,69, con una cobertura estratificada de celdas del 100 %. En el objetivo ponderado por liquidez, el PPS de liquidez hunde el ratio a 0,46 / 0,28 / 0,14 / 0,05 —los propios autores anotan que esto se cumple «por construcción», porque las probabilidades de inclusión son los pesos del objetivo—; pero ese mismo PPS, aplicado al objetivo de pesos iguales, infla el RMSE a 2,47–3,90 veces el del SRS.
Mi reprueba: cadena sintética con verdad conocida, parámetros congelados antes
El corpus real de NVDA no se puede obtener (los datos están tras una licencia de proveedor y los guiones se solicitan a los autores), e incluso con él, la «verdad» solo podría aproximarse con la muestra completa. La ventaja de una población sintética es una verdad exacta: generé 200 días de negociación de cadenas de opciones a partir de una superficie parametrizada (nivel, asimetría, curvatura y estructura temporal variables por día): 111.573 contratos en total (mediana de 534 por día, la misma clase de densidad que el corpus del artículo), cada contrato con volumen y spread relativo, con IV observada = verdad + ruido de cotización proporcional al spread. Los parámetros de la población y la semilla aleatoria quedaron congelados por escrito antes de ejecutar cualquier comparación de diseños; en ningún momento se ajustó nada para perseguir los ratios del artículo.
El protocolo de muestreo sigue al pie de la letra los §3.1–3.2 del artículo: los mismos límites de rejilla, la misma dispersión retardada, la misma asignación proporcional con redondeo por resto mayor, el mismo PPS sistemático de Madow con truncamiento de seguridad, los mismos dos estimadores y la misma regla de relleno de celdas vacías. Cada día, α y diseño recibe 25 extracciones (el artículo usa 3; yo extraigo más solo para reducir el ruido de Monte Carlo, igual para todos los diseños), y la incertidumbre de los ratios se acota con un bootstrap por clústeres de días completos (1.000 réplicas). La parte de los relojes se reprueba aparte, sobre un proceso intradía con agrupamiento de volatilidad GARCH; los detalles, más abajo.
Resultado 1: la alineación se reproduce — celdas iguales 0,45, Neyman 0,72
En el objetivo de pesos iguales, mis ratios (frente a SRS; cuanto menor, mejor). Tabla 1: ratios de RMSE de rejilla frente a SRS en el objetivo de superficie IV de pesos iguales:
| Diseño | α=0,25 | α=0,40 | α=0,60 | α=0,80 |
|---|---|---|---|---|
| Asignación de celdas iguales | 0,73 | 0,68 | 0,59 | 0,45 |
| Asignación de Neyman | 0,82 | 0,83 | 0,78 | 0,72 |
| PPS de liquidez | 1,66 | 1,84 | 1,96 | 2,03 |
Celdas iguales y Neyman ganan al SRS en los cuatro α, y el intervalo del 95 % de cada ratio excluye el 1; ambos diseños estratificados cubren el 100 % de las celdas en cada α (el SRS llega al 99,7 % con α=0,25 y el PPS al 98,9 %). El orden coincide exactamente con el del artículo (celdas iguales < Neyman < SRS), y también el gradiente de la ventaja al crecer α: el artículo va de 0,68 a 0,47; el mío, de 0,73 a 0,45. Los niveles absolutos difieren (mi RMSE del SRS parte de 288,5 pb; el del artículo, de 124,0 pb; la estructura de ruido sintética es más gruesa), pero eso es exactamente lo que se prerregistró: la afirmación es el orden, no la magnitud. Nótese además que los dos extremos del título (0,45 y 2,03) salen ambos del objetivo de pesos iguales con α=0,80; con α=0,25 son 0,73 y 1,66: con presupuestos más ajustados, la brecha se estrecha en ambas direcciones.
El mecanismo no es difícil de ver: un objetivo de pesos iguales da a cada celda el mismo peso, incluidas las celdas muy fuera del dinero, con pocos contratos y mucha dispersión. El muestreo uniforme cae en proporción al número de contratos, así que las celdas finas reciben un puñado de extracciones y su ruido de media domina el error de rejilla; asignar según la dispersión retardada traslada el presupuesto de muestra adonde el error se produce de verdad. Esto es directamente usable por cualquiera que submuestree una cadena de opciones: escriba primero si su objetivo es una superficie de celdas iguales o una media poblacional, y deje que la fórmula de asignación siga al objetivo.
Resultado 2: con el diseño equivocado, el error se duplica
En el objetivo de pesos iguales, el PPS de liquidez registra 1,66 / 1,84 / 1,96 / 2,03: la misma dirección que el 2,47–3,90 del artículo, con una magnitud un escalón menor. No es que el PPS sea «malo»; es que el PPS optimiza un objetivo que no está en la sala: las probabilidades de inclusión proporcionales a la puntuación de liquidez amontonan casi todas las extracciones cerca del dinero y del vencimiento corto, mientras que el objetivo de pesos iguales cuenta una celda muy OTM y larga exactamente igual que una cercana al dinero. Esas celdas o no extraen nada (la cobertura ya cae al 98,9 % con α=0,25) y se rellenan con la media global, o sobreviven con una o dos extracciones, y el error se duplica.
Este resultado lleva la advertencia práctica más afilada: en muchas tuberías, el «muestreo por importancia» o «muestrear por liquidez» es un movimiento por defecto, que equivale a cambiar en silencio el objetivo por un mundo ponderado por liquidez. Quienes dan ese paso rara vez se dan cuenta de que han cambiado el objetivo.
Resultado 3: «gana por construcción» pierde
El tercer conjunto de cifras es el que merece ser escrito. Se cambia el objetivo al ponderado por liquidez —el terreno propio del PPS— y los ratios quedan así:
| Diseño (objetivo LW) | α=0,25 | α=0,40 | α=0,60 | α=0,80 |
|---|---|---|---|---|
| Asignación de celdas iguales | 0,72 | 0,67 | 0,57 | 0,42 |
| Asignación de Neyman | 0,83 | 0,83 | 0,77 | 0,69 |
| PPS de liquidez | 0,81 | 0,74 | 0,61 | 0,50 |
El PPS sí gana al SRS (0,50–0,81; con α=0,80 su intervalo del 95 % frente a SRS es [0,48, 0,52] y el de celdas iguales [0,40, 0,44]), pero pierde frente a la asignación de celdas iguales en cada α. En el artículo, la misma posición lee 0,46 / 0,28 / 0,14 / 0,05: con α=0,80 el error del PPS es una veinteava parte del del SRS. En mi población, ese dominio no existe.
Primero, precisión: esto no constituye una refutación de las cifras de NVDA del artículo; las magnitudes nunca estuvieron en el ámbito de la afirmación. Y hay que separar dos propiedades que se comprimen en la sola frase «gana por construcción»: cuando π es proporcional a w, w/π es constante para las unidades no seguras y las unidades seguras no aportan error de muestreo; eso es una identidad analítica, se cumple también en mi población, y no la he derribado. Lo que perdió es la inferencia que se desliza fuera de la identidad: la identidad habla de la alineación contrato a contrato, mientras que la puntuación del artículo (su Ec. 9) calcula primero las medias LW de las 12 celdas y luego las promedia con pesos iguales entre celdas, y el presupuesto del PPS se asigna de una vez, globalmente, por peso: alineación en el nivel del contrato, asignación en el nivel global, puntuación en el nivel de celda; cuando los tres no están en el mismo nivel, la identidad no puede avalar la puntuación total. La densidad de contratos de mi población está en la clase del corpus del artículo (mediana de 534 por día frente a unas 574), y el gradiente de peso total entre celdas es pronunciado (mediana del ratio entre la celda más gruesa y la más fina: 21,8×); la estructura de ruido es, admitidamente, más gruesa (mi RMSE del SRS parte de 288,5 pb frente a 124,0 pb). También hay que excluir un acoplamiento: mi ruido de observación se genera en proporción al spread, y el peso del PPS lleva justamente el spread relativo en el denominador, así que los contratos de peso alto traen ruido bajo de fábrica. Repetí todo el conjunto con ruido constante independiente del spread (con la media ajustada a la del diseño original): en el objetivo LW, el PPS registra 0,51–0,86 y celdas iguales 0,35–0,52; celdas iguales sigue por debajo en todos los presupuestos. El acoplamiento queda excluido; lo que queda es el propio desajuste de nivel.
El mecanismo se ve en el nivel de celda. Revisé la estructura de mi población: el peso de liquidez dentro de cada celda no está disperso —los 5 contratos principales concentran una cuota mediana de 0,56 del peso de la celda— y con α=0,60 el PPS tiene una mediana de 165 contratos por día como unidades seguras. Es decir, la vía «el PPS fija la media ponderada agarrando los contratos de cabeza» está abierta también en mi población, y aun así perdió. Las celdas con poco peso total reciben también pocas extracciones, así que sus medias LW se sostienen con un puñado de muestras; la asignación de celdas iguales da un suelo a cada celda y añade según la dispersión, y la cobertura misma se convierte en precisión. La descomposición por celda apoya esta lectura (α=0,60): con PPS, la celda más fina recibe de media solo 9,9 extracciones, con un error LW de celda de 152 pb; la más gruesa, 59 extracciones y 15 pb: una dispersión de extracciones de unas 6 veces entre celdas. La asignación de celdas iguales comprime las extracciones entre 23,6 y 48,7, con un error de la celda más fina de 37 pb. Y esta «derrota» no es una ilusión de la estimación puntual: emparejando día a día los RMSE de celdas iguales y PPS en un bootstrap por clústeres de días completos, los ratios celdas iguales/PPS en los cuatro α son 0,89 / 0,90 / 0,93 / 0,84, con intervalos del 95 % de [0,86, 0,92], [0,87, 0,94], [0,89, 0,97] y [0,80, 0,88], ninguno de los cuales contiene el 1. También me autoinspeccioné primero en la implementación: en el objetivo LW, los cuatro diseños se puntúan con la misma muestra bajo el estimador de razón HT; muestreo y puntuación son dos elecciones independientes. Los diseños estratificados muestran ratios casi idénticos en ambos objetivos (diferencias de 0,00–0,03) precisamente porque sus asignaciones no dependen del objetivo: la misma muestra, repuntuada con otro peso de normalización. Solo el PPS, cuyas probabilidades de inclusión se generan directamente desde w, se voltea con el objetivo. En el corpus de NVDA, la precisión dentro de celda del PPS global resulta ser lo bastante alta para que la ventaja de la identidad se cobre como primer puesto total; eso es la distribución del corpus allanando la brecha de nivel, no un contenido de la propia identidad. Dicho llanamente: pese el objetivo como quiera; asigne el presupuesto en el nivel en el que puntúa la métrica. Cuando la puntuación pondera las celdas por igual, la asignación en el nivel de celda es el diseño que está en el nivel del objetivo. Esto no depende de ningún corpus concreto; lo fija la estructura del protocolo. Las condiciones de la distribución mueven el tamaño de la brecha, no este juicio estructural.
Esta es también la postura metodológica más aprendible del artículo: los autores escribieron «by construction» a la vista, lo que equivale a dejar a los lectores una interfaz falsable. Mi reprueba simplemente usó esa interfaz.
La parte de los relojes: colas más finas, agrupamiento intacto
El segundo protocolo del artículo son los relojes de actividad: las barras no se cortan por minutos fijos, sino por volumen o por volumen en dólares, con umbrales calibrados causalmente sobre la media móvil de los últimos 60 días de negociación. Según los autores: bajo una expansión de precio de 18,9× entre pico y valle, los relojes móviles de volumen/dólares mantienen unas 7,5–9,0 barras por día (base de rendimientos interiores 7,49 / 7,99; base de muestra completa 8,49 / 8,99), la curtosis en exceso interior se comprime a 1,83 / 2,49 (barras temporales 5,00; estandarizado por estacionalidad intradía 5,09); pero la autocorrelación de primer orden de los rendimientos al cuadrado se queda en 0,170 / 0,215: el agrupamiento no se mueve; y la precisión de dirección de la barra siguiente es del 48,6–51,0 %, sin que tampoco aparezca alfa de la nada.
Reprobé sobre un proceso intradía sintético de 320 días de negociación (estacionalidad intradía en U, varianza por minuto GARCH(1,1), choques t5, saltos, expansión de precio de 8,6×; los primeros 60 días calibran y el resto se puntúa con el protocolo móvil de 60 días). Antes, un episodio que declarar: en la primera versión de la población puse el acoplamiento de volumen demasiado fuerte: los días de volumen extremo empujaban los umbrales móviles tan alto que un día típico solo cortaba unas 4 barras, y el proceso ni siquiera contenía agrupamiento intradía que medir. Esa versión se descartó antes de cualquier veredicto —con fundamento en comprobaciones de validez previas a cualquier juicio sobre relojes (¿es sensata la distribución de volumen?, ¿existe agrupamiento?, ¿está la tasa de barras en una magnitud puntuable?)— y los cambios tocaron solo los parámetros de la población (acoplamiento con tope, GARCH añadido); todo el episodio consta en acta. Los resultados revisados:
- Tasa de barras: volumen móvil 9,40 ± 3,20 barras/día, medias por tramo 10,1 / 9,1 / 9,7, pegadas al objetivo (8,75 es la frecuencia objetivo que prefijé para esta población sintética; la constante del artículo, calibrada en su propio panel de 967 sesiones, es 8,273, y el mecanismo de umbral causal móvil de 60 días se conserva tal cual); dólares móviles 11,28 ± 4,67, tramos 12,3 / 10,8 / 11,6, sin tendencia temporal, pero asentados unas tres décimas por encima del objetivo (primera reserva). En el grupo de control, el umbral estático de dólares sube en la misma ventana de unas 15 a unas 53 (en total 30,41 ± 18,29): la calibración móvil estabiliza la tendencia, no el nivel.
- Curtosis: primero la agregación agrupada que reporta el artículo —volumen móvil 0,69 (intervalo de bootstrap por clústeres de días [0,15, 1,54]), dólares móviles 0,55 ([0,27, 0,81]), frente a barras temporales 8,73 y estandarizado intradía 6,83 ([3,02, 11,22])—; las diferencias de curtosis agrupada de ambos relojes móviles frente al control intradía son −6,14 y −6,29, con intervalos que excluyen el 0: la compresión agrupada se sostiene; en el último 40 % de días reservado, ambos relojes móviles quedan muy por debajo de los controles (0,41 / 0,56 frente a 12,64 / 8,18). Pero la agregación por día se divide: la diferencia diaria del volumen es −0,13 ([−0,22, −0,04]), en apoyo; la de los dólares es +0,13 ([+0,02, +0,23]), en sentido contrario. Así que «colas más finas» es una conclusión válida en ambas agregaciones para el reloj de volumen, y solo en la agregación agrupada para el de dólares (segunda reserva).
- Agrupamiento y dirección: la autocorrelación agrupada de primer orden de los rendimientos al cuadrado es positiva bajo los seis relojes (0,05–0,18); ningún reloj la lleva a cero. La precisión de dirección de la barra siguiente es 0,493–0,510, solapada con la banda de azar del artículo. Aclaremos el peso de este punto: mi proceso tiene media condicional cero por construcción, así que la dirección es impredecible en principio; lo que esta comprobación examina no es si un reloj puede crear predictibilidad de la nada, sino si la transformación del reloj fabrica predictibilidad espuria: no lo hace.
La conclusión coincide con la de los propios autores: los relojes de actividad son una herramienta de conformación de la distribución incondicional, no una solución para la dinámica de la volatilidad, ni una fuente de señal. Quien lea la baja curtosis de una barra de volumen como «el riesgo ha desaparecido» ha confundido la conformación con la eliminación.
Lo que no probé: la honestidad reportada de los autores
Hay dos partes del artículo que no toqué, y constan aquí para que el lector conozca su peso (todo según los autores):
En el muestreo longitudinal de ventanas de entrenamiento, PPS y Neyman con α=0,60 retienen más ventanas de volatilidad de cola (retención del decil superior 81,2 % / 73,7 % frente a 59,9 % del SRS), los tres diseños son equivalentes al entrenamiento completo dentro de un margen TOST prefijado y se ahorra un 21–22 % de tiempo de cómputo; pero los autores reportan también que la ganancia predictiva incremental de los diseños informativos sobre el SRS no está establecida (pruebas emparejadas p ≥ 0,608): el muestreo ahorra cómputo, no precisión.
La parte de predicción es el caso clásico: HAR-IV registra una habilidad MSE agrupada de +21,0 %, el LSTM de nivel 2 un +17,2 % sin ganar a HAR-IV (prueba DM por clústeres p=0,61). Los propios autores dan el registro de concentración: los 5 primeros días de negociación aportan el 144–157 % de la mejora neta del error cuadrático, la prueba por clústeres de días contra la referencia de persistencia no es significativa (p=0,34) y la persistencia gana en el 57,3 % de los días. Extraer el +21 % y difundirlo por sí solo es malinterpretar este artículo: los autores imprimieron la salvedad en la misma página que la cifra.
Cuatro reglas para llevarse
- Escriba primero el objetivo, luego elija el diseño. Una superficie de celdas iguales, una media poblacional y una superficie ponderada por liquidez son tres estimandos distintos, que corresponden respectivamente a la asignación de celdas iguales, de Neyman y PPS; el diseño equivocado puede duplicar el error (en mi caso 1,66–2,03×; en el artículo, 2,47–3,90×).
- La cobertura es una métrica dura (cobertura de celdas). Si el objetivo es una magnitud por celda, cualquier diseño que no garantice la cobertura de celdas debe pasar primero la barrera de la cobertura; que el muestreo probabilístico global deje hambrientas a las celdas finas es el modo de fallo más común de una «ventaja constructiva».
- Alinee en el nivel en el que se puntúa. La alineación constructiva es contrato a contrato (π ∝ w es una identidad); si la puntuación pondera las celdas por igual, la asignación del presupuesto debe hacerse en el nivel de celda: una pasada global por peso no está en el mismo nivel que una puntuación de celdas iguales, y lo de «imbatible» no tiene donde apoyarse. Las condiciones de la distribución fijan el tamaño de la brecha, no este juicio estructural.
- Conformar no es eliminar (tail shaping, not elimination). Los relojes de actividad comprimen la curtosis y estabilizan las tasas de barras, pero no mueven el agrupamiento de volatilidad ni producen señales de dirección; al evaluar cualquier método que «dome colas», pregunte primero si actúa sobre la distribución incondicional o sobre la dinámica condicional.
Nota de evidencia y replicación: las cifras de primera mano de este artículo proceden de dos ejecuciones con protocolo congelado sobre poblaciones sintéticas (población de cadenas de opciones: 200 días, semilla 20261103; proceso intradía: 320 días, semilla 20261104), con el protocolo reimplementado desde las especificaciones impresas en los §3.1–3.2 y §5 del artículo; los parámetros del brazo de cadenas quedaron congelados antes de cualquier comparación, y la especificación final del brazo de relojes se congeló tras una calibración piloto (el descarte de la v1 consta en acta) y no se volvió a cambiar antes de la comparación final. Los recibos completos, una correspondencia afirmación por afirmación y el código son públicos en github.com/vxime/iv-surface-sampling-replication (verificables vía SHA256SUMS). El brazo del corpus real de OptionsDX no se ejecutó —ese corpus se obtiene mediante la cuenta y el proceso de pago de la tienda del proveedor, que no fue autorizado para esta auditoría—, así que este artículo no afirma ninguna replicación con corpus real. Las cifras del artículo (Bastola y Prushansky, arXiv:2610.33438v1) son todas según sus autores, y sus partes de equivalencia longitudinal y de predicción no fueron reprobadas por mí. Este artículo trata solo de metodología de muestreo y evaluación y no constituye asesoramiento de inversión.