Por qué una réplica fiel de SAE tampoco llegó a producir esparsidad
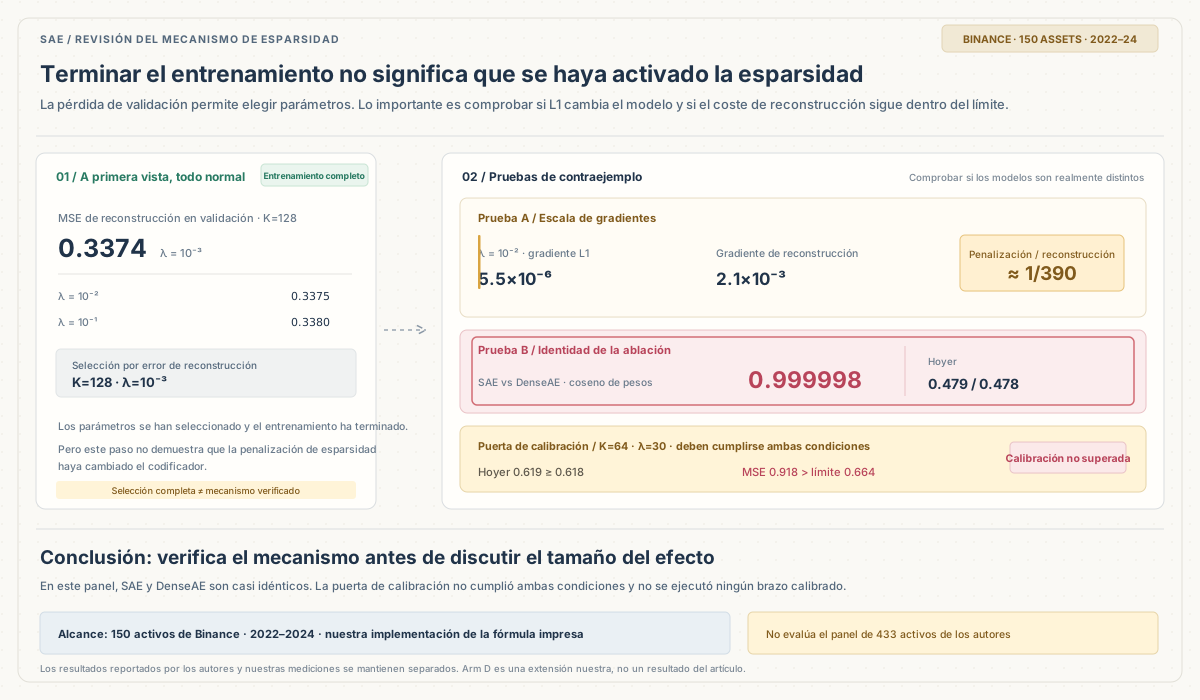
Cuando terminó de entrenarse el primer modelo de control, comparé los pesos del SAE con los de su control denso (DenseAE, λ=0). Los pesos están ligados: el encoder y el decoder comparten los mismos parámetros. La similitud coseno de esos pesos fue 0.999998. Dicho de otro modo, el modelo con penalización de esparsidad y el modelo sin ella eran, en la práctica, el mismo modelo. La esparsidad de Hoyer (escala de 0 a 1; cuanto más alto el valor, más disperso) fue 0.479 frente a 0.478. Al agregar los cinco folds, ambos tuvieron un IC de predicción de +0.0073 y los resultados de cartera fueron casi idénticos.
No esperaba encontrarme con esto en la primera comparación. En el artículo que intentaba reproducir, la esparsidad es el motor de toda la explicación: la penalización L1 debería volver suficientemente dispersos los códigos y, por eso, los cestos elegidos por el ranking de reconstrucción deberían estar menos correlacionados entre sí y tener menor volatilidad. Si la esparsidad ni siquiera aparece, que las cifras posteriores se parezcan no valida el mecanismo del artículo.
Este texto documenta todo el proceso de réplica: qué coincidió, qué no y, sobre todo, hasta dónde apuntan las pruebas para explicar las diferencias.
Qué afirma el artículo y qué nivel de evidencia tiene cada afirmación
El trabajo de Han y Qu (University of Washington) fue aceptado en ICAIF ‘26. La pregunta es concreta: alimentar rendimientos transversales diarios a un Sparse Autoencoder de una sola capa, ordenar los activos por sus valores reconstruidos y formar carteras contrarias por quintiles. ¿Baja el riesgo debido a la esparsidad en sí?
Los autores separan sus resultados principales en tres niveles. La distinción importa:
- Confirmado estrictamente: tras seleccionar de antemano K=128 y λ=0.1 con los primeros 748 días, las cestas SAE tuvieron una volatilidad en escala rank entre un 20 y un 26% menor que PCA con el mismo K en los cinco folds de confirmación.
- Exploratorio: con K=64, la volatilidad fue un 32–37% menor (20.0% frente a 27.3% en escala money). Pero la ventana de selección se solapó con los primeros folds de prueba, así que solo es evidencia exploratoria. El mecanismo propuesto fue una menor correlación media por pares dentro de las cestas: 0.008 frente a 0.039 para PCA.
- Rechazado explícitamente por los autores: SAE no añadió Sharpe frente a la línea base más sencilla de reversión del mismo día (diferencia de −2.48 en escala money); la identidad de los factores no se reprodujo entre seeds aleatorias (coseno de matching del decoder 0.13 frente a una referencia de diccionario aleatorio de 0.117); y un overlay de mínima varianza Ledoit–Wolf recuperó alrededor del 73% de la ventaja de volatilidad de SAE frente a la línea base naive.
Los autores también reconocen tres límites: las señales se forman al cierre del día t y se ejecutan a ese mismo cierre, algo que califican de “no ejecutable en la práctica”; no se incluyen costes en ningún punto; y la selección del universo cripto usa información de todo el periodo, no es point-in-time. Hay otra omisión importante: a fecha de 2026-11-01, ni el artículo ni su página de arXiv enlazaban código, y tampoco se publicó la lista exacta de los 433 activos. Por tanto, cualquier réplica debe reimplementar el protocolo impreso y el panel necesariamente será distinto. Eso determina el alcance de mi conclusión: pruebo si las afirmaciones se transfieren, no si el experimento de los autores en su propio panel fue correcto o incorrecto.
Mi configuración de réplica: primero, las diferencias
Usé velas diarias spot USDT de Binance a través de la API pública. No hizo falta cuenta ni clave API. La regla para congelar el universo se fijó antes del entrenamiento: de 519 pares listados actualmente, 285 tenían datos en la ventana 2022–2024; 245 superaban el requisito de al menos 252 días observados. Después seleccioné los 150 activos con mayor mediana de volumen diario cotizado. La lista y su hash se guardaron antes de entrenar. Cada día había entre 89 y 150 activos elegibles, con una media de 119.
Las diferencias frente al artículo quedan explícitas: 150 activos en lugar de 433 y un subconjunto de mayor liquidez; 2022–2024 en vez de 2019–2024; y una lista construida a partir de pares que siguen negociándose hoy, lo que introduce sesgo de supervivencia. El artículo conservó activos deslistados hasta su última cotización. El filtro de supervivencia reduce sistemáticamente la volatilidad de este panel, y la volatilidad es precisamente la comparación central del texto. No es posible reconstruir el tamaño de ese sesgo: los activos deslistados ya no aparecen en la lista actual de negociación y no se pueden contar desde esta fuente. El procesamiento del panel sigue el artículo: winsorización diaria transversal 1/99%, forward-fill de faltantes durante un máximo de tres días y posterior enmascaramiento, y transformación rank inverse-normal recortada. La ventana de selección usa los primeros 500 días de rendimientos (450 de entrenamiento / 50 de validación). Los parámetros se eligen solo por el error de reconstrucción de validación, dentro de K∈{32,64,128} × λ∈{10⁻³,10⁻²,10⁻¹} × la cuadrícula de learning rate. Después vienen cinco folds expanding walk-forward, cada uno con 119 días de señal. Se excluye el último día de señal de cada fold porque necesita el rendimiento del día siguiente para calcular PnL; quedan 590 días de evaluación. Las carteras son quintiles contrarios ordenados por reconstrucción, con igual ponderación y gross 1 por cada leg. Los rendimientos t+1 ausentes se tratan como cero. Estas decisiones coinciden con el artículo.
También preregistré dos puertas. La condición de parada es sencilla: si la dirección de la volatilidad no se reproduce en el universo reducido, se informa honestamente como non-replication. No se amplía el universo ni se ajustan parámetros hasta conseguir el signo deseado. La puerta de calibración permite un brazo adicional dentro de la ventana de selección solo si el diagnóstico muestra que λ no ha tenido efecto: se puede elegir un λ que cumpla “objetivo de esparsidad alcanzado y coste de reconstrucción controlado”. Si ningún valor cumple ambas condiciones, no se ejecuta el brazo. Tampoco se permite cambiar la regla después de mirar el conjunto de prueba.
El primer problema: λ es inerte en este panel
Empecemos por la selección de parámetros. En K=128, el MSE de reconstrucción de validación es casi plano frente a λ: 0.3374 con λ=10⁻³, 0.3375 con 10⁻² y 0.3380 con 10⁻¹. La configuración estricta elegida por la regla es K=128, λ=10⁻³. En el panel de los autores se eligió el mismo K, pero con el λ más fuerte, 0.1. La misma regla de selección produjo preferencias opuestas sobre la intensidad de la penalización en los dos paneles. Elegir solo por error de reconstrucción favorece estructuralmente la penalización más débil, porque L1 solo puede dificultar la reconstrucción. Por eso mi elección de 10⁻³ era casi inevitable bajo esa regla. En cambio, el artículo dice que, con la misma regla declarada, eligió el valor más fuerte, 0.1. Conviene dejar constancia de esa tensión: quizá una penalización fuerte no perjudicó la reconstrucción en su panel, o quizá hubo partes del proceso de selección que no se describieron.
La medición del gradiente es más directa. Con λ=10⁻², la configuración exploratoria del artículo, la magnitud media del gradiente de pesos del término L1 fue 5.5×10⁻⁶, frente a 2.1×10⁻³ para el término de reconstrucción. La penalización es solo alrededor de 1/390 del término principal; no están en la misma escala. En un diagnóstico separado —reentrenado con los primeros 500 días y evaluado en la ventana del primer fold— elevé λ a 1.0 como prueba de estrés, cien veces el 10⁻² exploratorio del artículo. Aun así, Hoyer solo pasó de 0.474 a 0.514. El modelo seguía sin ser realmente disperso.
Ningún λ superó la puerta de calibración. En un barrido de λ∈{0.3,1,3,10,30} (configuración K=64 dentro de la ventana de selección), Hoyer subió de 0.483 a 0.619 y se saturó, mientras que el MSE de validación pasó del 0.554 de DenseAE a 0.918, un aumento del 66%. Mi regla exigía que Hoyer superara a DenseAE en al menos 0.15 y que el MSE no excediera 1.2 veces el valor denso. Con λ=30, Hoyer 0.619 apenas supera el umbral 0.618 (DenseAE vale 0.468 en esta medición, más 0.15). Pero MSE 0.918 es aproximadamente 1.4 veces el límite permitido de 0.664. Según la regla preregistrada, no se ejecutó el brazo de calibración. Sin embargo, “dosis insuficiente” solo explica la mitad. Con el mismo protocolo, el gradiente de la penalización a λ=30 ya era unas 7.7 veces el gradiente de reconstrucción. La dosis era más que suficiente, pero Hoyer se saturó alrededor de 0.62 y la reconstrucción se rompió primero. En este panel, los λ del rango del artículo son inertes; fuera de ese rango aparece otro techo. Con estos datos, parece difícil hacer los códigos mucho más dispersos sin sacrificar la calidad de reconstrucción. La causa concreta de ese techo no se midió, así que queda sin resolver.
¿Por qué la misma ecuación y la misma cuadrícula de λ pueden reducir la correlación dentro de las cestas a una quinta parte en el panel del artículo y aquí ni siquiera cambian el modelo? La parte medida está clara: la escala relativa entre el gradiente de la penalización y el de reconstrucción. A partir de ahí hay una inferencia, y marco su límite. La intensidad relativa de L1 depende de la escala típica del código, que cambia con el número de activos y la estructura transversal. El artículo usa 433 activos de 2019–2024; mi panel tiene 150 activos líquidos de 2022–2024. λ=0.1 puede ser una dosis efectiva en su escala y actuar casi como un placebo en la mía. Tampoco puede descartarse otra explicación: detalles de implementación no publicados podrían hacer que el efecto real de la penalización difiera de la ecuación impresa. Por ejemplo, el entrenamiento por minibatches o la convención de reducción de la función de pérdida. Las ecuaciones impresas no especifican si el término de reconstrucción se suma o se promedia sobre N activos, ni si el término L1 se suma o se promedia sobre K dimensiones ocultas. Solo la combinación de esos denominadores podría introducir una escala implícita de cientos de veces en la penalización efectiva. Sin código oficial, esta posibilidad queda abierta; no sirve para sacar conclusiones sobre los autores.
Hay un punto que no depende de esas inferencias: con una implementación estándar fiel a las ecuaciones impresas, los λ del artículo no son constantes que puedan trasladarse a otro panel sin calibración. Quien aplique λ=0.1 directamente a sus datos y después informe del “efecto de diversificación de SAE” quizá esté describiendo un mecanismo que nunca llegó a activarse.
De la volatilidad solo queda la dirección; el mecanismo se invierte
Resultados agregados de cinco folds (590 días, escala money):
| Método | Volatilidad anualizada | Sharpe |
|---|---|---|
| Reversión naive del mismo día | 31.39% | +1.69 |
| PCA K=64 | 29.54% | +1.75 |
| PCA K=128 | 30.39% | +1.32 |
| SAE K=64 (λ=10⁻²) | 29.90% | +0.65 |
| SAE K=128 (λ=10⁻³, seleccionado) | 28.97% | +0.96 |
| DenseAE K=64 (λ=0) | 29.96% | +0.65 |
SAE-128 tiene una volatilidad un 4.7% menor que PCA-128 (por fold: −4.0, −4.2, +3.1, −3.0, −10.0; la dirección coincide con el artículo en 4 de 5 folds). Eso equivale aproximadamente a una quinta parte del resultado estricto del artículo, −20–26%. También importa el detalle estadístico: la media de las cinco diferencias por fold es −3.6% (no es lo mismo que el −4.7% agrupado; una cifra promedia folds y la otra agrupa observaciones diarias), con un valor t cercano a −1.7 (n=5). No es significativo. La conclusión posible se limita a dirección y magnitud. K=64 ni siquiera conserva la dirección: la volatilidad de SAE es un 1.2% mayor que la de PCA. A la luz de la sección anterior, no sorprende. El “SAE” seleccionado con λ=10⁻³ es casi denso, así que su pequeña ventaja frente a PCA parece más una propiedad de la reconstrucción de un autoencoder ordinario que un efecto de la esparsidad.
Para mostrar la variación entre folds, estos son los valores de volatilidad anualizada en escala money:
| Método | Fold 1 | Fold 2 | Fold 3 | Fold 4 | Fold 5 |
|---|---|---|---|---|---|
| Reversión naive | 22.12% | 31.31% | 32.00% | 31.37% | 37.93% |
| PCA K=64 | 21.71% | 30.42% | 27.16% | 26.53% | 39.22% |
| SAE K=64 | 20.16% | 30.32% | 30.54% | 30.56% | 35.91% |
| PCA K=128 | 21.65% | 30.88% | 29.05% | 29.51% | 38.26% |
| SAE K=128 | 20.78% | 29.58% | 29.95% | 28.61% | 34.42% |
En el mecanismo, el resultado es aún más claro. Siguiendo la definición del artículo, calculé la correlación media por pares dentro de las cestas en escala rank, con una ventana móvil de 60 días. La cesta larga de SAE-64 fue 0.0215 y la corta 0.0297. PCA-64 fue 0.0201 / 0.0261. La reversión naive fue aún menor: 0.0136 / 0.0148. El artículo informa SAE 0.008 frente a PCA 0.039. En mi panel el orden se invierte. En escala de rendimientos raw, todos los métodos se agrupan entre 0.56 y 0.60 (domina el factor de mercado común), así que tampoco aparece una ventaja de SAE. Solo hay un subresultado en la misma dirección que el artículo: la volatilidad individual de los activos en las cestas SAE es algo mayor que en PCA (0.0478 diaria frente a 0.0466). Es decir, SAE no se limitó a elegir activos más tranquilos, pero los activos elegidos tampoco estaban menos correlacionados.
| Método | Correlación cesta larga | Correlación cesta corta |
|---|---|---|
| SAE K=64 | 0.0215 | 0.0297 |
| PCA K=64 | 0.0201 | 0.0261 |
| Reversión naive | 0.0136 | 0.0148 |
| Artículo: SAE / PCA | 0.008 / 0.039 | 0.010 / 0.044 |
Mi lectura de la primera afirmación del artículo es esta: en K=128 aparece parcialmente la dirección, pero no se reproduce la magnitud; K=64 y la afirmación sobre el mecanismo no se reproducen. Esto no refuta el resultado de los autores en su propio panel: el panel, la ventana y la implementación son distintos. Sí muestra que no se debe asumir que la afirmación se puede trasladar entre paneles sin calibración.
Algunas conclusiones del artículo coinciden con mi réplica; otras no
Un aspecto que merece reconocimiento es que los autores no equiparan una reducción del riesgo con Alpha negociable. Informan explícitamente de que SAE no aporta Sharpe incremental, que la identidad de los factores no es estable entre seeds aleatorias y que el IC tampoco mejora. También declaran que la ejecución al mismo cierre no es viable, que no incluyen costes y que la selección del universo no es point-in-time. En mi réplica, la dirección de esos resultados negativos coincide con lo que informan los autores. Pero la separación de esparsidad no se reproduce y el overlay no se puede juzgar limpiamente porque sus detalles de construcción no están especificados.
- Sin Sharpe incremental: la reversión naive tiene un Sharpe money de +1.69, frente a +0.65 para SAE-64 y +0.96 para SAE-128. La capacidad predictiva tampoco mejoró: IC de reversión +0.0073 para SAE-64 frente a +0.0146 para PCA-64 (el artículo informa +0.016 frente a +0.021, con el mismo orden).
- La identidad de los factores no se reproduce entre seeds: el Hungarian matching de tres pares de seeds da cosenos del decoder de 0.217–0.220, frente a una referencia de diccionario aleatorio de 0.198 (percentil 95 de 0.203). Está ligeramente por encima del azar —quizá por una dirección de mercado compartida—, pero lejos de ser “el mismo conjunto de factores”. El artículo informa 0.13 frente a 0.117. Las magnitudes difieren porque cambia el número de activos y la referencia aleatoria, pero la conclusión es la misma.
- La separación de esparsidad no se reproduce: el Hoyer del artículo es 0.497 para SAE frente a 0.303 para DenseAE; en mi caso es 0.479 frente a 0.478. Al comparar los pares se ve dónde está la diferencia: el lado SAE apenas cambia (0.497 frente a 0.479); toda la brecha que falta está en la línea base densa (0.303 frente a 0.478). También medí el motivo: la proporción de códigos exactamente cero es 47.7% en SAE y 47.6% en DenseAE. En este panel, los códigos ReLU ya tienen casi la mitad de ceros sin ninguna penalización. El modelo denso ya es “disperso” por construcción y, por tanto, la diferencia desaparece. Es otra cara del resultado anterior: la separación de esparsidad existe en el panel de los autores, pero no en el mío.
No puedo dar un veredicto limpio sobre el overlay, así que lo registro tal cual. La versión preregistrada usó pesos de mínima varianza Ledoit–Wolf por leg, covarianza de rendimientos raw y escala money. Tras el overlay, la volatilidad subió a 59.96% porque los pesos se concentraron demasiado. Con la implementación en escala rank, la volatilidad fue 8.19 (escala rank, no porcentaje), por debajo de la naive en 8.97 y de las dos variantes SAE. El artículo solo dice que aplica una covarianza LW móvil de 60 días al portafolio naive de quintiles, sin fijar los detalles de construcción. No puedo determinar cuál de mis dos implementaciones, si alguna, es “la de ellos”. Descompuse mi propia construcción: cada leg tiene unos 28 activos y la mediana del número de condición de la covarianza LW de 60 días es aproximadamente 94; la matriz no está mal condicionada. El problema son los pesos: la solución de mínima varianza concentra cada leg en unas seis posiciones efectivas (mediana del peso máximo de un solo activo: 27%). La volatilidad del 59.96% se debe a la concentración de pesos, no a una matriz singular. Este punto sigue siendo inconcluso: los detalles de construcción de mi réplica no se pueden fijar con la información publicada.
Al usar un calendario ejecutable, las rentabilidades desaparecen primero; la volatilidad no cambia
La siguiente sección no está en el artículo. Es una extensión mía, y sus conclusiones no deben atribuirse a los autores.
La evaluación del artículo forma la señal al cierre del día t y la ejecuta a ese mismo precio de cierre. Los propios autores indican que no es ejecutable. Desplacé las mismas cestas a la ejecución al cierre del día siguiente (el primer momento realmente ejecutable en este esquema) y añadí costes estilizados de 10 / 25 bps según el turnover. El turnover diario es de aproximadamente 3.1 (suma de los cambios absolutos diarios de los pesos combinados de las dos patas; el máximo es 4, así que la cartera se reemplaza casi por completo cada día).
| Método | Sharpe bruto mismo cierre | Bruto cierre siguiente | Neto mismo cierre 10 bps | Neto cierre siguiente 25 bps |
|---|---|---|---|---|
| SAE-128 | +0.98 | +0.05 | −2.98 | −10.07 |
| SAE-64 | +0.67 | +0.26 | −3.12 | −9.34 |
| Reversión naive | +1.71 | −0.10 | −1.86 | −9.62 |
Nota: Arm D se recalculó sobre 589 días con las cestas almacenadas (un día menos que el agregado de cinco folds). Por eso el Sharpe al mismo cierre difiere ligeramente de la tabla agregada; por ejemplo, +0.98 frente a +0.96 para SAE-128. La diferencia procede únicamente de ese día.
Retrasar la ejecución un día lleva el Sharpe bruto de los tres métodos cerca de cero. No es sorprendente: la reversión diaria gana dinero el primer día después de formar la señal. Al añadir 10 bps de coste, todos los resultados pasan a ser negativos; con 25 bps, las pérdidas son importantes. Conviene precisar la convención de mercado: las criptomonedas cotizan 24/7 y no tienen subasta de cierre. El “cierre diario” es solo una instantánea en un momento concreto. Por eso, la columna de ejecución al mismo cierre con costes es en realidad la aproximación más cercana a algo ejecutable (todavía habría que descontar la latencia y el deslizamiento reales). La ejecución al cierre del día siguiente importa una convención conservadora del mercado bursátil: mide el límite superior de la brecha de ejecución, no el comportamiento habitual del mercado cripto. La volatilidad apenas cambia entre variantes de tiempo y costes y se mantiene en 28–31%: los costes son un lastre gradual, mientras que el cambio de horario elimina la prima de reversión. Ninguno modifica el nivel de riesgo.
Los autores nunca afirmaron que la estrategia fuera negociable. Esta sección cuantifica el tamaño práctico de la advertencia que sí incluyeron: entre la “evidencia de señal” y una “conclusión negociable” hay todo un conjunto de supuestos de ejecución. Cualquier modelo transversal diario que informe Sharpe con ejecución al mismo cierre debería superar esta prueba antes de hacer afirmaciones más fuertes.
Las comprobaciones que haré primero al revisar artículos de factores con ML
Esta réplica me dejó una lista de comprobación más duradera que el propio resultado principal. El orden también queda fijado:
- Comprobación de identidad de la ablación: apagar el mecanismo que se afirma (aquí λ=0) y comparar pesos, estadísticas del mecanismo (Hoyer en este caso) e indicadores posteriores. Si los modelos son indistinguibles, informar primero de que “el mecanismo no se activó” en vez de discutir el tamaño del efecto. Si hubiera hecho esta comprobación al principio, podría haber evitado buena parte del desvío.
- La línea base más sencilla posible: la reversión naive del mismo día obtuvo el Sharpe más alto o casi más alto en ambos paneles. Un modelo complejo debe superarla antes de seguir.
- El overlay de manual: si un overlay de covarianza puede recuperar la mayor parte de la ventaja, la contribución incremental del modelo se reduce al residuo. En esta ocasión no pude reproducirlo limpiamente, pero la comprobación sigue siendo necesaria.
- Estabilidad entre seeds: reentrenar con seeds distintas, emparejar factores y comparar con una referencia aleatoria. Si no supera esta prueba, “descubrimos factores” solo significa “esta ejecución produjo algunas direcciones”.
Volvamos al 0.999998 del principio. Probablemente sea el número con más información de toda esta réplica. Las ecuaciones, los parámetros y el protocolo de evaluación del artículo se pueden copiar palabra por palabra. Que el mecanismo llegue a activarse no está escrito en el papel; hay que medirlo en el propio panel. Tanto si la volatilidad baja una cuarta parte como si baja un 4.7%, hasta confirmar la esparsidad solo son cifras de un modelo de reconstrucción.
Límite de la réplica y materiales: las conclusiones se limitan al universo reducido (150 activos líquidos, 2022–2024, con sesgo de supervivencia) y a mi propia implementación de las ecuaciones impresas (NumPy, con gradientes comprobados por diferencias finitas). Este artículo no confirma ni refuta los resultados de los autores en su panel de 433 activos de 2019–2024. Los datos son velas diarias públicas de Binance y pueden reconstruirse con las reglas descritas. El código oficial de los autores no estaba publicado al redactar este texto. Las cifras de la publicación se identifican como resultados informados por los autores. Este artículo trata únicamente de métodos de réplica y límites de la evidencia; no es asesoramiento de inversión.
El código de réplica, la lista congelada de activos (con hashes), los resultados por fold y las notas de interpretación son públicos. El paquete incluye SHA256SUMS para verificar cada archivo por separado.
vxime/sae-crypto-factor-replication
Si quieres situar esta réplica dentro de un flujo de investigación cuantitativa más amplio, puedes leer Cómo comprobar si un factor cuantitativo tiene valor y Cómo ajustar de forma segura los pesos de un modelo multifactor. El primero analiza si la evidencia de ranking se sostiene; el segundo trata cómo controlar los cambios de pesos una vez que esa evidencia entra en un modelo.