114 ejecuciones en el mismo nanosegundo: dónde se equivoca la verosimilitud de Hawkes
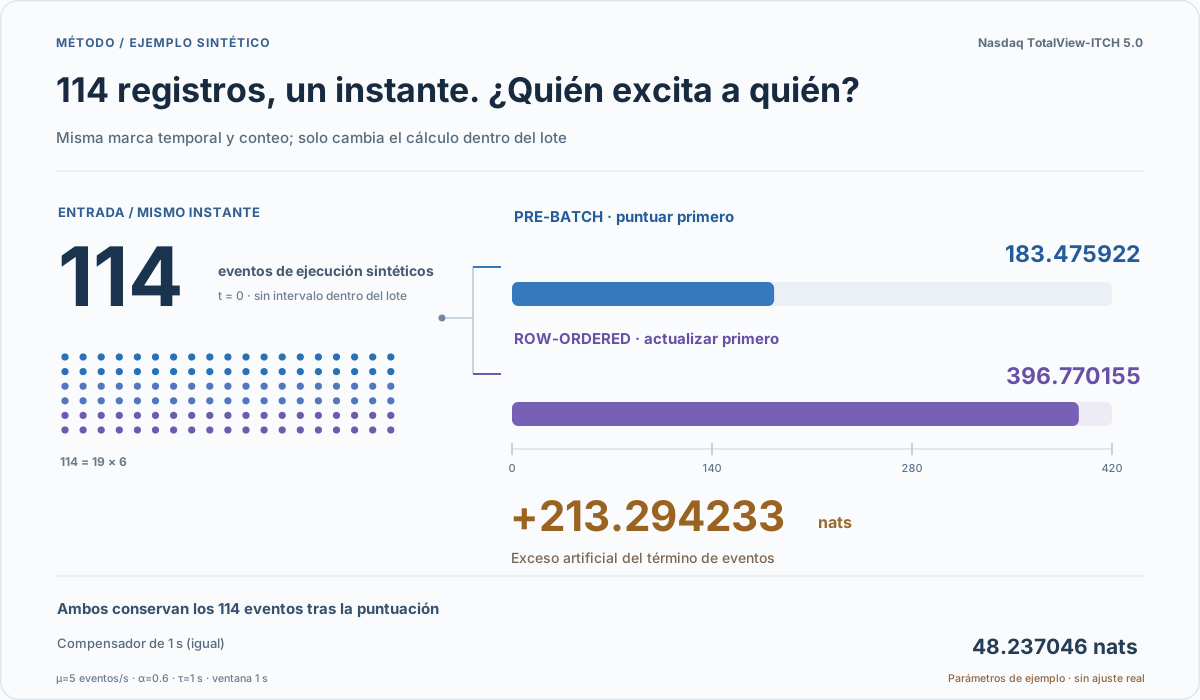
Al ordenar una muestra del flujo de órdenes NASDAQ ITCH apareció una cifra que me hizo desconfiar de un bucle Hawkes convencional, de esos que actualizan el estado después de cada fila: 114.
En la sesión regular de AAPL del 30 de julio de 2019 hay una marca temporal de nanosegundos con 114 registros de mensajes execution. También aparecen una vez lotes de 131 y 187 registros. Más relevante aún: 30,080 de 49,172 mensajes de ejecución (61.17%) comparten la marca temporal con otra fila. Los empates son habituales; los lotes con cientos de registros pertenecen a la cola extrema.
«Evento de ejecución» significa aquí una fila de mensajes ITCH según la definición del estudio, no 114 órdenes distintas ni una prueba de que 114 transacciones ocurrieron simultáneamente en tiempo físico.
El error surge al actualizar la excitación por cada fila. Aunque todas las diferencias temporales registradas sean cero, la fila 114 recibe la excitación de las 113 anteriores. Con una matriz asimétrica entre tipos, incluso el orden de las filas puede cambiar la puntuación. ¿Qué precedencia temporal debe permitirse dentro de una misma marca registrada?
Antes de ajustar parámetros fijamos una convención: agrupar por símbolo y nanosegundo entero; puntuar todo el lote con el historial anterior al lote; y después actualizar el historial con los conteos reales. El orden de transmisión del mercado es información válida, pero no equivale sin un modelo explícito a tiempos físicos inferiores al nanosegundo.
Los empates son frecuentes, pero 114 registros forman un lote extremo
La especificación oficial Nasdaq TotalView-ITCH 5.0 mide la marca de tiempo en nanosegundos desde medianoche. El mensaje E es Order Executed y C Order Executed With Price. Una misma referencia de orden puede tener mensajes de ejecución parcial separados.
En el estudio agrupamos tres clases: add=A/F, cancel_delete=X/D y execution=E/C. Para C se incluyen Printable=Y y Printable=N: no contamos solo operaciones imprimibles. Quedan fuera P (operación de orden no mostrada) y Q (cross trade). Es una definición de modelado, no la clasificación universal de todas las transacciones de Nasdaq.
Este agregado interno corresponde al 2019-07-30, AAPL, 09:30–16:00 hora del mercado de la costa este estadounidense, toda la sesión regular:
| Indicador | Valor observado |
|---|---|
Filas de mensajes execution | 49,172 |
| Marcas de tiempo distintas en nanosegundos | 29,379 |
| Marcas de tiempo con varias filas | 10,287 |
| Filas que comparten marca de tiempo | 30,080 (61.17%) |
| Mediana / moda del tamaño de lote empatado | 2 / 2 filas |
| Lotes empatados de 2–3 filas | 8,439 (82.04% de los lotes empatados) |
| Lote con exactamente 114 filas | 1 |
| Lotes mayores de 131 y 187 filas | 1 de cada tamaño |
Existió otro contraste de días con ventana común 09:30–11:00; sus cifras no deben confundirse con la sesión completa. El histograma guardado revela tamaños de lotes, no identidades de órdenes individuales ni una secuencia física subnanosegundo recuperable.
En los 29,379 tiempos distintos hay una media de 1.67 filas por instante. Solo entre los 10,287 lotes con empates, la media es 2.92, con mediana y moda de 2. Un lote de 114 equivale a unas 39 veces esa media. Solo hay tres lotes de tamaño 114 o superior: 114, 131 y 187. Son excelentes casos límite para detectar el fallo, pero no describen el tamaño habitual.
Que el 61.17% de las filas esté empatado tampoco demuestra por sí solo falta de identificabilidad. La convención pre-batch no utiliza intervalos internos no observados; la separación y mezcla de tipos entre lotes aún aportan información.
A la misma hora, ¿qué evento puede excitar a cuál?
La intensidad condicional de Hawkes con tres tipos y núcleo exponencial se expresa así:
lambda_k(t-) = mu_k(t)
             + sum_j [alpha[k,j] / tau
               * sum_{u<t} m_j(u) * exp(-(t-u)/tau)]
k es el tipo objetivo, j el origen, y m_j(u) el número real de filas del tipo origen en el instante u. La matriz se lee objetivo × origen. mu_k se mide en eventos/s, tau en segundos y alpha[k,j] es la excitación integrada, adimensional, por cada evento fuente. Por tanto, el coeficiente instantáneo es alpha[k,j]/tau (1/s), mientras que la integral incluye alpha.
La desigualdad decisiva es u<t. Bajo la convención pre-batch, el lote actual no puede entrar en su propio historial antes de puntuarse. El término de eventos es:
event_term(t) = sum_k m_k(t) * log(lambda_k(t-))Se calculan todos los lambda_k(t-) con el mismo estado previo, se suman los términos multiplicados por m_add, m_cancel_delete y m_execution, y solo entonces se actualiza el historial una vez. No hay que comprimir 114 filas en un evento. Las pruebas sintéticas incluyen permutar filas del lote, aislar símbolos y reiniciar al cambiar de jornada.
Puntuar por orden de transmisión podría ser otro supuesto de observación, si se define su relación con los tiempos e intensidades. No es una optimización neutra de la misma verosimilitud.
Un ejemplo artificial con 114 filas revela la diferencia
Esto es un contraejemplo didáctico ejecutable con la biblioteca estándar de Python, no una estimación de parámetros de AAPL. Suponemos 114 eventos del mismo tipo en el inicio de la sesión, historial anterior sin excitación, mu=5 eventos/s, alpha=0.6, tau=1 segundo y un segundo posterior de observación.
import math

m, mu, alpha, tau, horizon = 114, 5.0, 0.6, 1.0, 1.0

# Puntuar todo el lote con la intensidad anterior al lote
pre_batch = m * math.log(mu)

# Contraejemplo: las filas anteriores del mismo instante excitan a las posteriores
row_ordered = math.fsum(
    math.log(mu + alpha * i / tau) for i in range(m)
)

# La LL completa resta la integral de intensidad de toda la ventana
baseline_area = mu * horizon
excitation_area = alpha * m * (-math.expm1(-horizon / tau))
compensator = baseline_area + excitation_area

print(f"prebatch_event_log_term: {pre_batch:.6f}")
print(f"row_ordered_event_log_term: {row_ordered:.6f}")
print(f"artificial_excess: {row_ordered - pre_batch:.6f}")
print(f"one_second_compensator: {compensator:.6f}")
print(f"one_second_full_LL: {pre_batch - compensator:.6f}")
La ejecución real en Linux aislado con Python 3.13.5 terminó con código 0 y produjo:
prebatch_event_log_term: 183.475922
row_ordered_event_log_term: 396.770155
artificial_excess: 213.294233
one_second_compensator: 48.237046
one_second_full_LL: 135.238876
Permitir que las filas anteriores dentro del mismo instante registrado exciten a las posteriores añade artificialmente 213.294233 nats al término logarítmico de eventos. Sin embargo, ambos métodos conservan los mismos 114 eventos en el historial tras el lote. Como el lote tiene duración nula, el compensador del segundo posterior coincide: 48.237046 nats. La LL completa del método por filas vale 348.533109, frente a 135.238876 con pre-batch; la diferencia sigue siendo 213.294233 nats.
No es una mejora real de predicción ni una comparación entre dos verosimilitudes exactas del mismo modelo continuo de observación. El método pre-batch tampoco elimina la excitación posterior: un segundo después, bajo estos parámetros artificiales, la aportación a la intensidad propia es 114 × 0.6 × exp(-1) ≈ 25.163 eventos/s.
Sin compensador, el término de eventos no es toda la verosimilitud
Sumar log(lambda) en cada llegada y devolverlo como LL omite la intensidad sostenida durante los intervalos sin eventos. La verosimilitud de un proceso puntual también resta la intensidad integrada sobre toda la ventana de observación válida:
LL = sum_k sum_batches m_k(t) * log(lambda_k(t-))
     - sum_k integral_session lambda_k(t) dt
Antes de ajustar, fijamos la base intradía en 78 intervalos de cinco minutos (390 minutos de 09:30 a 16:00). La integración de base suma el solapamiento exacto de intervalos semiabiertos con la sesión, y el núcleo exponencial integra cada lote con su verdadera multiplicidad:
baseline_area[k] = sum_r mu[k,r] * overlap_seconds(r, session)

excitation_area[k] = sum_j sum_{u in session}
    alpha[k,j] * m_j(u) * (1 - exp(-(end-u)/tau))
La implementación emplea -expm1(-(end-u)/tau) para evitar cancelación numérica en intervalos muy cortos. En el ejemplo artificial de un segundo, el área base es 5, la excitación integrada cerca de 43.237046, y el compensador total 48.237046. La LL pre-batch completa resulta 135.238876, no el término de eventos 183.475922.
¿Qué permite calcular un histograma real con parámetros ficticios?
El ejemplo de 114 filas demuestra el mecanismo. Después usamos solo el histograma de tamaños de lotes execution de AAPL del 2019-07-30, sesión completa, ya almacenado como entrada de multiplicidad para escenarios de parámetros artificiales. No se volvieron a descargar mensajes ITCH ni se ajustó Hawkes con datos reales.
Consideremos únicamente la autoexcitación positiva del tipo execution, y supongamos que la intensidad inmediatamente anterior, lambda^-, es al menos una mu>0 elegida artificialmente. Para un lote de m filas, el incremento inducido al autoexcitar por filas satisface:
0 <= Delta(m) = sum_{i=0}^{m-1} log(1 + alpha*i/(tau*lambda^-))
   <= sum_{i=0}^{m-1} log(1 + alpha*i/(tau*mu))
El lado derecho es una cota superior condicional para el escenario de un solo tipo, no una cota del error de la LL de Hawkes completa con tres clases. Desconocemos la intensidad previa verdadera y no incluimos otros tipos simultáneos.
Para mu=5 eventos/s, ponderar las cotas individuales por sus frecuencias guardadas produce:
| alpha hipotética | tau=0.1 s | tau=1 s | tau=10 s |
|---|---|---|---|
| 0.1 | 8,392.65 | 1,436.32 | 178.46 |
| 0.3 | 17,088.26 | 3,472.79 | 500.41 |
| 0.6 | 25,186.19 | 5,837.61 | 928.45 |
Todas las cifras están en nats; alpha y tau son supuestos. En el escenario central mu=5, alpha=0.3, tau=1, la cota condicional acumulada es 3,472.79 nats o 0.0706 nats por registro al dividir entre los 49,172 registros. Un lote típico de 2 o 3 filas aporta como máximo 0.0583 o 0.1716 nats, respectivamente. Al cambiar el suelo artificial mu a 1 o 20, las sumas pasan a 11,044.42 y 1,125.70 nats.
Las nueve combinaciones dan cotas de 178.46–25,186.19 nats, equivalentes a 0.00363–0.51221 nats/registro. Nada de ello revela el error efectivo de la LL de AAPL ni parámetros ajustados al mercado.
Al excluir los lotes mayores del escenario central:
| Lotes más grandes excluidos | Reducción de la cota (nats) | % de la cota original |
|---|---|---|
| 187 filas (top 1) | 321.54 | 9.26% |
| 187, 131, 114 filas (top 3) | 665.62 | 19.17% |
| Los 10 lotes mayores | 1,123.57 | 32.35% |
Los tres lotes principales reúnen solo 432 registros, pero concentran casi una quinta parte de esa cota hipotética concreta. El histograma guardado no conserva la hora intradía de esos lotes, por lo que no cabe atribuirlos a la apertura, el cierre, el mecanismo de cruce ni la codificación temporal.
Este análisis y la reconciliación del histograma tienen una tanda independiente de 13/13 pruebas aprobadas; las 99 pruebas sintéticas descritas a continuación pertenecen a otra ejecución.
Qué se comprobó realmente en las 99 pruebas
El agregado de AAPL demuestra que existen registros con la misma marca y cuál es su tamaño. Los experimentos sintéticos de parámetros conocidos verifican si el código respeta el contrato de puntuación por lotes, actualización e integración. Son clases distintas de evidencia.
| Grupo de pruebas sintéticas | Qué se verificó |
|---|---|
| Puntuación por lotes (10) | Intensidad previa común, multiplicidades reales e invariancia ante permutaciones |
| Verosimilitud completa (33) | Compensadores de base y núcleo exponencial; integración analítica y numérica |
| Contratos M0/M1/M2 (34) | Poisson homogéneo, NHPP estacional de 78 tramos y Hawkes de tres tipos con parámetros conocidos |
| Flujos sintéticos (22) | Ogata thinning con semilla fija, suma histórica independiente, determinismo entre procesos |
| Total | 99/99 pruebas de investigación superadas (Python 3.13.5, Linux x86_64 aislado) |
Un caso de estrés construido expresamente tiene 209 eventos sintéticos en cuatro grupos temporales: 90 Add al comienzo, 114 Execution en +1 s, 3 Cancel/Delete en +2 s y, en +3 s, un Add y un Execution juntos. Los tamaños son 90/114/3/2. La desviación absoluta máxima frente a una suma de historial e integración escrita de manera independiente fue aproximadamente 1.42e-14; invertir el orden de entrada no cambió el resultado.
Otros dos flujos sintéticos continuos generados mediante Ogata thinning tienen 285 y 265 eventos. La máxima diferencia frente al cálculo independiente de verosimilitud fue aproximadamente 7.11e-15. Esas simulaciones no generaron naturalmente 114 empates exactos: el lote grande se construyó como prueba de estrés.
Las 99 pruebas se ejecutaron anteriormente en Python 3.13.5 sobre Linux x86_64 aislado. No son un PASS de GitHub Actions del HEAD editorial actual. No existen todavía un ajuste real de parámetros, una evaluación fuera de muestra ni evidencia de que Hawkes supere al NHPP estacional.
La convención pre-batch es una puntuación de trabajo
En un proceso puntual continuo simple, las llegadas exactamente simultáneas normalmente tienen probabilidad cero. Las marcas ITCH son tiempos observados/codificados con resolución de nanosegundos; conocer el orden transmitido no implica observar el orden físico más fino. Por eso la verosimilitud de trabajo pre-batch (o puntuación de pseudoverosimilitud) es una convención explícita, no la densidad conjunta exacta derivada para datos de tiempos cuantizados. Tampoco debe llamarse sin más composite likelihood sin definir densidades componentes y dependencias.
Si interesan los conteos de intervalos fijos, cabe estudiar un modelo discreto de conteos; si se quieren inferir las llegadas ocultas dentro del intervalo, hace falta especificar censura por intervalos. Alterar el orden de pequeños lotes sirve como análisis de sensibilidad, no como sustitución automática.
Una identidad algebraica evita otra confusión: con los mismos datos, grupos y modelo de observación, si dos candidatos omiten la misma constante C(D) independiente de los parámetros, (LL_A+C(D))-(LL_B+C(D))=LL_A-LL_B, así que se cancela en la diferencia. En determinados modelos discretos, -sum log(m!) puede ser un término así. No mantiene inalterada la LL absoluta ni convierte la puntuación pre-batch en una verosimilitud exacta por añadir un factorial. Con grupos o tiempos diferentes tampoco tiene por qué ser la misma constante.
Además, un contraste clásico de razón de verosimilitudes chi-cuadrado no es automáticamente válido: los parámetros de excitación están restringidos a ser no negativos y, bajo la hipótesis nula, algunos de decaimiento pueden no identificarse.
Cómo revisar residuos cuando hay empates exactos
Si interpretamos las 114 filas con la misma marca como 114 llegadas ordenadas, aparecen numerosos intervalos de duración cero y el diagnóstico por reescalado temporal se distorsiona. Nuestro protocolo forma residuos por marcas de tiempo únicas dentro de cada tipo, conservando por separado la multiplicidad del lote. Los gráficos QQ, la autocorrelación residual y las distancias KS describen discrepancias; los p-valores KS usuales que suponen llegadas continuas sin empates no cuentan como inferencia formal aquí. Un futuro bootstrap o test de permutación deberá fijar antes su nula, generador y unidad de remuestreo que preserve la dependencia entre filas del batch.
Antes de escoger parámetros Hawkes vistosos, hay que impedir que el orden de filas del fichero se convierta silenciosamente en tiempo causal.
Materiales publicos de reproduccion: Scripts Python, histograma, pruebas y sumas SHA-256.