De 16K a 128K, la ganancia de la memoria del agente se reduce de +18 a +6: replicación de un subconjunto de EvoMemBench y anatomía del coste en tokens
Cada vez hay más sistemas que añaden memoria a un agente, y todos dicen que se vuelven más listos cuanto más se usan. Pero hay una pregunta que rara vez se responde de frente: la ventana de contexto también está creciendo. Si el modelo puede leer cada vez más cosas de una sola vez, ¿cuánto vale la memoria guardada de antemano?
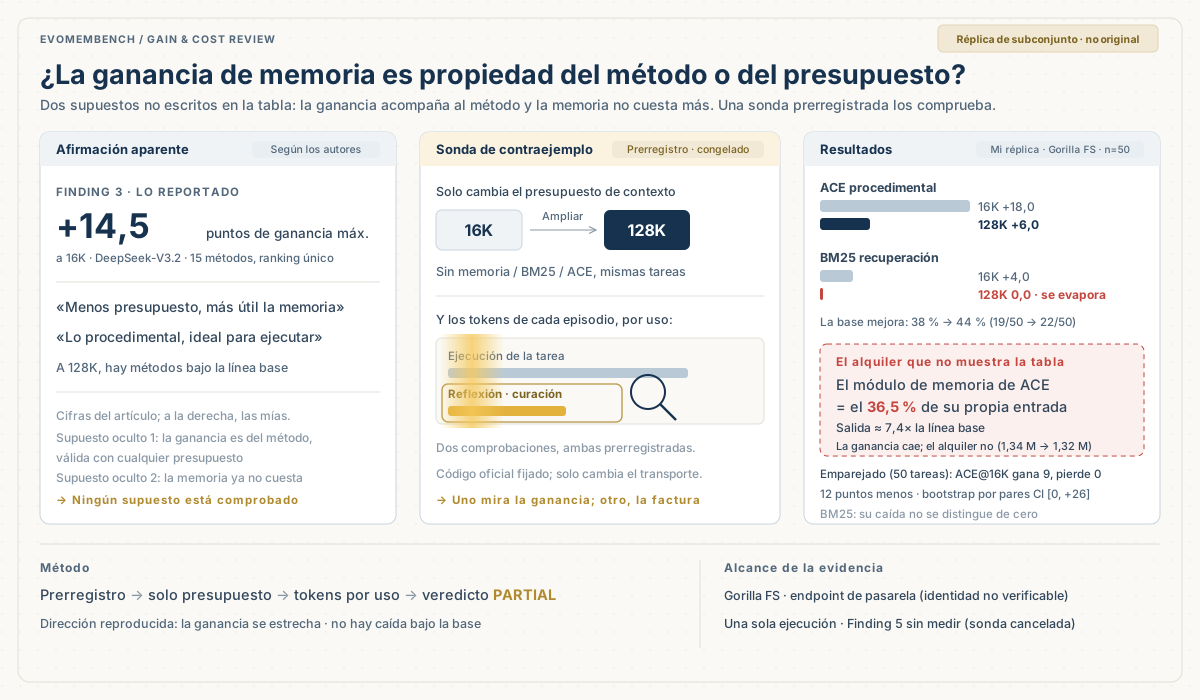
EvoMemBench le pone una cifra a esa curva. Coloca 15 métodos de memoria bajo un mismo protocolo de evaluación y reporta que, al ampliar el presupuesto de contexto de 16K a 128K, la mejor ganancia de los métodos de memoria frente a la línea base sin memoria se reduce de +14,5 a +8,5 puntos, y que a 128K ya hay métodos de memoria que caen por debajo de la línea base sin memoria.
Lo que me interesa es si esa curva se mantiene al cambiar de modelo base, sobre todo al más barato de la gama. La razón es práctica: un experimento de esta magnitud (a 128K hay que reproducir contextos largos una y otra vez) es imposible de pagar a precio de buque insignia; al elegir modelo base, el precio descarta una ronda entera antes de empezar, y en los escenarios de despliegue que me importan, el volumen también corre sobre la gama barata. Así que no repliqué el montaje completo del artículo, sino que prerregistré una pregunta reducida: en la gama GPT más barata disponible en la pasarela, y dentro de un único entorno de ejecución, ¿sigue existiendo la dirección en la que la ganancia se estrecha al crecer el presupuesto?
Anticipo la conclusión: la dirección está. La mejor ganancia que obtuve se reduce de +18,0 puntos a 16K a +6,0 a 128K, y los dos métodos de memoria se estrechan en la misma dirección. Pero la escena más afilada del artículo —la memoria cayendo por debajo de la línea base a 128K— no apareció: la ganancia de la memoria de recuperación simplemente se puso a cero, y la memoria procedimental se mantuvo por encima de la línea base. La valoración compuesta es PARTIAL; los límites de la evidencia están al final del texto.
Primero, separar los niveles de evidencia
Este artículo (arXiv:2605.18421, Universidad de Ciencia y Tecnología de Hong Kong en Guangzhou y otras instituciones) publicó su v1 en mayo de 2026 y se actualizó a la v3 el 30 de octubre; no es un artículo nuevo. Lo que hace es fijar un sistema de coordenadas para la pregunta «¿ayuda realmente la memoria de un agente?»: un eje es el alcance de la memoria (dentro de una misma tarea / entre tareas), el otro es el tipo de contenido (conocimiento / ejecución), lo que da cuatro cuadrantes; los seis conjuntos de datos suman, según su Table 2, 2.954 muestras de evaluación repartidas entre los cuatro cuadrantes; 15 métodos de memoria se agrupan en seis familias y se comparan con líneas base de contexto largo bajo un protocolo unificado. Hay una condición que debe acompañar siempre: todos los métodos de memoria del artículo comparten un mismo modelo base, DeepSeek-V3.2; su ranking es el ranking bajo ese modelo base, y hablar de rankings sin el modelo base no tiene sentido.
De las ocho conclusiones del artículo, las que guardan relación directa con este texto son tres y media. Las líneas base de contexto largo siguen siendo muy fuertes y encabezan la retención y la revisión de conocimiento (Finding 1); el cuello de botella de la memoria está en la revisión y no en la recuperación: los métodos saben guardar la información, pero no saben cambiar el conocimiento antiguo cuando cambia la evidencia (Finding 2); un nivel más hondo, el cuello de botella es convertir la información guardada en conocimiento reutilizable, y no simplemente guardar más (Finding 6); la memoria procedimental es la que mejor encaja con las tareas de ejecución (Finding 4); y está la inversión por dificultad: en las tareas fáciles la memoria aporta una ganancia negativa, y en las difíciles solo la memoria consigue puntuar (Finding 5). Esa media conclusión no pude medirla; el motivo se explica al final.
Todo lo anterior es lo declarado por los autores. Mi replicación tocó solo una de esas conclusiones: la curva ganancia–presupuesto del Finding 3, y solo en un entorno de un cuadrante.
Mi diseño de replicación: el modelo base más barato, una sola curva
Este experimento se prerregistró; todos los ajustes quedaron fijados antes de empezar, como sigue. El subconjunto es InEp-Exec (tareas de ejecución dentro de un mismo episodio) de los cuatro cuadrantes, y de él solo ejecuté un entorno, Gorilla File System: un conjunto de tareas de llamadas a herramientas en varios turnos, cuyo éxito o fracaso determina el verificador integrado en el runner oficial, sin necesidad de un juez adicional. Tres brazos: A0, la línea base sin memoria; A1, la memoria de recuperación BM25; A2, la memoria procedimental ACE. Dos niveles de presupuesto de contexto: 16K y 128K. 50 muestras por celda, 300 episodios en total, con los parámetros del protocolo oficial (modo de llamada a funciones, ruido de contexto largo, alcance de la memoria) tal como vienen en los scripts oficiales.
El modelo base es el endpoint etiquetado como gpt-6-luna en una pasarela de terceros compatible con OpenAI, fijo durante toda la ejecución. Aquí hay un límite de identidad que hay que decir primero: la etiqueta la pone la pasarela, y el modelo que realmente sirve no puede verificarse de forma independiente desde mi lado. Por tanto, todas mis cifras valen solo para «ese endpoint etiquetado»: son una variante del protocolo DeepSeek del artículo, no la misma tabla.
Las diferencias respecto del montaje del artículo y los detalles de versión se escribieron en el plan del experimento antes de empezar; adelanto tres cosas:
- Número de muestras: la v3 y el repositorio coinciden, 50 por entorno. La Table 2 de la v1 de este artículo decía 200 por entorno; la v3 lo cambió a 50, y el repositorio oficial también publica 50; yo ejecuté esas 50. Esto significa además que 50 por entorno es la propia escala de evaluación del artículo, y que los intervalos estadísticos de ±14 puntos que aparecen más abajo también pesan sobre las cifras por entorno del artículo.
- La memoria procedimental cambió de implementación. El plan original preveía ReasoningBank, pero la implementación publicada con el repositorio depende de forma rígida de la clave de embeddings de otro proveedor; yo solo tenía acceso a la pasarela, así que lo sustituí por ACE, de la misma familia procedimental y el otro método destacado del artículo. No es el mismo método: al valorar, solo cabe mirar la dirección de la familia, no una correspondencia método a método.
- El brazo de memoria cambió una capa de transporte. El canal de llamadas que los autores prepararon para los métodos de memoria es la interfaz por lotes de otro proveedor de nube, cuyo backend compatible con OpenAI además rechaza el tipo de memoria; en mi copia local de trabajo sustituí únicamente la capa de transporte: protocolo, prompts, lógica de memoria, truncamiento y puntuación usan el código oficial del commit fijado. De paso, dejo constancia de una asimetría que trae el propio código de los autores: su backend de OpenAI pasa temperature 1 a las llamadas del brazo A0, mientras que la ruta del brazo de memoria no pasa ese parámetro; lo mantuve tal cual, sin tocar el código para alinearlo, así que entre los tres brazos, además de la memoria, media esta capa de diferencia en los parámetros de generación.
Resultados: el estrechamiento se reproduce; la caída, no
Las tasas de éxito de las seis celdas son las siguientes (n=50 por celda, con el criterio de éxito oficial):
| Brazo | 16K | 128K | Ganancia (frente a A0 del mismo nivel) |
|---|---|---|---|
| A0 sin memoria | 38 % (19/50) | 44 % (22/50) | — |
| A1 recuperación BM25 | 42 % (21/50) | 44 % (22/50) | +4,0 → 0,0 |
| A2 ACE procedimental | 56 % (28/50) | 50 % (25/50) | +18,0 → +6,0 |
La ganancia de ambas memorias se estrecha al ampliar el presupuesto, y la mejor ganancia pasa de +18,0 a +6,0. Lo que el artículo reporta, con el protocolo DeepSeek y en cuatro entornos, es +14,5 → +8,5 (con un recorrido no monótono en medio: a 64K bajó a +7,8 y a 128K volvió a subir a +8,5). Mismo orden de magnitud, misma dirección; pero estos dos pares de cifras no son celdas de la misma tabla y no pueden compararse lado a lado en tamaño.
El detalle de 128K merece un párrafo aparte. El artículo dice que en ese nivel ya hay métodos por debajo de la línea base; en mi caso, no. La ganancia de BM25 se evaporó exactamente hasta cero (44 % frente a 44 %): se quedó en el umbral de «caer por debajo», sin cruzarlo; ACE seguía 6 puntos por encima de la línea base. Este resultado ni confirma ni refuta la cláusula del artículo: solo medí 2 de los 15 métodos y 1 de los 4 entornos, y además elegí justo los dos extremos del espectro —la memoria de recuperación más simple y la clase de memoria procedimental más fuerte del cuadrante de ejecución del artículo—; los métodos que el artículo nombra como caídos a 128K, MemAgent y MemoBrain, no están entre ellos, de modo que «no hubo caída» lo decide en parte la propia elección. Lo que sí puede decirse es que, en este subconjunto y con este modelo base, no ocurrió que «la memoria se convierte en un activo negativo a 128K»; lo que ocurrió fue que «la memoria barata es la primera en fallar»: la ganancia de la memoria de recuperación es la más sensible al presupuesto, y la de la memoria procedimental es más duradera. Si se desglosa el estrechamiento de 12 puntos de ACE, la mitad viene de que la propia línea base se hizo más fuerte (A0 acertó 3 tareas más) y la otra mitad de que ACE retrocedió (acertó 3 menos): dos movimientos de solo 3 tareas cada uno, que juntos forman una figura pero por separado no sostienen ninguna historia. Esta celda también va en la misma dirección que el Finding 4 del artículo: ACE, el único método procedimental de los tres brazos, fue el más fuerte en los dos niveles.
Un jarro de agua fría estadístico: cada celda tiene solo 50 muestras, y el intervalo del 95 % de una celda es de unos ±14 puntos; una diferencia de 4 puntos no son más que dos tareas. Por suerte, las seis celdas ejecutaron las mismas 50 tareas, así que se pueden mirar los vuelcos de acierto y fallo por pares: a 16K, ACE acertó 9 tareas más que la línea base y 0 menos; pero si la propia amplitud del estrechamiento se somete a un bootstrap por pares, el límite inferior del intervalo del 95 % de esos 12 puntos de ACE queda justo sobre el 0, y el estrechamiento de BM25 no puede distinguirse de cero. Por tanto, la lectura de dirección de este texto es descriptiva: la figura va en la misma dirección que la del artículo, y el brazo de ACE tiene evidencia por pares que la respalda; discutir victorias y derrotas mirando una sola celda es buscar conclusiones en el ruido.
El alquiler que paga la memoria: anatomía del coste
El artículo reporta puntuaciones, y también reporta el total de tokens de cada método, pero ese total mezcla la ejecución de la tarea con el módulo de memoria (véanse sus tablas de eficiencia del apéndice). No desglosa por separado las llamadas del propio módulo de memoria. Esta vez yo sí las desglosé por uso, y obtuve un conjunto de cifras que el artículo no tiene.
Los 300 episodios consumieron en total unos 15,17 millones de tokens de entrada y 540.000 tokens de salida. En sus 100 episodios, el módulo de memoria de ACE —las llamadas de reflexión y curación de experiencia tras cada ronda— se comió 2,66 millones de tokens: contando solo la entrada del propio ACE, el módulo de memoria representa en torno al 36,5 %; repartido sobre la entrada total de los 300 episodios, es el 17,6 %. Sus tokens de salida son unas 7,4 veces los del brazo sin memoria, porque la reflexión y la curación son llamadas generativas; y como el precio unitario de la salida es 6 veces el de la entrada, en dinero ese 7,4× daña la factura más que el porcentaje del lado de la entrada. Dicho de otro modo: de cada 100 tokens de entrada que gasta ACE, unos 36,5 se van a mantener la memoria, no a hacer avanzar la tarea en sí. BM25 no produce llamadas de mantenimiento de memoria: la indexación y la recuperación se hacen localmente, sin llamar al modelo; pero el texto recuperado sigue teniendo que entrar en el contexto, y esa parte de tokens de entrada se anota en la cuenta de su propia tarea: lo que ahorra son las llamadas de mantenimiento, no el contexto.
Para tener una referencia de magnitud, se puede contrastar con la propia tabla de eficiencia del artículo: con el protocolo DeepSeek, a 128K, el total de tokens de ACE es unas 1,8 veces el de la línea base sin memoria, y la parte adicional representa en torno al 43,5 % del total de ACE: el mismo orden de magnitud que el 36,5 % que yo desglosé aquí (con una vara de medir distinta: el artículo compara el total de tokens frente a la línea base; yo desgloso los usos dentro de la entrada de ACE).
Estas cifras cambian la forma de hacer las cuentas sobre si la memoria merece la pena. La ganancia de +18 puntos no es gratis: solo el alquiler de ACE ya supera un tercio de su propia entrada, más un volumen de salida siete veces mayor; y ese alquiler existe con independencia del nivel de presupuesto: cuando a 128K la ganancia se reduce a +6 puntos, el módulo de memoria de ACE sigue comiéndose casi la misma cantidad de tokens (1,34 millones en el nivel de 16K, 1,32 millones en el de 128K). Al evaluar un método de memoria, las llamadas de la propia memoria deberían anotarse como coste del método, no esconderse dentro de la infraestructura. Convertido a los precios públicos de la gama Luna (entrada 0,20 dólares y salida 1,20 dólares, ambos por millón de tokens), el precio total de estas 300 tareas fue de unos 3,7 dólares (la facturación real de la cuenta de la pasarela se rige por sus propias reglas, que yo no puedo ver): lo barato es el modelo base; lo caro, la estructura.
Lo que no medí
- El Finding 5 (inversión por dificultad) no se midió. El prerregistro dejaba una sonda secundaria que, con la clasificación por dificultad de los propios autores, mediría en el cuadrante CrossEp-Know si «en las tareas fáciles la memoria resta y en las difíciles suma». La sonda llegó a la fase piloto, la cuota de la cuenta de la pasarela se agotó, la detuve yo mismo y no se obtuvo ningún dato interpretable. Por tanto, este texto no extrae ninguna conclusión sobre el Finding 5; cuando aparece más arriba, es solo como lo declarado por los autores.
- Los contrastes de contexto largo del artículo (modelos propietarios como Gemini-3-Flash o GPT-5-mini) no puedo reejecutarlos; sus puntuaciones se citan como declaradas por los autores.
- Los otros tres cuadrantes, los otros trece métodos y el protocolo original DeepSeek-V3.2 del artículo quedan fuera del alcance de la evidencia de este texto.
Esto enlaza justo con la medición anterior de este blog sobre la memoria entre herramientas de Beacon. La conclusión de aquella vez fue que la memoria solo aporta ganancia sobre «el conocimiento que no puede deducirse del propio repositorio», y que la capa de captura y destilación automáticas es frágil. Las dos evidencias tienen formas distintas —aquella fue una inmersión profunda en un solo sistema; esta, una replicación de subconjunto bajo un protocolo de comparación horizontal—, pero apuntan a lo mismo: la ganancia de la memoria nunca existe por defecto; es una función de un conjunto de condiciones. La condición que esta vez se añade es el presupuesto: cuanto más barato y más grande es el contexto, menos vale la memoria guardada de antemano; y la primera en fallar es la que solo recupera.
Conclusión
Si estás eligiendo una solución de memoria para un agente, esta replicación solo puede sostener tres usos. Primero, declara el presupuesto antes de hablar de ganancia: ante cualquier mejora que anuncie un método de memoria, hay que preguntar con qué presupuesto de contexto se midió, porque al subir un nivel de presupuesto, la ganancia puede evaporarse a la mitad. Segundo, anota los tokens del propio módulo de memoria en la tabla de costes: el alquiler de la memoria generativa (reflexión, curación, resúmenes) puede superar un tercio de su propia entrada (en este caso, el 36,5 %), y no disminuye cuando la ganancia se estrecha. Tercero, en este tipo de tareas de llamadas a herramientas, la memoria procedimental (el ACE de este ejemplo) es más fuerte en los dos niveles, pero hay que pagar el coste de sus llamadas; la memoria de pura recuperación es la primera cuya ganancia llega a cero cuando el presupuesto sobra, y solo encaja en escenarios donde el presupuesto está realmente limitado. Y no traslades la conclusión fuera de este entorno sin más: el Finding 7 del artículo muestra que en otros dominios de ejecución, como la búsqueda web o el embodied, la forma de memoria que mejor encaja no es la misma.
En cuanto a este benchmark en sí, mi valoración es esta: el patrón de estrechamiento del Finding 3, cambiado el endpoint y reducido a un subconjunto, sigue apuntando en la misma dirección; es su parte más útil. Solo que la identidad del endpoint no puede verificarse de forma independiente, así que esto cuenta como una replicación exploratoria entre endpoints, no como una demostración entre modelos base. La afirmación más afilada, la de la caída por debajo de la línea base a 128K, no apareció en mi subconjunto; para juzgar si se sostiene en más métodos haría falta que alguien ejecutara los otros trece métodos con el protocolo original. Eso no es la conclusión de este artículo: es la tarea que deja pendiente.
Límites de la evidencia: todas las cifras del artículo son lo declarado por los autores en arXiv:2605.18421 v3; mis cifras valen solo para el subconjunto, los tres brazos y dos niveles, y el endpoint etiquetado por la pasarela indicados, en una sola ejecución. El recibo completo (con los conteos brutos de las seis celdas, el desglose de tokens, el registro de desviaciones y las limitaciones estadísticas), los datos por tarea y los scripts del análisis por pares se han publicado junto a este artículo (véase el publicRepository al principio) y pueden verificarse archivo a archivo con SHA256SUMS.