16K auf 128K: Agenten-Gedächtnis gewinnt von +18 auf +6 geschrumpft – EvoMemBench-Teilmenge repliziert und Token-Kosten zerlegt
Immer mehr Systeme geben einem Agenten ein Gedächtnis, und jedes behauptet, mit der Nutzung klüger zu werden. Doch eine Frage wird selten frontal beantwortet: Auch die Kontextfenster werden größer. Wenn ein Modell auf einmal immer mehr lesen kann – wie viel ist ein im Voraus gespeichertes Gedächtnis dann noch wert?
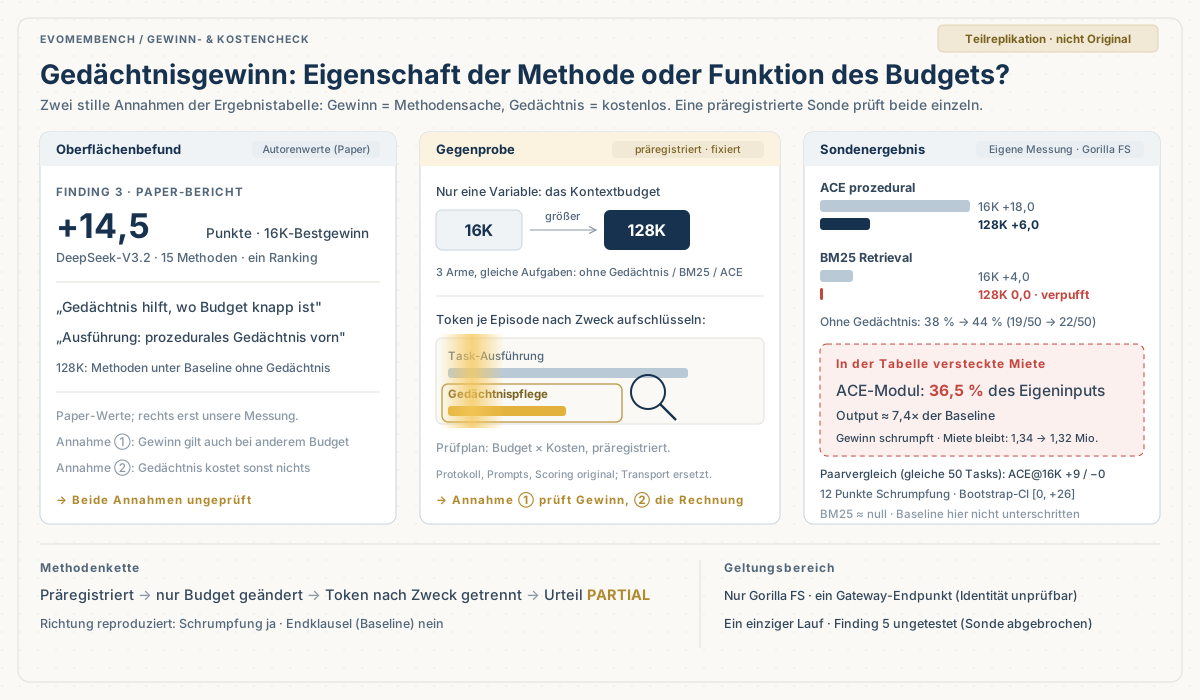
EvoMemBench gibt dieser Kurve zufällig eine Zahl. Es steckt 15 Gedächtnismethoden in ein einheitliches Bewertungsprotokoll und berichtet: Wächst das Kontextbudget von 16K auf 128K, schrumpft der beste Gewinn der Gedächtnismethoden gegenüber der Baseline ohne Gedächtnis von +14,5 auf +8,5 Punkte, und bei 128K sind bereits Gedächtnismethoden unter die Baseline ohne Gedächtnis gefallen.
Mich interessiert, ob diese Kurve auch mit einem anderen Backbone Bestand hat – vor allem mit der günstigsten Stufe. Der Grund ist praktisch: Experimente dieser Größenordnung (die 128K-Stufe spielt lange Kontexte immer wieder durch) sind zum Flaggschiffpreis schlicht nicht fahrbar; bei der Backbone-Wahl sortiert der Preis eine erste Runde aus. Und in den Einsatzszenarien, die mich interessieren, läuft das Volumen ebenfalls vor allem auf den günstigen Stufen. Also habe ich nicht den vollen Aufbau des Papers nachgebaut, sondern eine verkleinerte Frage präregistriert: Bleibt die Richtung – der Gewinn schrumpft mit wachsendem Budget – auf der günstigsten GPT-Stufe, die das Gateway hergibt, und in einer einzigen Ausführungsumgebung bestehen?
Das Fazit gleich hier: Die Richtung stimmt. Mein bester Gewinn schrumpft von +18,0 Punkten bei 16K auf +6,0 Punkte bei 128K, und beide Gedächtnismethoden schrumpfen in dieselbe Richtung. Aber die schärfste Szene des Papers – Gedächtnis fällt bei 128K unter die Baseline – blieb aus: Der Gewinn des Retrieval-Gedächtnisses ging nur auf null zurück, das prozedurale Gedächtnis blieb über der Baseline. Das Gesamturteil ist PARTIAL; die Evidenzgrenzen stehen am Ende.
Zuerst die Evidenzstufen sortieren
Dieses Paper (arXiv:2605.18421, u. a. von der Hong Kong University of Science and Technology in Guangzhou) erschien im Mai 2026 als v1 und wurde am 30. Oktober auf v3 aktualisiert – es ist kein neues Paper. Was es tut: Es gibt der Frage, ob das Gedächtnis eines Agenten überhaupt hilft, ein Koordinatensystem. Eine Achse ist der Wirkungsbereich des Gedächtnisses (innerhalb einer einzelnen Aufgabe / aufgabenübergreifend), die andere der Inhaltstyp (Wissen / Ausführung) – vier Quadranten. Sechs Datensätze mit insgesamt 2.954 Bewertungsstichproben nach Table 2 fallen in die vier Quadranten; 15 Gedächtnismethoden werden in sechs Familien sortiert und unter einem einheitlichen Protokoll mit Long-Context-Baselines verglichen. Eine Bedingung muss immer mitlaufen: Alle Gedächtnismethoden im Paper teilen sich dasselbe Backbone, DeepSeek-V3.2. Ihre Rangfolge ist eine Rangfolge unter diesem Backbone; über Rangfolgen ohne Backbone zu reden, ist sinnlos.
Von den acht Schlussfolgerungen des Papers sind für diesen Text drei unmittelbar relevant – plus eine halbe. Long-Context-Baselines bleiben sehr stark und führen bei Wissensbewahrung und -revision (Finding 1); der Engpass des Gedächtnisses liegt in der Revision, nicht im Retrieval – die Methoden können Informationen gut ablegen, aber schlecht alte Erkenntnisse ersetzen, wenn sich die Belege ändern (Finding 2); eine Ebene tiefer liegt der Engpass darin, aus abgelegten Informationen wiederverwendbares Wissen zu formen, statt nur mehr zu speichern (Finding 6); prozedurales Gedächtnis passt am besten zu Ausführungsaufgaben (Finding 4); und es gibt eine Schwierigkeitsumkehr: Bei leichten Aufgaben ist Gedächtnis ein negativer Gewinn, bei schweren punktet nur Gedächtnis (Finding 5) – diese halbe konnte ich nicht testen, der Grund steht am Ende.
All das sind Angaben der Autoren. Meine Replikation berührt nur eine davon: die Gewinn-Budget-Kurve von Finding 3, und auch die nur in einer Umgebung eines einzigen Quadranten.
Mein Replikationsdesign: das günstigste Backbone, nur eine Kurve
Dieses Experiment war präregistriert, alle Einstellungen standen vor dem Start fest, wie folgt. Als Teilmenge wählte ich InEp-Exec aus den vier Quadranten (Ausführungsaufgaben innerhalb derselben Runde) und fuhr davon nur eine einzige Umgebung: das Gorilla File System – eine Reihe von mehrstufigen Tool-Call-Aufgaben, deren Erfolg der im offiziellen Runner eingebaute Checker feststellt, ganz ohne zusätzlichen Judge. Drei Arme: A0, die Baseline ohne Gedächtnis; A1, BM25-Retrieval-Gedächtnis; A2, das prozedurale Gedächtnis ACE. Zwei Kontextbudget-Stufen: 16K und 128K. 50 Einträge pro Zelle, insgesamt 300 Episoden; die offiziellen Protokollparameter (Function-Calling-Modus, Long-Context-Rauschen, Geltungsbereich des Gedächtnisses) blieben exakt wie in den offiziellen Skripten.
Als Backbone diente der Endpunkt, den ein OpenAI-kompatibles Drittanbieter-Gateway als gpt-6-luna labelt, den ganzen Lauf über unverändert. Eine Identitätsgrenze muss vorab gesagt sein: Das Label vergibt das Gateway; welches Modell es tatsächlich bedient, kann ich von meiner Seite nicht unabhängig prüfen. Alle meine Zahlen unten gelten daher nur für „diesen gelabelten Endpunkt” – sie sind ein Variantenkaliber des DeepSeek-Kalibers des Papers, nicht dieselbe Tabelle.
Abweichungen vom Aufbau des Papers und Versionsdetails standen vor dem Start im Versuchsplan; drei Punkte vorab:
- Stichprobenzahl: v3 und Repository stimmen überein, 50 pro Umgebung. Table 2 der v1 dieses Papers nannte noch 200 pro Umgebung; v3 hat das auf 50 geändert, und auch das offizielle Repository liefert tatsächlich 50 aus – gefahren bin ich genau diese 50. Das heißt zugleich: 50 pro Umgebung ist der Bewertungsmaßstab des Papers selbst; das statistische Intervall von ±14 Punkten weiter unten trägt auch jede Einzelumgebungs-Zahl des Papers.
- Das prozedurale Gedächtnis bekam eine andere Implementierung. Geplant war ReasoningBank, doch seine mit dem Repository ausgelieferte Implementierung hängt hart an einem Embedding-Schlüssel eines anderen Anbieters; ich habe nur diesen einen Gateway-Zugang, also wechselte ich zu ACE – derselben prozeduralen Familie und der anderen Schlagzeilen-Methode des Papers. Es ist nicht dieselbe Methode; beim Urteil zählt nur die Familienrichtung, kein Eins-zu-eins-Methodenvergleich.
- Der Gedächtnisarm bekam eine andere Transportschicht. Der Aufrufkanal, den die Autoren für ihre Gedächtnismethoden vorgesehen haben, ist die Batch-Schnittstelle eines anderen Cloud-Anbieters, und dessen OpenAI-kompatibles Backend lehnt Gedächtnistypen ab; in meiner lokalen Arbeitskopie habe ich nur die Transportschicht ersetzt – Protokoll, Prompts, Gedächtnislogik, Kürzung und Scoring stammen vollständig aus dem offiziellen Code des fixierten Commits. Am Rande eine Asymmetrie, die das Upstream selbst mitbringt: Das OpenAI-Backend der Autoren versieht die Aufrufe des A0-Arms mit temperature 1, der Pfad der Gedächtnisarme übergibt diesen Parameter nicht – ich habe das unverändert übernommen und den Code nicht zur Angleichung angefasst; zwischen den drei Armen liegt also außer dem Gedächtnis auch diese Schicht von Generierungsparametern.
Ergebnis: Schrumpfung reproduziert, Unterschreiten blieb aus
Die Erfolgsquoten der sechs Zellen (jeweils n=50, offizielles Erfolgskriterium):
| Arm | 16K | 128K | Gewinn (ggü. A0 derselben Stufe) |
|---|---|---|---|
| A0 ohne Gedächtnis | 38 % (19/50) | 44 % (22/50) | — |
| A1 BM25-Retrieval | 42 % (21/50) | 44 % (22/50) | +4,0 → 0,0 |
| A2 ACE prozedural | 56 % (28/50) | 50 % (25/50) | +18,0 → +6,0 |
Die Gewinne beider Gedächtnisarten schrumpfen, wenn das Budget wächst; der beste Gewinn fällt von +18,0 auf +6,0. Das Paper berichtet im DeepSeek-Kaliber über vier Umgebungen +14,5 → +8,5 (dazwischen nicht monoton: Die 64K-Stufe fiel auf +7,8, die 128K-Stufe stieg wieder auf +8,5). Gleiche Größenordnung, gleiche Richtung – aber diese beiden Zahlenreihen sind keine Zellen derselben Tabelle und dürfen nicht Seite an Seite verglichen werden.
Die Details der 128K-Stufe verdienen einen eigenen Blick. Das Paper sagt, auf dieser Stufe seien bereits Methoden unter die Baseline gefallen; bei mir nicht. Der Gewinn von BM25 verpuffte exakt auf null (44 % gegen 44 %), er blieb auf der Schwelle zum „Unterschreiten” stehen und trat nicht hinüber; ACE lag noch 6 Punkte über der Baseline. Dieses Ergebnis bestätigt die Klausel des Papers weder, noch widerlegt es sie: Ich habe nur 2 der 15 Methoden und 1 der 4 Umgebungen getestet, und die Auswahl traf ausgerechnet die beiden Enden des Spektrums – das einfachste Retrieval-Gedächtnis und die Klasse prozeduralen Gedächtnisses, die im Ausführungsquadranten des Papers am stärksten ist; die Methoden, die das Paper bei 128K als unter die Baseline gefallen benennt, MemAgent und MemoBrain, waren nicht dabei. Das „kein Unterschreiten” ist also zum Teil von der Auswahl selbst entschieden. Was sich sagen lässt: In dieser Teilmenge und auf diesem Backbone wurde „Gedächtnis wird bei 128K zum negativen Aktivposten” nicht beobachtet; beobachtet wurde nur, dass „das billige Gedächtnis zuerst versagt” – der Gewinn des Retrieval-Gedächtnisses reagiert am empfindlichsten auf das Budget, der des prozeduralen Gedächtnisses ist haltbarer. Zerlegt man die 12 Punkte Schrumpfung von ACE: Die Hälfte stammt daher, dass die Baseline selbst stärker wurde (A0 löste 3 Aufgaben mehr), die andere Hälfte aus einem Rückgang von ACE (3 Aufgaben weniger) – beide Bewegungen haben nur die Größenordnung von 3 Aufgaben; zusammen ergeben sie ein Muster, einzeln erzählen sie keine Geschichte. Auch diese Zelle zeigt in dieselbe Richtung wie Finding 4 des Papers: ACE, die einzige prozedurale Methode unter den drei Armen, war auf beiden Stufen die stärkste.
Statistisch muss ich die Erwartungen erst einmal dämpfen: Jede Zelle hat nur 50 Einträge, ein 95%-Intervall pro Zelle ist rund ±14 Punkte breit, und ein Abstand von 4 Punkten sind gerade zwei Aufgaben. Zum Glück fuhren alle sechs Zellen dieselben 50 Aufgaben, sodass sich Gewinn und Verlust paarweise betrachten lassen: Auf der 16K-Stufe löste ACE 9 Aufgaben mehr richtig als die Baseline und 0 weniger; doch zieht man die Schrumpfung selbst durch ein gepaartes Bootstrap, liegt die Untergrenze des 95%-Intervalls für die 12 Punkte von ACE genau auf 0, und die Schrumpfung von BM25 ist von null nicht zu unterscheiden. Das Richtungsurteil dieses Textes ist daher deskriptiv: Das Muster zeigt in dieselbe Richtung wie das Paper, und der ACE-Arm hat paarweise Evidenz im Rücken; wer aus einer einzelnen Zelle einen Sieg oder eine Niederlage liest, sucht Schlussfolgerungen im Rauschen.
Die Miete des Gedächtnisses: Kostenzerlegung
Das Paper berichtet Punkte und auch die Gesamt-Token jeder Methode – allerdings als Summe aus Aufgabenausführung und Gedächtnismodul (siehe seine Effizienz-Tabellen im Anhang). Was es nicht tut: die Aufrufe des Gedächtnismoduls selbst separat ausweisen. Diesmal habe ich nach Zweck aufgeschlüsselt und eine Reihe von Zahlen erhalten, die im Paper nicht steht.
Die 300 Episoden verbrauchten insgesamt rund 15,17 Mio. Input-Token und 540.000 Output-Token. In seinen eigenen 100 Episoden fraß das Gedächtnismodul von ACE – die Reflexions- und Erfahrungskurations-Aufrufe nach jeder Runde – 2,66 Mio. Token: Nur auf den eigenen Input von ACE bezogen, entfallen rund 36,5 % auf das Gedächtnismodul; auf den Gesamtinput aller 300 Episoden verteilt, sind es 17,6 %. Sein Output-Token-Volumen beträgt etwa das 7,4-Fache des Arms ohne Gedächtnis, weil Reflexion und Kuratierung generative Aufrufe sind; und da der Output-Preis sechsmal so hoch ist wie der Input-Preis, schlägt dieses 7,4-Fache in der Rechnung härter zu als der Anteil auf der Input-Seite. Anders gesagt: Von je 100 Input-Token, die ACE verbraucht, fließen rund 36,5 in die Pflege seines Gedächtnisses statt in die Aufgabe selbst. BM25 erzeugt keine Gedächtnispflege-Aufrufe: Indizierung und Retrieval laufen lokal, ohne Modellaufruf; doch der abgerufene Text muss trotzdem in den Kontext, und diese Input-Token stehen auf seiner eigenen Aufgabenrechnung – was es spart, ist der Pflegeaufruf, nicht der Kontext.
Ein Gefühl für die Größenordnung gibt der Vergleich mit der Effizienz-Tabelle des Papers selbst: Im DeepSeek-Kaliber auf der 128K-Stufe beträgt das Gesamt-Token-Volumen von ACE etwa das 1,8-Fache der Baseline ohne Gedächtnis, und der Mehranteil macht rund 43,5 % des ACE-Gesamtvolumens aus – dieselbe Größenordnung wie die hier zerlegten 36,5 % (bei unterschiedlichem Kaliber: Das Paper bildet das Verhältnis der Gesamt-Token zur Baseline, ich zerlege den Input von ACE nach Zweck).
Diese Zahlen verändern die Rechenweise hinter der Frage, ob sich Gedächtnis lohnt. Der Gewinn von +18 Punkten ist nicht gratis: Allein die Miete von ACE beträgt mehr als ein Drittel seines eigenen Inputs, dazu ein mehr als siebenfaches Output-Volumen; und diese Miete existiert unabhängig von der Budgetstufe – als der Gewinn auf der 128K-Stufe auf +6 Punkte schrumpfte, fraß das Gedächtnismodul von ACE immer noch fast dieselbe Token-Menge (1,34 Mio. auf der 16K-Stufe, 1,32 Mio. auf der 128K-Stufe). Wer eine Gedächtnismethode bewertet, muss die eigenen Aufrufe des Gedächtnisses in die Methodenkosten einrechnen, statt sie in der Infrastruktur zu verstecken. Umgerechnet zu den öffentlichen Listenpreisen der Luna-Stufe (Input 0,20 US-Dollar, Output 1,20 US-Dollar, jeweils pro Million Token) kosteten diese 300 Aufgaben insgesamt rund 3,7 US-Dollar (die tatsächliche Abrechnung des Gateway-Kontos folgt dessen eigenen Regeln und ist für mich nicht einsehbar) – billig ist das Backbone, teuer ist die Struktur.
Was ich nicht getestet habe
- Finding 5 (Schwierigkeitsumkehr) nicht getestet. In der Präregistrierung war eine sekundäre Sonde vorgesehen, die mit den Schwierigkeitsstufen der Autoren im CrossEp-Know-Quadranten prüfen sollte, ob Gedächtnis bei leichten Aufgaben negativ und bei schweren positiv ist. Die Sonde erreichte die Pilotphase, dann war das Guthaben des Gateway-Kontos erschöpft, und ich habe sie gestoppt, ohne auswertbare Daten zu gewinnen. Zu Finding 5 zieht dieser Text daher keinerlei Schluss; wo es oben vorkommt, ist es ausschließlich eine Angabe der Autoren.
- Die Long-Context-Vergleiche des Papers (proprietäre Modelle wie Gemini-3-Flash und GPT-5-mini) kann ich nicht nachfahren; ihre Punkte zitiere ich als Angaben der Autoren.
- Die übrigen drei Quadranten, die anderen dreizehn Methoden und das ursprüngliche DeepSeek-V3.2-Kaliber des Papers liegen außerhalb des Evidenzbereichs dieses Textes.
Das fügt sich an die frühere hiesige Messung zum werkzeugübergreifenden Gedächtnis von Beacon an. Deren Fazit: Gedächtnis bringt nur für solches Wissen einen Zuwachs, das sich nicht aus dem Repository selbst ableiten lässt, und die automatische Erfassungs- und Destillationsschicht ist fragil. Die Evidenzformen der beiden Male unterscheiden sich – damals Tiefenbohrung an einem Einzelsystem, diesmal eine Teilmengen-Replikation unter einem Vergleichsprotokoll –, doch sie zeigen auf dieselbe Sache: Der Gewinn von Gedächtnis existiert nie standardmäßig; er ist eine Funktion einer Menge von Bedingungen. Die Bedingung, die diesmal hinzukommt, ist das Budget: Je billiger und größer der Kontext wird, desto weniger ist vorgespeichertes Gedächtnis wert; und zuerst versagt die Klasse, die nur Retrieval betreibt.
Fazit
Wer für einen Agenten eine Gedächtnislösung wählt, kann aus dieser Replikation nur drei Verwendungen stützen. Erstens: Erst das Budget nennen, dann über Gewinn reden – bei jeder behaupteten Verbesserung einer Gedächtnismethode gehört die Frage dazu, unter welchem Kontextbudget sie gemessen wurde; wächst das Budget um eine Stufe, kann der Gewinn um mehr als die Hälfte verpuffen. Zweitens: Die eigenen Token des Gedächtnismoduls gehören in die Kostentabelle – die Miete generativen Gedächtnisses (Reflexion, Kuratierung, Zusammenfassung) kann mehr als ein Drittel seines eigenen Inputs erreichen (in diesem Fall 36,5 %), und sie schrumpft nicht mit dem Gewinn. Drittens: Bei dieser Art von Tool-Call-Aufgaben ist prozedurales Gedächtnis (hier ACE) auf beiden Stufen stärker, aber man zahlt für seine Aufruf-Kosten; reines Retrieval-Gedächtnis verliert seinen Gewinn bei ausreichendem Budget zuerst und taugt nur für Szenarien mit wirklich knappem Budget. Und Vorsicht beim Übertragen aus dieser Umgebung heraus: Finding 7 des Papers zeigt, dass in anderen Ausführungsbereichen wie Websuche oder Embodied AI jeweils andere Gedächtnisformen am besten passen.
Und zu diesem Benchmark selbst lautet mein Urteil: Das Schrumpfungsmuster von Finding 3 zeigt auch nach einem Wechsel des Endpunkts und einer Verkleinerung auf eine Teilmenge in dieselbe Richtung – das ist sein nützlichster Teil; nur lässt sich die Identität des Endpunkts nicht unabhängig prüfen, also ist dies eine explorative Replikation quer über Endpunkte, kein Beweis quer über Backbones. Die schärfere Behauptung, bei 128K falle Gedächtnis unter die Baseline, trat in meiner Teilmenge nicht auf; ob sie für mehr Methoden gilt, kann nur beurteilen, wer die übrigen dreizehn Methoden im Originalkaliber durchfährt. Das ist nicht das Fazit dieses Textes, sondern eine offene Frage für künftige Arbeit.
Evidenzgrenzen: Alle Zahlen des Papers sind Angaben der Autoren aus arXiv:2605.18421 v3; meine Zahlen gelten nur für die oben genannte Teilmenge, die drei Arme auf zwei Stufen und den per Gateway gelabelten Endpunkt, ein einziger Lauf. Der vollständige Beleg (mit den Rohzählungen der sechs Zellen, der Token-Aufschlüsselung, dem Abweichungsregister und den statistischen Einschränkungen), die Daten pro Aufgabe und die Analyseskripte sind mit diesem Text veröffentlicht (siehe publicRepository im Kopf) und lassen sich Datei für Datei per SHA256SUMS prüfen.