Da 16K a 128K, il guadagno della memoria dell'agente si restringe da +18 a +6: replica di un sottoinsieme di EvoMemBench e anatomia dei costi in token
Sono sempre di più i sistemi che aggiungono memoria a un Agent, e ognuno dichiara di diventare più intelligente con l’uso. Ma c’è una domanda a cui raramente si risponde di petto: anche la finestra di contesto sta crescendo. Se un modello riesce a leggere sempre più cose in una volta sola, quanto vale ancora una memoria salvata in anticipo?
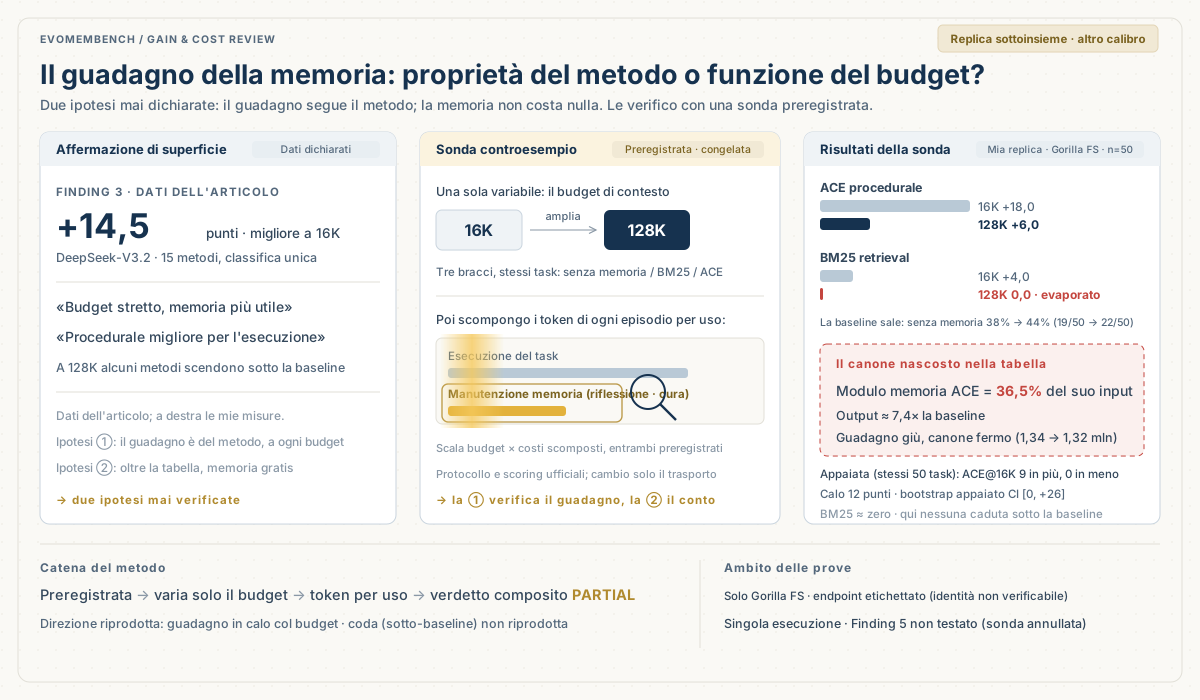
EvoMemBench ha dato un numero proprio a questa curva. Ha messo 15 metodi di memoria dentro lo stesso protocollo di valutazione e ha riportato che, ampliando il budget di contesto da 16K a 128K, il guadagno migliore dei metodi di memoria rispetto alla baseline senza memoria si restringe da +14,5 a +8,5 punti — e che a 128K alcuni metodi di memoria sono già scesi sotto la baseline senza memoria.
La mia domanda è se questa curva regge cambiando backbone — soprattutto passando al livello più economico. Il motivo è pratico: esperimenti di questa scala (a 128K bisogna riprodurre contesti lunghi di continuo) a prezzi da modello di punta semplicemente non si possono eseguire; la scelta del backbone viene filtrata prima dal prezzo. E negli scenari di deployment che mi interessano, i volumi girano soprattutto sui livelli economici. Così non ho replicato l’intero impianto dell’articolo: ho preregistrato una domanda ridotta — sull’endpoint GPT più economico disponibile sul gateway, dentro un singolo ambiente di esecuzione, la direzione del restringimento del guadagno al crescere del budget c’è ancora?
La conclusione, subito: la direzione c’è. Il guadagno migliore che ho ottenuto si restringe da +18,0 punti a 16K a +6,0 punti a 128K, ed entrambi i metodi di memoria si restringono nella stessa direzione. Ma la scena più tagliente dell’articolo — la memoria che a 128K cade sotto la baseline — non si è presentata: il guadagno della memoria a recupero si è solo azzerato, e la memoria procedurale è rimasta sopra la baseline. Il verdetto composito è PARTIAL; i confini dell’evidenza sono a fine articolo.
Prima, separiamo i livelli di evidenza
Questo articolo (arXiv:2605.18421, Università di Scienza e Tecnologia di Hong Kong a Guangzhou e altre istituzioni) è uscito in v1 a maggio 2026 ed è stato aggiornato alla v3 il 30 ottobre: non è un articolo nuovo. Il suo lavoro è dare un sistema di coordinate alla domanda «la memoria aiuta davvero un Agent?»: un asse è l’ambito d’azione della memoria (dentro un singolo task / tra task diversi), l’altro è il tipo di contenuto (conoscenza / esecuzione), e ne risultano quattro quadranti; sei dataset, per un totale di 2.954 campioni di valutazione secondo la sua Table 2, si distribuiscono nei quattro quadranti; 15 metodi di memoria sono raggruppati in sei famiglie e confrontati, con un protocollo unificato, contro baseline a contesto lungo. C’è una condizione da tenere sempre presente: nell’articolo tutti i metodi di memoria condividono lo stesso backbone, DeepSeek-V3.2; la loro classifica è la classifica sotto quel backbone, e parlare di classifica a prescindere dal backbone non ha senso.
Delle otto conclusioni dell’articolo, quelle che toccano direttamente questo pezzo sono tre, più una mezza. Le baseline a contesto lungo restano molto forti, prime per ritenzione e revisione della conoscenza (Finding 1); il collo di bottiglia della memoria sta nella revisione, non nel recupero: i metodi sono bravi a salvare le informazioni, non a correggere la conoscenza vecchia quando le prove cambiano (Finding 2); un livello più sotto, il collo di bottiglia è trasformare ciò che è stato salvato in conoscenza riutilizzabile, non salvare di più (Finding 6); la memoria procedurale è la più adatta ai task di esecuzione (Finding 4); e c’è il ribaltamento per difficoltà: sui task facili la memoria ha guadagno negativo, su quelli difficili solo la memoria segna punti (Finding 5) — questa mezza non ho potuto testarla, per i motivi spiegati in fondo.
Tutto quanto sopra è dichiarato dagli autori. La mia replica ne tocca una sola: la curva guadagno–budget di Finding 3, e solo dentro un ambiente di un quadrante.
Il mio disegno di replica: il backbone più economico, una sola curva
Questo esperimento è stato preregistrato: le impostazioni erano tutte fissate prima di partire, come segue. Il sottoinsieme è InEp-Exec (task di esecuzione dentro lo stesso episodio) dei quattro quadranti, e ne ho eseguito un solo ambiente, Gorilla File System: una suite di task di chiamate a strumenti in più turni, il cui successo è deciso dal checker integrato nel runner ufficiale, senza bisogno di un giudice aggiuntivo. Tre bracci: A0, baseline senza memoria; A1, memoria a recupero BM25; A2, memoria procedurale ACE. Due livelli di budget di contesto: 16K e 128K. 50 campioni per cella, 300 episodi in totale, con i parametri di protocollo ufficiali (modalità function calling, rumore da contesto lungo, ambito della memoria) presi tali e quali dagli script ufficiali.
Come backbone ho usato l’endpoint etichettato gpt-6-luna su un gateway di terze parti compatibile con OpenAI, fisso per tutta la durata. Qui va dichiarata subito una frontiera di identità: l’etichetta la assegna il gateway, e il modello effettivamente servito non è verificabile in modo indipendente dal mio lato. Quindi tutti i miei numeri qui sotto valgono solo per «quell’endpoint etichettato»: sono un calibro variante rispetto a quello DeepSeek dell’articolo, non la stessa tabella.
Le divergenze dalle impostazioni dell’articolo e i dettagli di versione erano già scritti nel piano sperimentale prima di partire; li dichiaro in tre punti:
- Numero di campioni: v3 e repository coincidono, 50 per ambiente. La Table 2 della v1 indicava 200 campioni per ambiente; la v3 l’ha corretta a 50, e anche il repository ufficiale ne distribuisce 50: sono quelli che ho eseguito. Questo significa anche che 50 per ambiente è la scala di valutazione dell’articolo stesso: gli intervalli statistici di ±14 punti di cui sotto gravano allo stesso modo sui numeri per singolo ambiente dell’articolo.
- La memoria procedurale ha cambiato implementazione. Il piano prevedeva ReasoningBank, ma la sua implementazione distribuita col repository dipende in modo rigido dalla chiave di embedding di un altro fornitore, e io avevo accesso solo tramite il gateway; sono passato ad ACE, della stessa famiglia procedurale e altro metodo di punta dell’articolo. Non è lo stesso metodo: il verdetto va letto per direzione di famiglia, non per confronto metodo a metodo.
- Il braccio con memoria ha cambiato un livello di trasporto. Il canale di chiamata predisposto dagli autori per i metodi di memoria è l’interfaccia batch di un altro fornitore cloud, il cui backend compatibile OpenAI rifiuta a sua volta i tipi di memoria; nella mia copia di lavoro locale ho sostituito solo il livello di trasporto — protocollo, prompt, logica di memoria, troncamento e scoring sono interamente il codice ufficiale al commit fissato. Dichiaro anche un’asimmetria che arriva da monte: il backend OpenAI degli autori passa temperature 1 alle chiamate del braccio A0, mentre il percorso seguito dai bracci con memoria non passa quel parametro; l’ho lasciata così com’era, senza toccare il codice per allinearla. Quindi tra i tre bracci, oltre alla memoria, c’è anche questo strato di differenza nei parametri di generazione.
Risultati: il restringimento si riproduce, la caduta sotto la baseline no
I tassi di successo delle sei celle (n=50 per cella, criterio di successo ufficiale):
| Braccio | 16K | 128K | Guadagno (vs A0 dello stesso livello) |
|---|---|---|---|
| A0 senza memoria | 38% (19/50) | 44% (22/50) | — |
| A1 recupero BM25 | 42% (21/50) | 44% (22/50) | +4,0 → 0,0 |
| A2 ACE procedurale | 56% (28/50) | 50% (25/50) | +18,0 → +6,0 |
I guadagni di entrambe le memorie si restringono quando il budget cresce; il guadagno migliore passa da +18,0 a +6,0. L’articolo, nel calibro DeepSeek e su quattro ambienti, riporta +14,5 → +8,5 (con un andamento non monotono in mezzo: a 64K era sceso a +7,8, a 128K risalito a +8,5). Stesso ordine di grandezza, stessa direzione — ma questi due gruppi di numeri non sono celle della stessa tabella e non si possono confrontare valore contro valore.
Il dettaglio del livello 128K merita un discorso a parte. L’articolo dice che a quel livello alcuni metodi sono già caduti sotto la baseline; da me, no. Il guadagno di BM25 è evaporato esattamente a zero (44% contro 44%), fermandosi sulla soglia della «caduta sotto», senza oltrepassarla; ACE è rimasto 6 punti sopra la baseline. Questo risultato non conferma né confuta la clausola dell’articolo: ho testato solo 2 dei 15 metodi e 1 dei 4 ambienti, e per giunta ho scelto i due estremi dello spettro — la memoria a recupero più semplice e la classe di memoria procedurale che nell’articolo è la più forte nel quadrante di esecuzione; MemAgent e MemoBrain, che l’articolo indica nominalmente come caduti sotto la baseline a 128K, non sono tra questi, quindi il «niente caduta» è in parte deciso dalla scelta stessa. Ciò che si può dire è che, su questo sottoinsieme e questo backbone, «la memoria diventa un attivo negativo a 128K» non è successo; è successo solo che «la memoria economica smette di funzionare per prima» — il guadagno della memoria a recupero è il più sensibile al budget, quello della memoria procedurale è più durevole. Scomponendo il restringimento di 12 punti di ACE: metà viene dalla baseline che si rafforza da sola (A0 ha azzeccato 3 task in più), metà dal passo indietro di ACE (3 task in meno) — due variazioni da 3 task ciascuna: insieme fanno una figura, prese da sole non fanno una storia. Anche questa cella va nella stessa direzione di Finding 4 dell’articolo: ACE, l’unico metodo procedurale dei tre bracci, è il più forte a entrambi i livelli.
Statistiche, una doccia fredda: ogni cella ha solo 50 campioni, e l’intervallo al 95% di una singola cella è di circa ±14 punti; una differenza di 4 punti vale appena due task. Per fortuna le sei celle hanno eseguito gli stessi 50 task, quindi si possono guardare in modo appaiato, seguendo i ribaltamenti successo/fallimento: a 16K, ACE ha azzeccato 9 task in più della baseline e 0 in meno; ma se si sottopone l’ampiezza stessa del restringimento a un bootstrap appaiato, il limite inferiore dell’intervallo al 95% per quei 12 punti di ACE poggia esattamente sullo 0, e il restringimento di BM25 è indistinguibile da zero. Quindi il verdetto direzionale di questo articolo è descrittivo: la figura va nella stessa direzione dell’articolo, con il braccio ACE sostenuto da evidenza appaiata; litigare su chi vince in una singola cella significa cercare conclusioni dentro il rumore.
Il canone della memoria: anatomia dei costi
L’articolo riporta i punteggi, e riporta anche il totale dei token per metodo — ma è il totale di esecuzione del task e modulo di memoria messi insieme (si vedano le sue tabelle di efficienza in appendice). Non scompone a parte le chiamate del modulo di memoria stesso. Stavolta li ho scomposti per uso, ottenendo un gruppo di numeri che nell’articolo non c’è.
I 300 episodi hanno consumato in totale circa 15,17 milioni di token in input e 540 mila in output. Nei suoi 100 episodi, il modulo di memoria di ACE — le chiamate di riflessione e cura dell’esperienza dopo ogni turno — ha assorbito 2,66 milioni di token: contando solo l’input di ACE, il modulo di memoria pesa circa il 36,5%; spalmandolo sull’input totale dei 300 episodi, è il 17,6%. I suoi token in output sono circa 7,4 volte quelli del braccio senza memoria, perché riflessione e cura sono entrambe chiamate generative; e poiché il prezzo unitario dell’output è 6 volte quello dell’input, in termini di denaro quel 7,4× ferisce il conto più della quota sul lato input. Detto altrimenti: di ogni 100 token in input che ACE spende, circa 36,5 vanno a mantenere la memoria, non a far avanzare il task. BM25 non genera chiamate di manutenzione della memoria: indicizzazione e recupero avvengono in locale, senza chiamare il modello; ma il testo recuperato deve comunque entrare nel contesto, e quei token in input restano sul conto del suo task — ciò che risparmia è la chiamata di manutenzione, non il contesto.
Un senso dell’ordine di grandezza si può ricavare anche dalla tabella di efficienza dell’articolo stesso: nel calibro DeepSeek, a 128K, il totale dei token di ACE è circa 1,8 volte quello della baseline senza memoria, e la parte in eccesso vale circa il 43,5% del totale di ACE — lo stesso ordine di grandezza del mio 36,5% scomposto (calibri diversi: l’articolo rapporta il totale alla baseline, io scompongo l’interno dell’input di ACE).
Questi numeri cambiano il modo di fare i conti sul «la memoria vale il suo costo?». Il guadagno di +18 punti non è gratuito: il solo canone di ACE supera un terzo del suo stesso input, più un output oltre sette volte tanto; e questo canone esiste a prescindere dal livello di budget — quando a 128K il guadagno si è ristretto a +6 punti, il modulo di memoria di ACE assorbiva ancora quasi la stessa quantità di token (1,34 milioni a 16K, 1,32 milioni a 128K). Quando si valuta un metodo di memoria, le chiamate della memoria stessa vanno messe nel costo del metodo, non nascoste nell’infrastruttura con una riga sola. Convertendo ai prezzi di listino pubblici del livello Luna (input 0,20 dollari, output 1,20 dollari, entrambi per milione di token), il prezzo totale di questi 300 task è circa 3,7 dollari (la tariffazione effettiva dell’account gateway segue le sue regole, che non posso vedere) — a essere economico è il backbone; a costare è la struttura.
Ciò che non ho testato
- Finding 5 (il ribaltamento per difficoltà) non testato. La preregistrazione lasciava spazio a una sonda secondaria: usare le fasce di difficoltà fornite dagli autori per misurare, nel quadrante CrossEp-Know, «sui facili la memoria è negativa, sui difficili è positiva». La sonda è arrivata alla fase pilota quando il credito dell’account gateway si è esaurito e l’ho fermata io; non ha prodotto dati leggibili ai fini di un verdetto. Quindi questo articolo non trae alcuna conclusione su Finding 5: quando compare sopra, è solo come dato dichiarato dagli autori.
- I confronti a contesto lungo dell’articolo (modelli proprietari come Gemini-3-Flash e GPT-5-mini) non posso rieseguirli; i loro punteggi sono citati come dichiarati dagli autori.
- Gli altri tre quadranti, gli altri tredici metodi e il calibro originale DeepSeek-V3.2 dell’articolo sono fuori dall’ambito di evidenza di questo articolo.
Questo si collega bene con il precedente test su questo blog, quello sulla memoria cross-harness di Beacon. La sua conclusione era che la memoria aggiunge valore solo per «la conoscenza che non si può derivare dal repository stesso», e che lo strato di cattura e distillazione automatica è fragile. Le due evidenze hanno forme diverse — quella era un’immersione profonda in un singolo sistema, questa una replica di sottoinsieme dentro un protocollo di confronto orizzontale — ma puntano alla stessa cosa: il guadagno della memoria non esiste mai di default; è una funzione di un insieme di condizioni. La condizione aggiunta stavolta è il budget: più il contesto è economico e ampio, meno vale una memoria salvata in anticipo; e la prima a smettere di funzionare è la classe che fa solo recupero.
Conclusioni
Se stai scegliendo una soluzione di memoria per un Agent, gli usi che questa replica può sostenere sono solo tre. Primo: dichiara il budget prima di parlare di guadagni — per ogni miglioramento vantato da un metodo di memoria, chiedi a quale budget di contesto è stato misurato; salendo di un livello, il guadagno può evaporare per oltre metà. Secondo: scrivi i token del modulo di memoria stesso nella tabella dei costi — il canone della memoria generativa (riflessione, cura, sintesi) può superare un terzo del suo stesso input (in questo caso il 36,5%) e non diminuisce quando il guadagno si restringe. Terzo: in questo tipo di task di chiamate a strumenti, la memoria procedurale (qui ACE) è più forte a entrambi i livelli, ma bisogna pagare le sue chiamate; la memoria a puro recupero azzera per prima il suo guadagno quando il budget è abbondante, ed è adatta solo a scenari in cui il budget è davvero vincolato. E non esportare queste conclusioni fuori da questo ambiente senza pensarci: Finding 7 dell’articolo mostra che in altri domini di esecuzione — ricerca web, ambienti incarnati — la forma di memoria più adatta cambia.
Quanto al benchmark in sé, il mio verdetto è questo: il pattern di restringimento di Finding 3, cambiando endpoint e riducendosi a un sottoinsieme, resta allineato in direzione — ed è la sua parte più utile; solo che l’identità dell’endpoint non è verificabile in modo indipendente, quindi questa è una replica esplorativa tra endpoint, non una prova tra backbone. L’affermazione più tagliente, la caduta sotto la baseline a 128K, nel mio sottoinsieme non si è presentata; per giudicare se vale per più metodi bisognerà che qualcuno esegua i restanti tredici metodi nel calibro originale. Non è una conclusione di questo articolo: è una questione aperta per lavori futuri.
Confini dell’evidenza: tutti i numeri dell’articolo sono dichiarati dagli autori in arXiv:2605.18421 v3; i miei numeri valgono solo per il sottoinsieme, i tre bracci, i due livelli e l’endpoint etichettato da gateway indicati sopra, in una singola esecuzione. La ricevuta completa (conteggi grezzi delle sei celle, scomposizione dei token, registro delle deviazioni e limiti statistici), i dati per task e gli script dell’analisi appaiata sono pubblici insieme a questo articolo (si veda publicRepository in testa), verificabili file per file tramite SHA256SUMS.