Claude Code、Codex 接 API 怎么选:3 种路线的成本与接入对比
每个月给 Claude Code 或 Codex 续订阅的时候,你可能都算过这笔账:Plus 会员 20 美元一个月,用得少觉得亏,用得多又不够分;切官方 API 按量吧,账单没上限心里没底;想自建网关把订阅聚起来,VPS 和 OAuth 配置摆在面前;找家中转商,价格是便宜,但 key 交到别人手里,返回的到底是不是你要的模型,只能赌人品。
我把实际可走的三条路线摆在一起比了一遍:用 CLIProxyAPI 把手里的 CLI 订阅转成兼容 API 自己跑;用 OpenRouter 这类商业中转按量转发;或者直接走模型厂商的官方 API。先说结论,没有最好的网关,只有跟你的用量曲线匹配的成本模型:用量大、且稳定在订阅额度以内,自建订阅聚合通常最划算;用量小,按量付费最省心;中间地带,看你愿不愿意维护一台 VPS。
范围先界定清楚,这篇只谈 Claude Code、Codex 这类 AI 编程 agent 的 API 供应路线,不做通用大模型网关横评。CLIProxyAPI 聚合的是各家 CLI 工具的订阅凭证——按项目文档,支持的上游包括 Codex、Claude Code、Gemini CLI、Grok 等,输出 OpenAI/Gemini/Claude/Codex 兼容接口。拿它去对标通用网关没有意义。
先把成本口径对齐
我一开始想从功能表入手,结果发现功能多少回答不了”钱花在哪”。于是把比较轴换成了成本结构、接入难度和数据流向,这三样才是选型时真正会踩坑的地方。
版本信息也会影响结论,CLIProxyAPI 发版很频繁。我一开始以为看 GitHub releases 的版本号就够了,结果发现还得对照 Docker Hub 的镜像标签——两边都指向 v8.0.27(2026-10-12 发布)才算数,单看一边可能看到的是旧页面的缓存。下面提到的版本号都是截至 2026-10-14 的,动手前对照 Docker Hub 标签确认一眼,这是个好习惯。
自建:订阅加 VPS,成本相对固定
自建方案更适合按固定成本来估算,而不是称作”免费 API”。以每月 20 美元起的订阅加约 5–10 美元 VPS 为例,月支出相对固定,用量越高越容易摊薄——每天高强度用 agent 的人,这条路线通常是最便宜的。
代价是三样东西要自己扛:OAuth 设备码的接入流程、一台 VPS 的长期维护,以及上游订阅的风控风险。我 10 月初在 VPS 上部署时,OAuth 环节就遇到过 Cloudflare 403 和区域超时,最后确认是订阅侧/网络环境的问题,不是网关本身的缺陷。那次部署的完整过程我写过一篇实录,OAuth 之外的 Docker 与客户端配置部分可以直接照抄:Codex 怎么通过 CLIProxyAPI 反代。但自建就是这样,链路上任何一环出幺蛾子,半夜爬起来修的人都是你。
粗算一下平衡点
到底用多少,自建才比按量划算?粗算一笔(假设前提写清楚,不当精确报价):
- 自建固定盘:$20/月订阅 + $5/月入门 VPS ≈ $25/月封顶,用多用少一个价。
- 官方按量盘:以 Sonnet 5.5 级别(输入 $2 / 输出 $10 每百万 token,第三方整理价)为例,每天 100 万输入 + 20 万输出 ≈ $4/天,一个月下来奔着 $120 去。
临界点很直观:每天百万 token 量级的高频用户,自建是把”无底洞”锁死成固定月费;反过来,一周只开几次终端的轻度用户,按量一个月可能就几美元,自建反而多背了一台 VPS 的闲置月租。对号入座就行。
安装实测:v8.0.27,一次成功
这次我在隔离测试机上(Ubuntu 26.04,1 核 / 1.9G 内存)把安装完整重跑了一遍,版本 pin 到 v8.0.27,不用 latest:
docker pull eceasy/cli-proxy-api:v8.0.27 # 292MB,发布页显示 2026-10-12 发布最小配置只需要三行,空上游也能启动:
# config.yaml
config-version: 8
server:
  port: 8317
docker run -d --name cpa-test --restart unless-stopped \
-p 8317:8317 \
-v ./config.yaml:/CLIProxyAPI/config.yaml \
-v ./auths:/root/.cli-proxy-api \
eceasy/cli-proxy-api:v8.0.27启动日志确认版本、Commit 与构建时间(v8.0.27 / bf93416 / 2026-10-12),和 GitHub main 对得上。/ 返回 200 并列出三个兼容端点;/v1/models 在没配上游时返回空列表——这是正常状态,不是报错。
两个实测中发现的细节,教程里值得写清楚:
- 最小配置默认没有鉴权。不配
access.api-keys,任何人都能调你的网关。内网玩玩无所谓,端口一旦暴露到公网,第一件事就是加上 key。 - 容器里访问宿主机别写 127.0.0.1。我一开始把 mock 上游配成
http://127.0.0.1:18888,网关直接报 connection refused——容器里的 localhost 是它自己。用宿主机的 docker 网桥地址(通常是 172.17.0.1)或者--network host。网关的报错倒是很老实,500 里直接写明 dial 失败的原因,排错不费劲。
另外 /health 这个端点在我的测试配置里不存在(404),写健康检查脚本时别照抄通用模板。
网关本身慢多少?实测:约 4ms
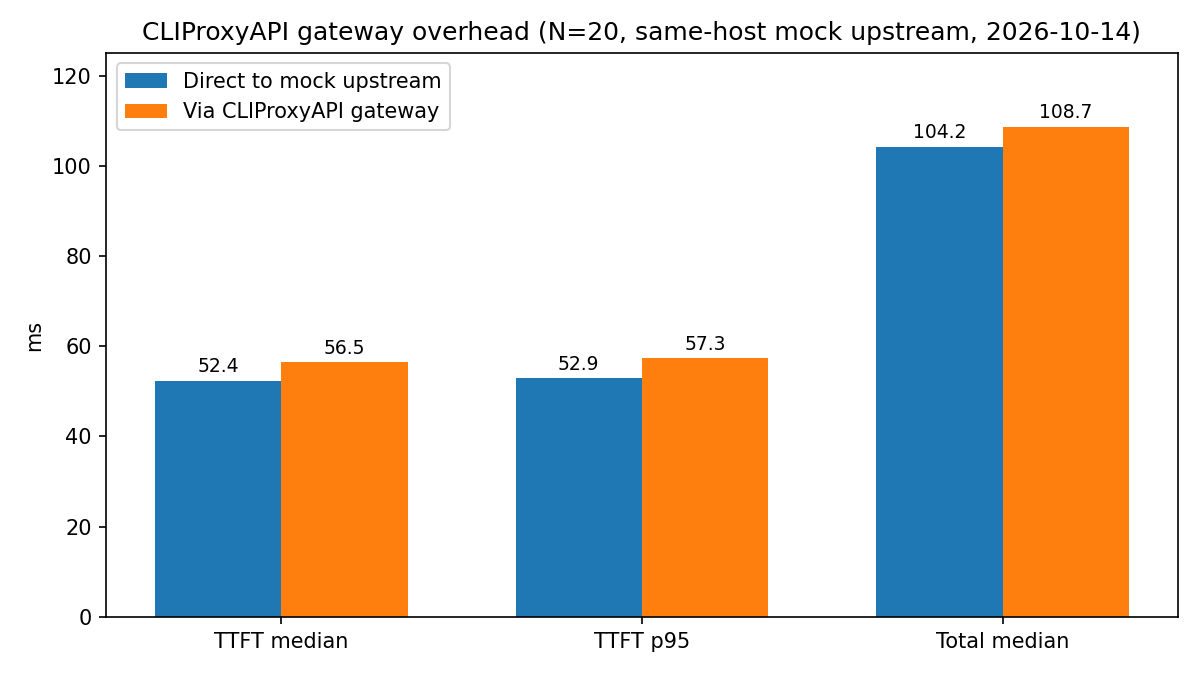
“自建会不会很慢”是选型时最常见的疑问,我直接测了。方法:在同一台机器上起一个 mock OpenAI 上游(首 chunk 固定延迟 50ms),对比”直连 mock”和”经网关再到 mock”,各 20 次,streaming:
| 路径 | 成功率 | 首字延迟中位 | 首字延迟 p95 | 总时长中位 |
|---|---|---|---|---|
| 直连 mock 上游 | 20/20 | 52.4ms | 52.9ms | 104.2ms |
| 经 CLIProxyAPI 网关 | 20/20 | 56.5ms | 57.3ms | 108.7ms |
网关本体只增加了约 4ms,而且 p95 和中位贴得很近,说明开销稳定。结论限定在这次测试条件里:同机、低负载、mock 上游的情况下,自建网关不是瓶颈。你感受到的”慢”,通常来自模型推理和上游网络,而不是多这一跳代理——但高并发或复杂网络环境下的表现,这次没测到。
作为参照,我用手头的一个商业中转(OpenAI 兼容)直连测了 10 次真实模型调用(gpt-6-luna,中转商侧的模型标识,未验证模型指纹):10/10 成功,首字延迟中位 1240ms,p95 1996ms,总时长中位 1745ms。首字延迟主要由模型推理决定——这也反过来印证了上面的结论:网关那 4ms 在端到端体感里可以忽略不计。
部署本身不复杂,容器拉起来后,agent 通过兼容 OpenAI 的地址访问服务。具体端点和认证方式以你用的版本文档为准,下面是调用侧常见的配置形态,示例地址记得换成自己的服务:
from openai import OpenAI

client = OpenAI(
    base_url="https://your-api.example/v1",
    api_key="YOUR_API_KEY",
)如果你不想从零搭,我把当时验证过的部署脚本整理成了一键部署仓库,setup.sh 一把梭,配好 key 就能起服务,适合想省时间的人直接拿去用:
kuangyongjie/cliproxyapi-codex-deploy
OpenRouter:少运维,按量付费
OpenRouter 的成本逻辑正好相反:模型 token 按供应商定价透传,不加价,平台的收费点在充值环节——信用卡充值收 5.5% 手续费(最低 0.80 美元),加密货币 5%。这个费率我交叉核对过三家 2026-10 的独立来源(betterclaw.io、leanroute.dev、calculatorai.app),口径一致;费率以官方定价页为准,本文核验于 2026-10-14。另外它有个 BYOK 模式:绑自己的官方 key,每月 25,000 美元 list-price 额度内免收平台费,超出部分收 5%(同上,以官方页为准)。
接入是三条路线里最省事的:注册、充值,把 OpenAI SDK 的 base_url 指向它,选模型就能跑。官方文档确认了 OpenAI 兼容端点和 drop-in 替换,现有代码几乎不用改:
from openai import OpenAI

client = OpenAI(
    base_url="https://openrouter.ai/api/v1",
    api_key="YOUR_OPENROUTER_API_KEY",
)

response = client.chat.completions.create(
    model="YOUR_MODEL",
    messages=[{"role": "user", "content": "Hello"}],
)
省掉的运维是有代价的:请求先经过 OpenRouter 再到上游供应商。平台默认不存储 prompt 和 completion,只保留元数据,日志可以 opt-in 开启——这是平台自身的默认日志策略;请求最终会到达上游供应商,适用供应商自己的数据政策。对数据敏感的团队,重点不是纠结”存不存”,而是确认请求会经过哪几方——这条在任何商业中转上都适用。
商业中转的风险要讲具体,也要把证据和判断分开。有一项研究指出转售中转存在模型指纹不符的情况,但我没能独立验证原文,这里就不点名任何一家中文中转商。更稳妥的做法是:先小额试用,再核对实际返回的模型指纹和服务行为,对不上就换。凡是只谈价格、不谈验证方法的推荐,都值得警惕。
官方 API:直连作为基准
官方 API 按量付费,直连模型厂商,数据路径最短。它是另外两条路线的参照系:所有”便宜 X%“的宣传,分母都是这里。
OpenAI 和 Anthropic 的具体价格我引用的是第三方整理(2026-10),适合做初步比较;但定价页变得频繁,动手前务必以官方定价页面和 Anthropic 定价页面复核,别把可能变化的价格当成长期数字写进自己的成本模型。
稳定性可以先从架构看,不用等实测数字:自建服务多一个 VPS 单点,出问题自己修;商业平台有路由和 fallback 兜底(是否生效取决于具体模型和故障类型);官方 API 由厂商直接提供服务。落到选择上就三句话:用量大、能维护 VPS、接受订阅风控,看自建;用量小或不想运维,OpenRouter 更直接;对数据路径和直连有硬要求,走官方 API。本文没有比较三者的实际可用性,选型时别把架构分析当成 uptime 承诺。
边界 / 限制
这次实测了两部分:网关本体开销(同机 mock 上游,N=20,+4ms)和商业中转直连的真实体感(手头中转,gpt-6-luna,N=10)。没测的部分:OpenRouter 与官方 API 的在线延迟(没有对应 key)、OAuth 订阅上游的端到端表现(需要浏览器完成 device 登录)、以及 24 小时以上的长时稳定性。网关开销的结论来自 mock 上游——它证明的是”网关本体不慢”,不是”你的上游不慢”。
CLIProxyAPI 的版本号、OpenRouter 的费率、官方定价都可能变化,上面给的是截至 2026-10-14 的核验结果,动手前对照项目发布页、Docker Hub 标签和官方定价页再确认一次。
最后:三句话,帮你定
- 选自建聚合:每天高强度依赖 agent 写代码、手里已有 CLI 订阅、有基础 Linux 运维能力、想把成本锁死。
- 选 OpenRouter:用量中小或波动大、不想伺候服务器、经常在多个模型间切换试效果。
- 选官方 API:对数据路径有合规要求、预算充足、不在乎用量弹性。
相关链接:CLIProxyAPI 项目 · 一键部署仓库 · OpenRouter 快速开始 · OpenRouter 定价