Claude Code y Codex: cómo elegir API y comparar costes
Cada vez que renuevas la suscripción de Claude Code o Codex, quizá haces cuentas: la suscripción Plus cuesta 20 dólares al mes; si la usas poco, parece dinero desperdiciado, y si la usas mucho, no alcanza. Pasarte a la API oficial y pagar por uso te deja con la incertidumbre de una factura sin límite. Montar una pasarela propia para agrupar suscripciones implica lidiar con un VPS y la configuración de OAuth. Y si recurres a un proveedor de intermediación, el precio puede ser más bajo, pero entregas la clave a un tercero y solo puedes confiar en que la respuesta corresponda al modelo que pediste.
He comparado las tres opciones disponibles: usar CLIProxyAPI para convertir las suscripciones CLI que ya tienes en una API compatible que alojas tú; usar un intermediario comercial como OpenRouter y pagar por uso; o conectarte directamente a la API oficial del proveedor del modelo. La conclusión, de entrada, es que no existe una pasarela mejor para todo el mundo: lo importante es que el modelo de costes encaje con tu patrón de uso. Si usas mucho el servicio y te mantienes dentro de los límites de la suscripción, agrupar suscripciones por tu cuenta suele salir más rentable. Si lo usas poco, pagar por uso es lo más sencillo. Para los casos intermedios, la decisión depende de si quieres mantener un VPS.
Primero, aclaremos el alcance. Este artículo trata únicamente de las opciones para acceder a las API de agentes de programación con IA como Claude Code y Codex; no es una comparativa general de pasarelas para modelos de lenguaje. CLIProxyAPI agrupa credenciales de suscripción de distintas herramientas CLI. Según la documentación del proyecto, admite como proveedores upstream Codex, Claude Code, Gemini CLI, Grok y otros, y ofrece interfaces compatibles con OpenAI, Gemini, Claude y Codex. No tiene sentido compararlo con pasarelas de propósito general.
Aclaremos cómo comparar los costes
Al principio quise comparar las funciones, pero descubrí que saber cuántas tiene cada opción no responde a la pregunta de «en qué se va el dinero». Así que centré la comparación en tres aspectos: estructura de costes, dificultad de integración y recorrido de los datos. Son los factores que de verdad pueden darte problemas al elegir.
La versión también influye en la conclusión, y CLIProxyAPI publica cambios con frecuencia. Al principio pensé que bastaba con mirar el número de versión en GitHub Releases, pero también hay que comprobar las etiquetas de las imágenes en Docker Hub. Solo cuando ambas fuentes apuntan a v8.0.27 (publicada el 2026-10-12) puedes darlo por confirmado; si miras una sola, quizá estés viendo una página antigua almacenada en caché. Las versiones mencionadas a continuación corresponden al 2026-10-14. Antes de ponerte manos a la obra, conviene comprobar las etiquetas de Docker Hub.
Autohospedado: suscripción más VPS, costes relativamente fijos
Es mejor calcular el coste de la opción autohospedada como un gasto fijo que llamarla «API gratis». Por ejemplo, con una suscripción desde 20 dólares al mes y un VPS de unos 5–10 dólares, el gasto mensual es relativamente estable y el coste por uso baja cuanto más la utilizas. Para quienes usan agentes a diario y de forma intensiva, esta suele ser la opción más barata.
A cambio, tendrás que encargarte de tres cosas: el flujo de autenticación OAuth mediante código de dispositivo, el mantenimiento continuado de un VPS y los riesgos de control de uso de la suscripción upstream. A principios de octubre, al desplegarlo en un VPS, me encontré con un error 403 de Cloudflare y tiempos de espera agotados por la región durante el paso de OAuth. Al final confirmé que el problema estaba en la suscripción o en el entorno de red, no en la propia pasarela. Escribí un registro completo de aquel despliegue; puedes seguir directamente las partes de Docker y de configuración del cliente, que no tienen que ver con OAuth: Cómo usar CLIProxyAPI como proxy inverso para Codex. Pero así es el autohospedaje: si algo falla en cualquier punto de la cadena, quien se levanta de madrugada a arreglarlo eres tú.
Cálculo aproximado del punto de equilibrio
¿Cuánto hay que usarlo para que el autohospedaje salga más rentable que pagar por uso? Hagamos un cálculo aproximado (con las hipótesis explícitas; no es un presupuesto exacto):
- Coste fijo del autohospedaje: suscripción de 20 $/mes + VPS básico de 5 $/mes ≈ 25 $/mes como máximo, uses mucho o poco.
- Coste de la API oficial por uso: tomemos como ejemplo un modelo del nivel de Sonnet 5.5 (2 $ por millón de tokens de entrada y 10 $ por millón de tokens de salida, según precios recopilados por terceros). Un millón de tokens de entrada más 200.000 de salida al día cuesta unos 4 $ diarios, es decir, alrededor de 120 $ al mes.
El punto de equilibrio se entiende enseguida: para quienes usan un millón de tokens al día de forma intensiva, el autohospedaje convierte un coste potencialmente «ilimitado» en una cuota mensual fija. En cambio, si solo abres la terminal unas pocas veces a la semana, pagar por uso puede costarte unos pocos dólares al mes; al autohospedarte, estarías asumiendo además el coste mensual de un VPS infrautilizado. Elige según tu caso.
Prueba de instalación: v8.0.27, éxito a la primera
Repetí todo el proceso de instalación en una máquina de pruebas aislada (Ubuntu 26.04, 1 núcleo / 1,9 GB de memoria) y fijé la versión en v8.0.27, sin usar latest:
docker pull eceasy/cli-proxy-api:v8.0.27 # 292MB,发布页显示 2026-10-12 发布La configuración mínima solo requiere tres líneas y permite arrancar incluso sin proveedores upstream:
# config.yaml
config-version: 8
server:
  port: 8317
docker run -d --name cpa-test --restart unless-stopped \
-p 8317:8317 \
-v ./config.yaml:/CLIProxyAPI/config.yaml \
-v ./auths:/root/.cli-proxy-api \
eceasy/cli-proxy-api:v8.0.27Los registros de inicio confirmaron la versión, el commit y la fecha de compilación (v8.0.27 / bf93416 / 2026-10-12), en consonancia con GitHub main. / devolvió 200 y mostró tres endpoints compatibles; /v1/models devolvió una lista vacía al no haber ningún proveedor upstream configurado, lo cual es normal y no indica un error.
Estos son dos detalles que descubrí durante las pruebas y que conviene dejar claros en cualquier tutorial:
- La configuración mínima no incluye autenticación de forma predeterminada. Si no configuras
access.api-keys, cualquiera puede usar tu pasarela. Para pruebas dentro de una red privada no pasa nada, pero si expones el puerto a Internet, lo primero es añadir una clave. - Para acceder al host desde el contenedor, no uses 127.0.0.1. Al principio configuré el proveedor upstream simulado como
http://127.0.0.1:18888, y la pasarela devolvió un error de conexión rechazada: localhost dentro del contenedor es el propio contenedor. Usa la dirección del puente de Docker en el host (normalmente 172.17.0.1) o--network host. La pasarela, eso sí, informa del problema con claridad: el error 500 especifica la causa del fallo de dial, así que resulta fácil diagnosticarlo.
Además, el endpoint /health no existe en mi configuración de prueba (404). No lo copies sin más de una plantilla genérica al escribir un script de comprobación de salud.
¿Cuánto añade de latencia la pasarela? La prueba: unos 4 ms
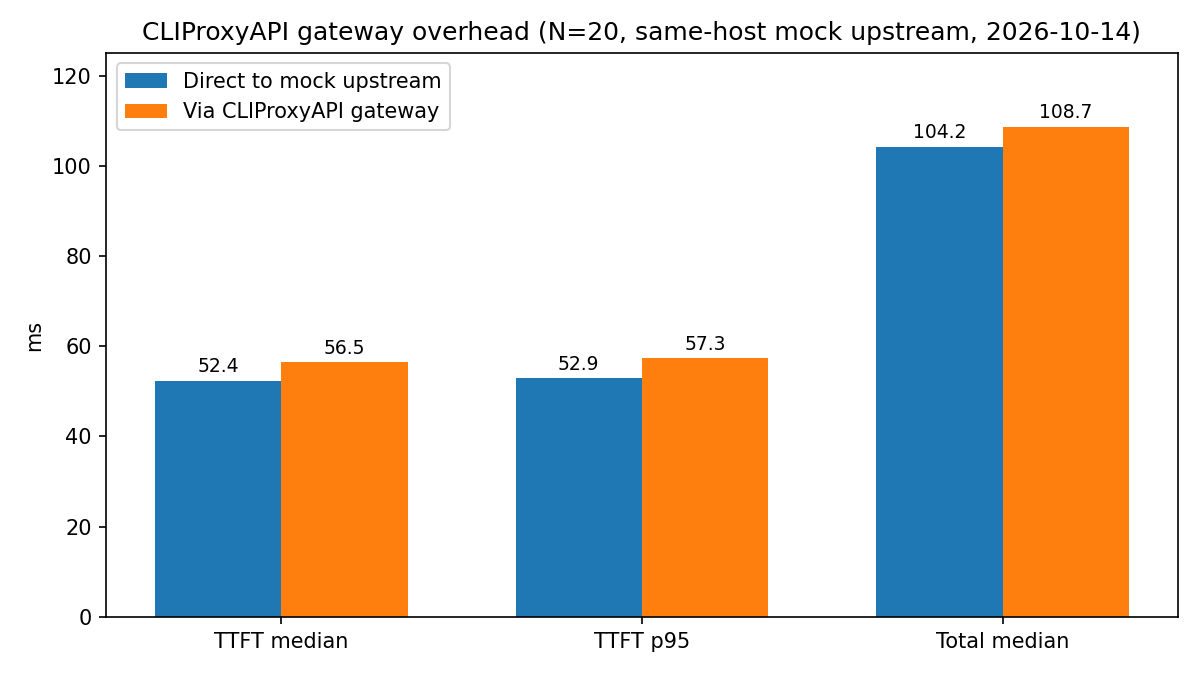
«¿Autohospedarla la hará más lenta?» es una de las dudas más habituales al elegir. Así que lo medí directamente. Método: en la misma máquina, inicié un proveedor upstream simulado compatible con OpenAI, con una demora fija de 50 ms hasta el primer fragmento, y comparé la conexión directa con el mock frente a la conexión a través de la pasarela. Hice 20 pruebas de cada opción con streaming:
| Ruta | Éxitos | Mediana de latencia hasta el primer token | p95 de latencia hasta el primer token | Mediana de duración total |
|---|---|---|---|---|
| Conexión directa al proveedor upstream simulado | 20/20 | 52.4ms | 52.9ms | 104.2ms |
| A través de la pasarela CLIProxyAPI | 20/20 | 56.5ms | 57.3ms | 108.7ms |
La pasarela añadió apenas unos 4 ms, y el p95 quedó muy cerca de la mediana, lo que indica que la sobrecarga es estable. La conclusión se limita a las condiciones de esta prueba: con la pasarela y el mock en la misma máquina, y poca carga, la pasarela autohospedada no es un cuello de botella. La lentitud que percibas suele deberse a la inferencia del modelo y a la red hasta el proveedor upstream, no a este salto adicional por el proxy. No probé, eso sí, qué ocurre con mucha concurrencia o en redes complejas.
Como referencia, también medí 10 llamadas a un modelo real a través de un intermediario comercial que tenía disponible, con compatibilidad con OpenAI: gpt-6-luna (identificador del modelo en el intermediario; no verifiqué su huella). Las 10 llamadas terminaron correctamente; la mediana de latencia hasta el primer token fue de 1240ms, el p95 de 1996ms y la mediana de duración total de 1745ms. La latencia hasta el primer token depende sobre todo de la inferencia del modelo, lo que refuerza la conclusión anterior: esos 4 ms de la pasarela son prácticamente imperceptibles en el uso de extremo a extremo.
El despliegue en sí no es complicado. Una vez iniciado el contenedor, el agente accede al servicio a través de una dirección compatible con OpenAI. Consulta la documentación de la versión que uses para ver los endpoints y el método de autenticación concretos. A continuación tienes un ejemplo del tipo de configuración habitual en el cliente; acuérdate de sustituir la dirección de ejemplo por la de tu servicio:
from openai import OpenAI

client = OpenAI(
    base_url="https://your-api.example/v1",
    api_key="YOUR_API_KEY",
)
Si no quieres montarlo todo desde cero, reuní en un repositorio de despliegue con un solo comando los scripts que había validado en su momento. Con setup.sh puedes ponerlo en marcha de una vez; basta con configurar la clave. Es una opción práctica si quieres ahorrar tiempo:
kuangyongjie/cliproxyapi-codex-deploy
OpenRouter: menos mantenimiento, pago por uso
La estructura de costes de OpenRouter funciona justo al revés: el precio de los tokens del modelo se traslada según la tarifa del proveedor, sin recargo. La plataforma cobra al añadir saldo: un 5,5 % con tarjeta (mínimo 0,80 dólares) y un 5 % con criptomonedas. Contrasté estas tarifas con tres fuentes independientes de 2026-10 (betterclaw.io, leanroute.dev y calculatorai.app), y coinciden. Consulta la página oficial de precios para ver las tarifas vigentes; la comprobación de este artículo es del 2026-10-14. También ofrece un modo BYOK: puedes vincular tu propia clave oficial y no pagar tarifas de plataforma hasta un límite mensual de 25.000 dólares a precio de lista. A partir de ahí, se aplica un 5 % (consulta la página oficial para confirmar las condiciones).
Es la opción más sencilla de integrar: regístrate, añade saldo, apunta base_url del SDK de OpenAI a OpenRouter y elige un modelo. La documentación oficial confirma que ofrece endpoints compatibles con OpenAI y permite sustituirlo directamente; apenas tendrás que modificar el código existente:
from openai import OpenAI

client = OpenAI(
    base_url="https://openrouter.ai/api/v1",
    api_key="YOUR_OPENROUTER_API_KEY",
)

response = client.chat.completions.create(
    model="YOUR_MODEL",
    messages=[{"role": "user", "content": "Hello"}],
)
Ahorrar en mantenimiento tiene un coste: las solicitudes pasan primero por OpenRouter y luego llegan al proveedor upstream. De forma predeterminada, la plataforma no almacena los prompts ni las respuestas (completions), sino solo metadatos; los registros pueden activarse de forma opcional. Esta es la política de registro predeterminada de la propia plataforma. La solicitud acabará llegando al proveedor upstream, cuya política de datos también se aplica. Para los equipos que manejan datos sensibles, la cuestión principal no es obsesionarse con si «se almacenan o no», sino confirmar por qué partes pasa la solicitud. Esto se aplica a cualquier intermediario comercial.
Conviene hablar de los riesgos de los intermediarios comerciales con ejemplos concretos y separar las pruebas de las valoraciones. Un estudio señala que algunos intermediarios de reventa pueden servir modelos cuya huella no coincide con la esperada, pero no pude verificar la fuente original de forma independiente, así que no voy a mencionar a ningún intermediario chino en concreto. Lo más prudente es empezar con una prueba de poco importe, comprobar la huella del modelo que realmente responde y el comportamiento del servicio, y cambiar de proveedor si no coincide. Desconfía de las recomendaciones que solo hablan del precio y no explican cómo verificar el servicio.
API oficial: conexión directa como referencia
La API oficial se paga por uso y conecta directamente con el proveedor del modelo, por lo que el recorrido de los datos es más corto. Sirve como referencia para las otras dos opciones: todas las afirmaciones del tipo «X % más barato» usan esta tarifa como base.
Los precios concretos de OpenAI y Anthropic que cito son recopilaciones de terceros de 2026-10, adecuadas para una comparación inicial. Pero las páginas de precios cambian con frecuencia. Antes de ponerte manos a la obra, comprueba los importes en las tarifas oficiales de OpenAI y las tarifas de Anthropic. No des por hecho que unos precios que pueden cambiar son cifras permanentes para tu modelo de costes.
Para empezar a valorar la estabilidad, basta con mirar la arquitectura; no hace falta esperar a tener cifras de pruebas: el servicio autohospedado añade un único punto de fallo, el VPS, y tendrás que resolver los problemas por tu cuenta. Las plataformas comerciales ofrecen enrutamiento y mecanismos de fallback, aunque su eficacia depende del modelo y del tipo de fallo. La API oficial la proporciona directamente el proveedor. En resumen: si usas mucho el servicio, sabes mantener un VPS y aceptas el riesgo de control de uso de la suscripción, plantéate el autohospedaje; si lo usas poco o no quieres ocuparte del mantenimiento, OpenRouter es más directo; si tienes requisitos estrictos sobre el recorrido de los datos y la conexión directa, usa la API oficial. Este artículo no compara la disponibilidad real de las tres opciones, así que no confundas el análisis de la arquitectura con una garantía de uptime.
Alcance y limitaciones
En esta prueba medí dos cosas: la sobrecarga de la pasarela (mock upstream en la misma máquina, N=20, +4ms) y la experiencia con un intermediario comercial conectado directamente (el que tenía disponible, gpt-6-luna, N=10). No medí la latencia en línea de OpenRouter ni de la API oficial (no tenía las claves correspondientes), el rendimiento de extremo a extremo de una suscripción upstream con OAuth (hace falta completar el inicio de sesión mediante device en el navegador) ni la estabilidad durante más de 24 horas. La conclusión sobre la sobrecarga de la pasarela se basa en un mock upstream: demuestra que «la propia pasarela no es lenta», no que «tu upstream no sea lento».
Las versiones de CLIProxyAPI, las tarifas de OpenRouter y los precios oficiales pueden cambiar. Los datos anteriores corresponden a la comprobación del 2026-10-14. Antes de empezar, vuelve a consultar la página de publicaciones del proyecto, las etiquetas de Docker Hub y las páginas oficiales de precios.
En resumen: tres recomendaciones
- Elige el autohospedaje si dependes de agentes a diario para programar, ya tienes una suscripción CLI, tienes conocimientos básicos de administración de Linux y quieres fijar el coste.
- Elige OpenRouter si tu uso es bajo o moderado, o muy variable; no quieres mantener un servidor y sueles cambiar de modelo para probar resultados.
- Elige la API oficial si tienes requisitos de cumplimiento sobre el recorrido de los datos, cuentas con presupuesto suficiente y no te preocupa que el coste varíe según el uso.
Enlaces relacionados: Proyecto CLIProxyAPI · Repositorio de despliegue con un solo comando · Guía de inicio rápido de OpenRouter · Precios de OpenRouter