Wenn alle KI für Finanzanalysen nutzen: Was ist der echte Burggraben eines Agents?
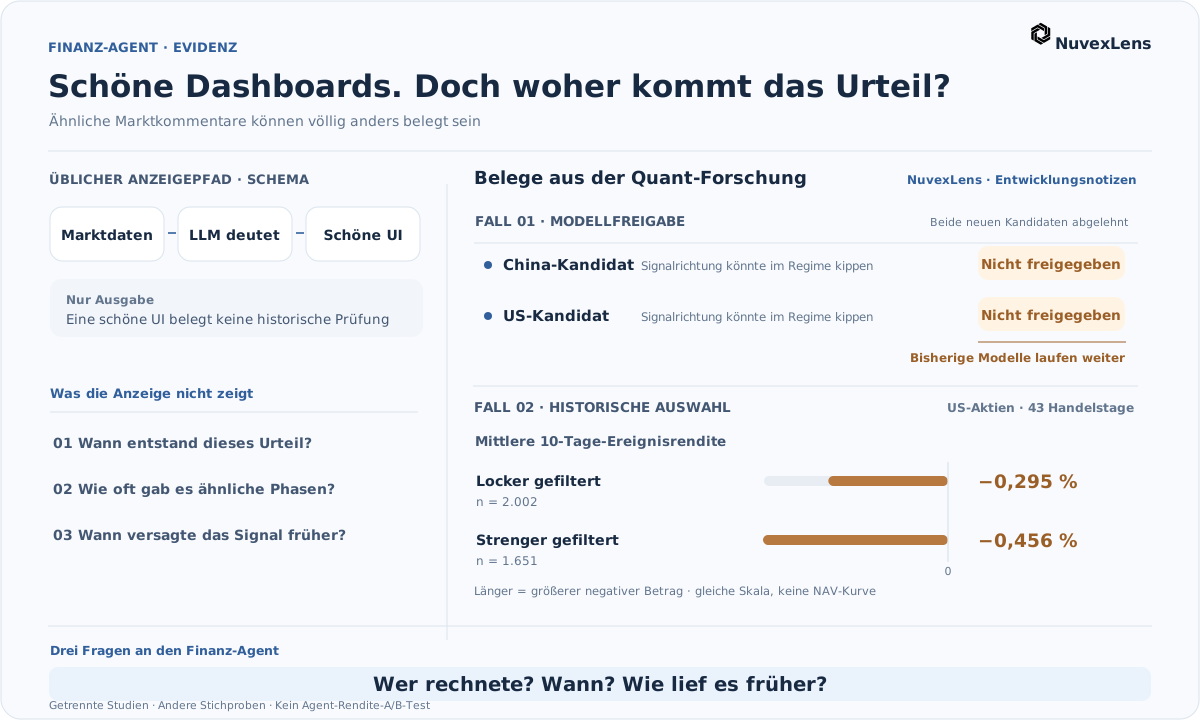
In meinen sozialen Feeds sehe ich zuletzt immer mehr Finanz-Agents im Cyberpunk-Look: dunkle Oberflächen, Neonfarben, animierte Candlestick-Charts und durchgestylte Dashboards. Mit ein paar Sätzen Vibe Coding lässt sich so etwas schnell bauen. Manche Produkte wirken auf mich inzwischen wie aus derselben Fertigungslinie: allgemein verfügbare Marktdaten hinein, eine spontane Interpretation vom LLM, das Ganze in einer anderen Oberfläche wieder ausspielen.
Echtzeitkurse, technische Indikatoren und Orderflow-Analysen können durchaus nützlich sein. Aber wenn man die Effekte abschaltet und nur noch „bullish“ oder „bearish“ übrig bleibt: Worauf beruht das Forschungsurteil?
Marktdaten kann jeder kaufen, LLMs kann jeder nutzen. Wessen Forschungsurteil bringt ein Agent also wirklich in einen Finanzmarkt voller hochspezialisierter Konkurrenten ein? Warum sollte eine schön gestaltete Analyse einen Vorsprung verschaffen? Sind ein paar Prompts an das LLM tatsächlich der entscheidende Burggraben?
Beim Durchsehen meiner NuvexLens-Entwicklungsnotizen fand ich zwei wenig schmeichelhafte Ergebnisse interessanter als jede Produktdemo.
Der Job lief durch, aber das neue Modell wurde nicht freigegeben
Bei einer Produktionsabnahme im Oktober wurden die automatischen Optimierungsjobs für chinesische und US-Aktien vollständig ausgeführt; neue Modellkandidaten entstanden. Beide scheiterten jedoch an einer Sperre für eine mögliche Umkehr der Signalrichtung im jeweiligen Marktregime. Vereinfacht: Die statistische Beziehung eines Signals könnte in dieser Marktsituation die Richtung wechseln. Deshalb durften die neuen Gewichtungen die bestehenden Modelle nicht direkt ersetzen. Das bedeutet nicht einfach, dass eine Prognose über steigende oder fallende Indizes falsch lag.
Ein erfolgreich abgeschlossener Job und eine Freigabe für den produktiven Einsatz sind zwei verschiedene Prüfungen. Die Kandidaten blieben Kandidaten; die bisherigen Modelle liefen weiter.
Von einem ernsthaften Research-Werkzeug erwarte ich langfristig gesammelte historische Daten und wiederholt geprüfte Modelle. Bei einer ähnlichen Marktformation möchte ich wissen, wie oft sie früher vorkam, wie die anschließenden Ergebnisse verteilt waren und in welchen Marktregimen Signale versagten. Die Geschichte wiederholt sich nicht zuverlässig und Modelle liegen nicht immer richtig. Solche Aufzeichnungen entstehen aber durch echte Berechnungen, Tests und Korrekturen – nicht durch einen eleganteren Prompt.
Strengere Auswahl, schlechteres Ergebnis nach zehn Tagen
Eine andere historische Untersuchung zu US-Aktien umfasste 43 Handelstage. Mit strengeren Filtern verbesserten sich einige Drei- und Fünf-Tage-Kennzahlen. Die mittlere Zehn-Tage-Ereignisrendite verschlechterte sich dagegen von −0,295 % auf −0,456 %. Die beiden Filter wählten 2.002 beziehungsweise 1.651 deduplizierte Zehn-Tage-Ereignisse aus.
Gemessen wird hier die Preisänderung innerhalb von zehn Tagen nach einem Signal, nicht der tatsächliche Verlust eines Depots. Ändert sich der Filter, ändert sich auch die Stichprobe. Deduplizierte Datensätze können trotzdem überlappende Zehn-Tage-Haltefenster enthalten. Aus den kürzeren Horizonten „strenger ist besser“ abzuleiten, wäre voreilig.
Bei einer späteren Prüfung der Renditeberechnung fiel mir noch etwas auf: Nach Signaldatum aggregierte Ereignisrenditen über eine Haltedauer sind nicht automatisch die tägliche Nettoinventarwertreihe eines echten Portfolios. Wer darauf Sharpe Ratio oder Drawdown wie auf einer handelbaren Equity-Kurve berechnet, misst womöglich etwas anderes als behauptet.
Genau solche unbequemen Befunde soll ein Agent in seine Antworten mitnehmen: abgelehnte Kandidaten, kurzfristige Verbesserungen ohne langfristige Bestätigung und Kennzahlen, deren Rechenbasis überprüft werden muss. Auch öffentliche Daten und sorgfältig geschriebener Forschungscode können diese Evidenz aufbauen. Wer selbst ein Beispiel prüfen möchte, findet meinen Mehrhorizont-Test von Rank IC und Gruppenrenditen mit öffentlichen ETFs.
Der Agent erklärt. Die Forschung entsteht vorher.
Ich habe außerdem Muse, Metas persönlichen Agent, über eine autorisierte REST-Schnittstelle einen zuvor veröffentlichten NuvexLens-Research-Snapshot lesen lassen. Das war ein separater Integrationstest. Die einzelnen Ergebnisse dieses Snapshots sind bisher nicht den beiden beschriebenen historischen Fällen zugeordnet. Die Schnittstelle liefert bereits vorhandene Forschung an den Agent; die eigentliche Arbeit geschieht vor der Frage.
Ein Diagramm zeichnen zu können bedeutet nicht, dass eine Prognose aufgeht. Heute stelle ich drei Fragen: Wer hat das berechnet? Wann? Wie schnitten ähnliche Urteile in der Vergangenheit ab? Wenn ein Agent das nicht beantworten kann, beantwortet auch ein eloquentes LLM die Frage nach dem Burggraben nicht.
Hinweis: Es geht um historische Forschungs- und Engineering-Befunde, nicht um einen Renditevergleich zwischen einem allgemeinen Finanz-Agent und einem eigenen Modell unter identischen Bedingungen. Keine Anlageberatung.