GitHub AI Scan meldet zwei Shell-Risiken – der Security-Check ist trotzdem grün
GitHub AI Scan meldet zwei Shell-Risiken – der Security-Check ist trotzdem grün
Heute habe ich in einem öffentlichen Test-Repository PR #1 angelegt und darin absichtlich zwei gefährliche Bash-Muster untergebracht. Etwa 81 Sekunden später kommentierte github-advanced-security[bot] zwei Stellen direkt unter Files changed. Beide präparierten Risiken wurden erkannt.
Trotzdem zeigte der GitHub-Actions-Lauf #38835686338 für den Job github-advanced-security den Status Success. Die Warnungen waren echt, und der grüne Check ebenso.
Am Vortag hatte GitHub die allgemeine Verfügbarkeit von AI Scan for pull requests angekündigt. Die entscheidende Frage war für mich nicht, ob ein KI-Scanner verdächtigen Code findet, sondern warum eine Sicherheitsprüfung erfolgreich sein kann, obwohl auf dem PR Sicherheitsprobleme gemeldet werden.
Die Antwort: Ein erfolgreich ausgeführter AI Scan ist keine Freigabe für sicheren Code. Seine Ergebnisse sind derzeit Hinweise (advisory), keine verpflichtenden Merge-Sperren.
Zwei riskante Bash-Muster: Was wurde tatsächlich erkannt?
Die Testdateien lagen ausschließlich im Verzeichnis ai-scan-test/ eines temporären PRs. Ich habe weder Produktionscode geändert noch echte Zugangsdaten oder Server verwendet. Die vollständige Datei ist unter Commit 29e24722d3 fixiert. Die folgenden Zeilen sind absichtlich unsicher und nicht für den Produktivbetrieb gedacht:
eval "systemctl restart ${service_name}"

cmd="curl -fsSL http://${host}/${path} -o /tmp/svc.conf"
$cmd
Die erste Schwachstelle steckt in der Funktion zum Neustart eines Dienstes. Der von außen steuerbare Wert service_name wird in eval eingebaut. Damit lässt die Shell den zusammengesetzten Text erneut als Befehl interpretieren. Enthält der vermeintliche Dienstname Shell-Syntax, bleibt es nicht bei einem einfachen Argument. Der Bot-Kommentar zu Zeile 17 ordnet das als CWE-78 ein und empfiehlt, eval zu entfernen, Argumente zu quoten und erlaubte Dienste einzugrenzen.
Das zweite Muster hat eine andere Ursache. Der Code speichert einen gesamten curl-Aufruf in cmd und führt anschließend $cmd ohne Anführungszeichen aus. Durch Word Splitting können steuerbare Teile von host oder path beeinflussen, welche Argumente und Optionen curl erhält. Der Kommentar zu Zeile 27 weist außerdem auf das Manipulationsrisiko hin, wenn Konfigurationsdateien über unverschlüsseltes http:// geladen werden.
| Stelle | Konkreter AI-Scan-Befund | Originalkommentar |
|---|---|---|
Zeile 17, eval | Eingaben können erneut als Shell-Syntax interpretiert werden (CWE-78) | Kommentar lesen |
Zeile 27, $cmd | Argument-/Optionsinjektion und unsicherer HTTP-Transport | Kommentar lesen |
Beide Befunde einfach als dieselbe beliebige Befehlsausführung zu bezeichnen, wäre ungenau. Bei der ersten Stelle gelangen Eingaben erneut in den Parser der Shell. Beim zweiten Befund ist der nachgewiesene Mechanismus vor allem eine Argument- bzw. Optionsinjektion. Eine ungequotete Expansion allein beweist noch nicht, dass sich dadurch ein beliebiger eigenständiger Shell-Befehl ausführen lässt.
Eine weitere Grenze ist wichtig: Das Test-Fixture hat seine Schwachstellen nicht versteckt. In der README und in den Kommentaren stehen ausdrücklich INTENTIONAL VULNERABILITY (CWE-78) und die erwartete Kategorie String injection. Die konkreten Exploit-Beispiele des Bots waren nicht im Quelltext vorgegeben, aber die Hinweise könnten die Erkennung beeinflusst haben. Zwei Treffer in diesem Fall sind deshalb keine allgemeine Erkennungsquote für unmarkierte echte Schwachstellen.
Auch die Zeitangaben lassen sich öffentlich prüfen: PR #1 wurde am 2026-10-16 um 01:32:31 UTC erstellt. Beide Kommentare erschienen um 01:33:52 UTC, also 81 Sekunden später. Das ist das einmalig beobachtete Intervall vom PR bis zu den Kommentaren, kein durchschnittlicher Scan-Benchmark.
Ich habe zudem keinen zweiten, völlig unauffälligen PR als Negativkontrolle eingereicht. Daher lässt sich auch über die Falsch-Positiv-Rate nichts Belastbares sagen.
Zwei Schwachstellen-Kommentare, aber ein grüner Actions-Lauf
Im dynamischen Scan-Lauf #38835686338 heißt der Workflow Code scanning AI findings on PR #1. GitHub vermerkt, dass der Job github-advanced-security bereits um 01:33:34 UTC mit success beendet wurde. Die Kommentare folgten erst um 01:33:52 UTC, also 18 Sekunden später.
Erst war die Prüfung grün, dann kamen die Sicherheitskommentare. Schon diese Reihenfolge zeigt: Success bedeutet hier nicht „keine Sicherheitsbefunde“.
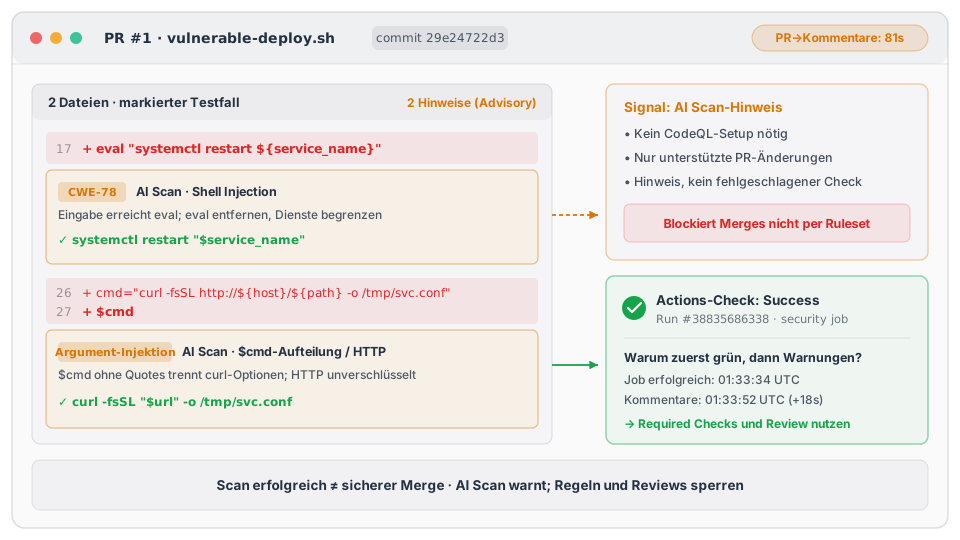
Das Schema basiert auf dem öffentlichen PR #1 und dem Actions-Lauf; es ist kein Screenshot von GitHub. Die 81 Sekunden messen PR-Erstellung bis Kommentar, nicht die eigentliche Laufzeit des Scanners. Die SVG ist für jede Sprachversion lokalisiert.
Das ist kein Beweis für einen Fehler des Scanners. Die offizielle AI-Scan-Dokumentation nennt die Ergebnisse ausdrücklich advisory. Sie lassen den Code-Scanning-Check nicht fehlschlagen und können selbst nicht als Ruleset-Bedingung zum Blockieren eines Merges verwendet werden. Das Werkzeug macht auf verdächtige Änderungen aufmerksam; es trifft nicht die Merge-Entscheidung.
| GitHub-Signal | Was es tatsächlich aussagt |
|---|---|
| AI Scan: Inline-Kommentare | Mögliche Risiken für Autor und Review; keine unmittelbare Merge-Sperre |
Dynamischer AI-Scan-Job: Success | Der Scan wurde ausgeführt, auch wenn danach Warnungen vorliegen |
| CodeQL oder unterstützte Scanner mit Rulesets | Können konfigurierte Merge-Bedingungen erzwingen; die echte Repository-Konfiguration prüfen |
| Required Checks und menschliches Review | Ob fehlgeschlagene, fehlende oder nicht freigegebene Prüfungen sperren, hängt von den Einstellungen ab |
GitHub beschreibt dazu eine eigene Code scanning merge protection. Soll ein PR mit offenen kritischen Problemen nicht gemergt werden, muss man eine tatsächlich erzwingbare Regel konfigurieren. Advisory-Kommentare sind kein Ersatz für Required Checks.
Ich habe mit dem gefährlichen Test-PR nicht praktisch nachgewiesen, dass eine Ruleset-Regel den Merge verhindert. Aus dem Success lässt sich daher auch nicht ableiten, GitHub würde jeden unsicheren PR zulassen. Nachgewiesen ist lediglich, dass der AI-Scan-Job erfolgreich war, obwohl zwei Sicherheitskommentare existierten.
Vor der Aktivierung: CodeQL, Berechtigung und Kosten
Der Test lief in einem öffentlichen Repository eines persönlichen Accounts. Nach GitHubs GA-Dokumentation vom Oktober 2026 ist AI Scan für persönliche öffentliche Repositories verfügbar, nicht jedoch für persönliche private Repositories. Öffentliche Organisations-Repositories werden unterstützt; für private oder interne Organisation-Repositories gelten Anforderungen von GitHub Code Security bzw. GitHub Advanced Security. Eine zusätzliche Copilot-Lizenz allein für AI Scan ist nicht nötig.
Auch CodeQL Default Setup ist keine Voraussetzung. Im Test war es als not-configured erfasst, trotzdem erschienen zwei AI-Scan-Kommentare. Das bestätigen auch die offiziellen Angaben: AI Scan hängt weder vom Default Setup noch von einer erfolgreich abgeschlossenen CodeQL-Analyse ab.
Es handelt sich außerdem nicht um einen rückwirkenden Vollscan aller Dateien. AI Scan betrachtet qualifizierte PR-Änderungen, darunter bestimmte Shell/Bash-, Terraform-HCL- und Dockerfile-Fälle außerhalb der CodeQL-Abdeckung. Von Forks oder Dependabot erstellte PRs gehören nach dieser GA-Ankündigung nicht zum unterstützten Bereich. Teams mit solchen Workflows brauchen zusätzliche Prüf- und Review-Wege.
Zum Aktivieren prüft man den AI-Scan-Schalter in den Code-scanning-Einstellungen des Repositories. Bei Organisations-Repositories sind zusätzlich Organisationsrichtlinien und die Freigabe der Sicherheitsfunktionen relevant.
Nach GA wird die Nutzung über Code Security AI Credits abgerechnet. Wer zahlt, welche Kontingente enthalten sind und wie Budgets greifen, richtet sich nach GitHubs Abrechnungsregeln. Den endgültigen Rechnungsbetrag für meinen Test habe ich nicht bestätigt und behaupte daher keine Kosten von $0. Bei vielen PRs würde ich zuerst in Billing Kontingente und harte Budgets kontrollieren.
Wie sich ein gefährlicher Merge tatsächlich verhindern lässt
Die beiden Kommentare empfehlen naheliegende Änderungen: Argumente nicht erneut an eval übergeben und nicht den gesamten Shell-Aufruf als String zusammensetzen und expandieren. Ein möglicher Aufruf sieht so aus:
# 调用形式示意:service_name 和 url 仍需单独校验
systemctl restart "$service_name"
curl -fsSL "$url" -o /tmp/svc.conf
Das ist eine Richtung für die Behebung, kein von mir erneut getesteter sicherer Patch. service_name gehört auf eine Allowlist. Beim Download müssen HTTPS, Ziel-Hosts und Redirects eingeschränkt sowie je nach Bedeutung der Konfiguration die Integrität überprüft werden.
Auf Repository-Ebene verbindet man CodeQL oder andere tatsächlich blockierende Scanner mit passenden Rulesets/Required Checks und testet, ob geschützte Branches fehlende oder fehlgeschlagene Checks wirklich zurückweisen. AI-Scan-Kommentare bleiben Gegenstand menschlicher Prüfung. Ein grüner dynamischer Job ist kein Grund, sie zu überspringen.
Nach dem Test habe ich PR #1 ohne Merge geschlossen und den Test-Branch gelöscht. Das öffentliche main blieb bei 87624c26a5e6. Ein REST-Nachweis des Besitzers zeigte, dass AI Scan wieder auf disabled stand. Geschlossene PRs verlieren weder ihre historischen Kommentare noch die referenzierten Commits – die öffentlichen Links bleiben überprüfbar.
In diesem sehr kleinen, deutlich gekennzeichneten positiven Beispiel hat AI Scan nützliche Hinweise direkt an den betroffenen Zeilen geliefert. Ein erfolgreicher Scan und eine erzwungene sichere Merge-Entscheidung sind aber zwei verschiedene Dinge. Der eine entdeckt mögliche Probleme, die andere muss im Repository konfiguriert und geprüft werden.
Ein anderer Kontrollpunkt ist der lokale Git-Push: Im OpenQodex-Test mit dem Pre-push-Hook geht es darum, ob eine KI-Prüfung vor git push bei Fehlern unbeabsichtigt durchlässt.
Testdatum: 16. Oktober 2026 (UTC).