# Exposición de datos de KV Cache entre solicitudes, según Cloudflare: ¿por qué SGLang pasó una solicitud rechazada al handoff?
> Canonical: https://vxi.me/es/posts/glm53-kv-cache-cross-request-exposure/
> Locale: es-es
> Published: 2026-10-28
> Updated: 2026-10-29
> Markdown: https://vxi.me/es/posts/glm53-kv-cache-cross-request-exposure.md
Sonda de contraejemplo · Se separan el incidente publicado y la diferencia CPU con versión fijada. No se reprodujo una fuga real entre inquilinos.
En octubre de 2026, Cloudflare publicó que se había producido una exposición de KV cache entre peticiones en GLM-5.3 sobre Workers AI. Según su informe, el incidente ocurrió entre el 27 de agosto y el 9 de septiembre: 155 respuestas resultaron afectadas y todos los prompt relacionados superaban los 681,280 tokens. El informe no indica el número total de peticiones durante ese periodo, así que no permite calcular una tasa de afectación. [Informe del incidente de Cloudflare](https://blog.cloudflare.com/kv-cache-exposure-remediation/) · [Divulgación coordinada de SGLang](https://www.lmsys.org/blog/2026-10-26-cf-security).
Primero, una conclusión para quien no opera un clúster de inferencia: no es un riesgo general de todas las API de IA. Cloudflare indicó que los demás modelos de Workers AI no se vieron afectados y que GLM-5.3 se corrigió y volvió al servicio el 9 de septiembre. El alcance publicado se refiere a peticiones de GLM-5.3 con entradas superiores a 681,280 tokens durante la ventana del incidente. Si solo consumes una API, comprueba primero si tu uso encaja en ese escenario. Si administras tu propio clúster SGLang con prefill y decode separados, puedes ir directamente a las cuatro puertas de aceptación al final.
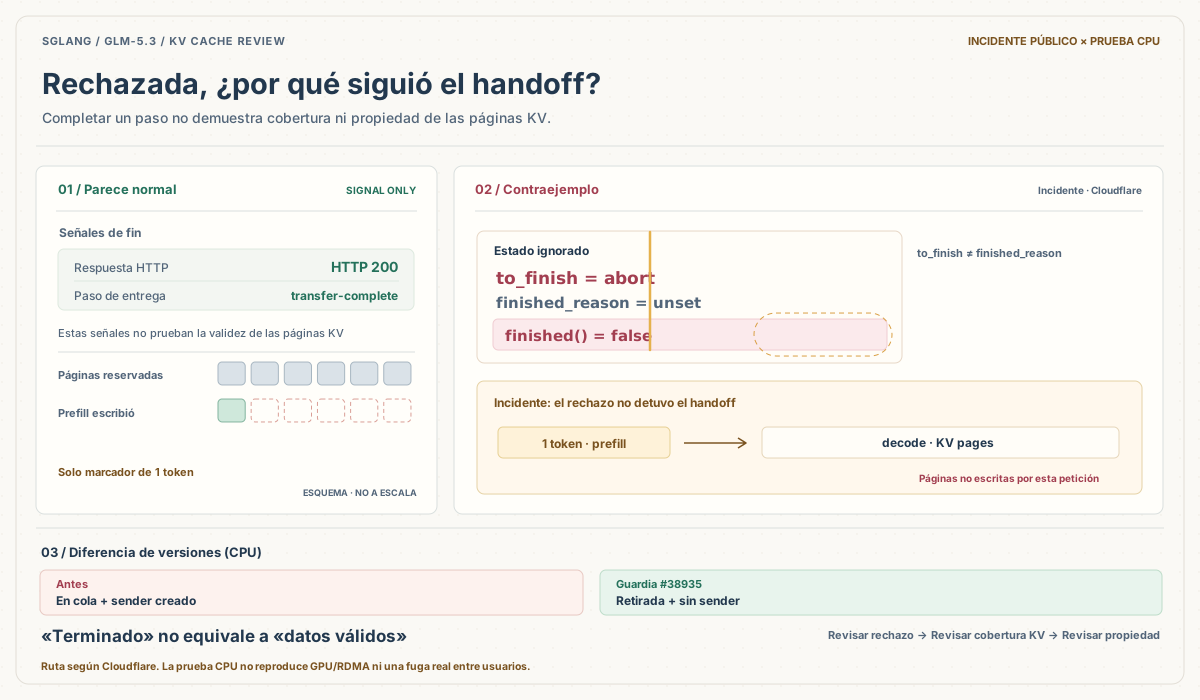
La pregunta útil no es la genérica «¿cómo puede filtrar datos un modelo?», sino una frontera de estado mucho más concreta: **¿por qué una petición ya marcada para ser rechazada pudo entrar en el handoff prefill/decode con un placeholder de un solo token?** Se rechazó, pero el procesamiento continuó; ahí está lo extraño. Se combinaron dos problemas: el límite de context declarado superaba la longitud que podía alojar el KV pool real, y el estado de rechazo no terminaba la petición a tiempo en la entrada de la inferencia disgregada. El primero provocó el rechazo; el segundo permitió que la petición rechazada siguiera por una ruta que no debía recorrer.
**Los siete pasos de la ruta de producción descrita por Cloudflare** (la PR #36988 ya se había fusionado el 6 de septiembre, pero aún no estaba desplegada en producción de Cloudflare cuando el 9 de septiembre se desplegó la corrección del motor): ① **Bootstrap:** el router comunica a decode la longitud original del prompt y decode reserva las páginas KV correspondientes. ② **Prefill admission:** admission comprueba **req.finished()**, pero la causa del rechazo se había registrado en **to_finish**, no en **finished_reason**; por eso la petición podía seguir pareciendo no finalizada y ser admitida. ③ **Prefill forward:** la entrada de prefill se sustituye por un placeholder de 1 token. ④ **KV transfer:** prefill envía solo la página KV correspondiente al placeholder, pero emite la señal transfer-complete. ⑤ **Decode admission:** la misma comprobación del estado final en decode acepta el handoff. ⑥ **Decode attention:** decode lee las páginas KV hasta la longitud reservada, aunque solo la primera la escribió la petición actual; las demás pueden conservar datos de una petición anterior. ⑦ **Response:** Cloudflare informó de que el cliente recibió HTTP 200 en lugar del HTTP 400 esperado, y que la respuesta incluía contenido de la sesión de otro usuario. [El informe de Cloudflare](https://blog.cloudflare.com/kv-cache-exposure-remediation/) describe la secuencia paso a paso. [SGLang issue #30233](https://github.com/sgl-project/sglang/issues/30233) y [PR #38935](https://github.com/sgl-project/sglang/pull/38935) permiten contrastar el problema de estado y la corrección de admission.
Cada paso aislado parece funcionar con normalidad. El problema aparece al unirlos: el rechazo no se hizo efectivo a tiempo, pero las etapas posteriores siguieron procesando la petición como si fuera normal.
## 681,280 y 1,048,576 son capacidades distintas
En la configuración que describió Cloudflare, la longitud de context del modelo estaba fijada en 1,048,576 tokens, mientras que la capacidad del KV pool en la GPU de prefill era de 681,280 tokens en el momento del incidente. Después, Cloudflare elevó el pool a unos 2.04 millones de tokens y añadió una salvaguarda de rechazo en el motor. [Detalles de capacidad y correcciones de Cloudflare](https://blog.cloudflare.com/kv-cache-exposure-remediation/).
El valor 681,280 aparece en el mismo informe con dos significados diferentes: el umbral de longitud de prompt de las peticiones afectadas y la capacidad del KV pool de la GPU de prefill en aquel momento. La cifra coincide, pero la función no. El primer valor describe qué peticiones resultaron afectadas; el segundo, cuánto podía alojar realmente el worker en ejecución.
Son límites distintos. La longitud de context es el límite configurado al que puede llegar una petición; el KV pool es el conjunto de memoria que realmente puede asignar y conservar el estado key/value de los tokens durante la ejecución. Aumentar el context configurado no amplía automáticamente el KV pool a la misma capacidad. Por eso, una petición puede estar por debajo del límite de context declarado y aun así superar el estado KV que el worker actual puede mantener.
La falta de capacidad del pool debería provocar un rechazo. El problema real fue que ese estado de rechazo no detuvo el handoff posterior. Tanto la publicación de Cloudflare como el código upstream señalan una brecha en la propagación del estado abort dentro de la ruta de inferencia disgregada.
## Registrar el motivo del rechazo no significa que admission haya terminado la petición
En la ruta relevante de SGLang, **Req.set_finish_with_abort()** registra el motivo del rechazo en **to_finish** y, al mismo tiempo, sustituye el prompt de entrada por un placeholder de 1 token. Sin embargo, la comprobación **finished()** de entonces leía **finished_reason**. Es decir, el motivo del rechazo estaba registrado en el objeto de petición, pero la función que decide si «la petición ha terminado» todavía podía tratarla como una petición que seguía siendo apta para la planificación normal. Véase la explicación de la causa raíz en [SGLang PR #38935](https://github.com/sgl-project/sglang/pull/38935).
La discrepancia de estado se puede comprobar directamente en el código fuente. Estos son **fragmentos no consecutivos** del commit fijado; las líneas omitidas están señaladas. El contexto completo está en [`set_finish_with_abort()` (L2053–2072)](https://github.com/sgl-project/sglang/blob/8f3d6944b76c428d884582cb6c82a39db1465360/python/sglang/srt/managers/schedule_batch.py#L2053-L2072), [`finished()` (L1479–1481)](https://github.com/sgl-project/sglang/blob/8f3d6944b76c428d884582cb6c82a39db1465360/python/sglang/srt/managers/schedule_batch.py#L1479-L1481) y [`update_finish_state()` (L1842–1848)](https://github.com/sgl-project/sglang/blob/8f3d6944b76c428d884582cb6c82a39db1465360/python/sglang/srt/managers/schedule_batch.py#L1842-L1848):
```python
# Req.set_finish_with_abort() — excerpt
self.origin_input_ids = array(
"q", [0]
) # set it to one token to skip the long prefill
# ... omitted ...
self.to_finish = FINISH_ABORT(error_msg, status_code, err_type)
# Req.finished()
return self.finished_reason is not None
# Req.update_finish_state()
if self.to_finish:
self.finished_reason = self.to_finish
self.to_finish = None
```
Esto no significa que `to_finish` nunca se aplique: después, `update_finish_state()` lo traslada a `finished_reason`. El fallo es que admission comprueba `finished()` antes de que ocurra esa transición.
Antes de que Cloudflare desplegara la corrección del motor el 9 de septiembre, esta discrepancia de estado podía propagarse por el flujo prefill/decode separado. Admission trataba la petición como admisible; decode reservaba suficientes páginas KV; pero prefill procesaba únicamente el placeholder de 1 token y generaba y transfería un estado KV insuficiente. Después, decode podía leer páginas que la petición actual no había sobrescrito. Cloudflare atribuyó la exposición real a datos KV que habían quedado de peticiones anteriores. [Informe de Cloudflare](https://blog.cloudflare.com/kv-cache-exposure-remediation/) · [Issue upstream relacionado #30233](https://github.com/sgl-project/sglang/issues/30233).
Aquí es fácil confundir tres señales de «finalización»:
- **HTTP 200** indica que el cliente recibió un estado HTTP satisfactorio. No demuestra que el significado de la respuesta sea correcto ni que las páginas KV pertenezcan a la petición actual.
- **Prefill completion / transfer-complete** indica que una etapa de procesamiento o transferencia emitió una señal de finalización. No garantiza automáticamente que el número de tokens transferidos cubra todas las páginas reservadas por decode.
- **Que decode lea páginas KV completas y válidas** se acerca más a la condición de datos que importa. Si solo se comprueba que el flujo ha terminado, sin verificar el rango realmente escrito y la propiedad de las páginas, se puede confundir «la transferencia terminó» con «los datos están completos y pertenecen a esta petición».
Que el flujo termine no significa que los datos sean correctos.
## #36988, #38935 y #38704 no fueron una única corrección
Importan tanto la secuencia temporal como la función de cada registro upstream.
| Fecha / registro | Estado | Qué resolvió realmente |
| --- | --- | --- |
| 2026-07-06, [issue #30233](https://github.com/sgl-project/sglang/issues/30233) | Cerrado | Informe temprano de un problema parecido en PD disaggregation, donde un prompt largo solo transfería 1 token. No es una reproducción independiente del incidente completo de producción de Cloudflare. |
| 2026-09-06, [PR #36988](https://github.com/sgl-project/sglang/pull/36988) | Fusionada; Cloudflare la asoció a la versión v0.5.20 | Corrigió la finalización y limpieza de resultados de prefill abortados: borrar el estado de chunks pendientes, no volver a encolar resultados abortados como incompletos, liberar recursos como metadata/KV/HiCache/Mamba e ignorar resultados tardíos de peticiones ya retiradas. Corrige un fallo de corrección. |
| 2026-09-16, [PR #38935](https://github.com/sgl-project/sglang/pull/38935) | Fusionada; Cloudflare la asoció a la versión v0.5.21 | Termina antes, en las entradas de admission de prefill y decode, las peticiones rechazadas que aún no habían entrado, evitando bootstrap, metadata buffer, inicialización de sender/receiver y forward pass innecesarios. Su autor aclaró que reduce desperdicio de recursos y latencia; no es una segunda corrección independiente de correctness después de #36988. |
| Creada el 2026-09-09, cerrada el 2026-10-10, [PR #38704](https://github.com/sgl-project/sglang/pull/38704) | Cerrada, no fusionada; sin versión publicada | Otra defensa propuesta por Cloudflare. No debe describirse como una corrección incorporada a la línea principal upstream. |
La descripción de #38935 aporta un punto temporal importante: en un main posterior a #36988, decode dejó de enviar el handoff insuficiente. La PR upstream también muestra una comparación de comportamiento 1P1D (2×H200) antes y después: tras fusionar #38935, decode pasó de esperar 300 segundos hasta un timeout a devolver 400 de inmediato; dejaron de crearse bootstrap/metadata buffer y el stub batch pasó de 1 a 0. Es una comparación publicada por upstream, no una prueba de rendimiento ejecutada por este artículo.
Por eso, la protección de entrada no se puede simplificar como «si **to_finish** no está vacío, termina la petición». #38935 usa **is_unadmitted_reject** para identificar las peticiones rechazadas que aún no han entrado ni adquirido responsabilidad sobre recursos. Una petición que vuelve a entrar o que ha sido desalojada puede tener ya recursos KV o metadata; no debe descartarse antes de tiempo solo por una marca abort. Decode también debe contemplar la reentrada, porque parte del estado de los recursos puede no permanecer en el objeto **Req**. Terminar demasiado pronto puede saltarse la limpieza que corresponde a la ruta normal de planificación, por ejemplo el active slot detach de una streaming session (liberar el slot activo que ocupa la sesión). [SGLang PR #38935](https://github.com/sgl-project/sglang/pull/38935).
Después llegaron otras defensas relacionadas, pero dirigidas a fallos diferentes. [PR #39500](https://github.com/sgl-project/sglang/pull/39500) añadió un checksum KV opcional para el handoff. Cloudflare también describió KV canary, que detecta y registra posibles corrupciones, y read-time page tagging. Este último era un prototipo probado en verano de 2026, ensayado en GLM-5.2 y desactivado después por problemas de fiabilidad; depende de determinados attention backend y arquitecturas de modelo, por lo que no es una defensa universal desplegada actualmente. Cloudflare explicó que checksum y canary aún no cubrían todas las arquitecturas, y que el soporte de GLM-5.3 seguía ampliándose. El checksum del handoff verifica la transferencia de prefill a decode, no todas las lecturas posteriores de decode.
[PR #40645](https://github.com/sgl-project/sglang/pull/40645) y [PR #41402](https://github.com/sgl-project/sglang/pull/41402) corrigen conjuntamente la pérdida de confirmaciones de drain o la falta de cobertura de todos los decode peer. [PR #41404](https://github.com/sgl-project/sglang/pull/41404) amplía deferred release a otros fallos de transferencia, no solo a abortos iniciados por decode, para evitar liberar o reutilizar páginas mientras una escritura RDMA en curso todavía pueda tocarlas. Estas correcciones tratan carreras del ciclo de vida de las páginas KV, una ruta de fallo distinta del handoff insuficiente determinista de una petición rechazada. [Defensas y versiones descritas por Cloudflare](https://blog.cloudflare.com/kv-cache-exposure-remediation/).
## Validación CPU con versión fijada: se verificaron rutas de código, no se reprodujo una fuga entre tenants
La comprobación no se limitó a leer el informe y las PR. La evidencia se dividió en tres capas, cada una con un alcance diferente.
| Evidencia | Resultado observado | Qué permite afirmar |
| --- | --- | --- |
| Máquinas de estados sintéticas en Python | Modelo handoff 6/6; modelo admission / re-entry 9/9 | Los guardas de los modelos simplificados construidos se comportan como se esperaba; no demuestra el comportamiento de SGLang en ejecución. |
| Pruebas unitarias CPU upstream de SGLang con commit fijado (P1) | 19 passed entre dos archivos; la prueba de admission incluye además 12 subtests | Se ejecutó código upstream real de mixin, queue y retire en la versión fijada. Algunos colaboradores de transport/cache/scheduler seguían siendo Mock. No se ejecutó un clúster real de prefill/decode. |
| Diferencias antes/después (P2) | Se observaron cambios tanto en la diferencia de admission de #38935 como en la limpieza de prefill de #36988 | Las entradas fijadas recorrieron rutas de código diferentes en ambas versiones. Los resultados se limitan al código CPU y al comportamiento de las sondas. |
P1 está fijada al commit de SGLang **8f3d6944b76c428d884582cb6c82a39db1465360** ([fuente fijada](https://github.com/sgl-project/sglang/commit/8f3d6944b76c428d884582cb6c82a39db1465360)). Se ejecutaron las pruebas upstream **test_prefill_abort_result_cleanup.py** (11 passed) y **test_admission_abort_not_enqueued.py** (8 passed, más 12 subtests), 19 passed en total. El entorno fue una VM Linux solo CPU con Python 3.12.3, pytest 9.2.0 y torch para CPU. No se usaron GPU, pesos de modelo, RDMA ni datos de tenants.
P2 aisló las versiones anterior y posterior de cada PR para no mezclar varias correcciones en una sola comparación:
- **Experimento A: entrada admission de #38935 (base [17ba2c2e](https://github.com/sgl-project/sglang/commit/17ba2c2e7c7b81f31a8a9e693e7435ab262c16b4) → head [8f3d6944](https://github.com/sgl-project/sglang/commit/8f3d6944b76c428d884582cb6c82a39db1465360)).** Antes de la corrección, las peticiones rechazadas en la entrada todavía entraban en la cola y provocaban la creación de sender/receiver. Después, se retiraban en la entrada sin crear esos objetos de handoff. Las peticiones válidas y las peticiones de reentrada con metadata buffer se conservaron en ambos árboles; no se observó que se retiraran por error.
- **Experimento B: limpieza del resultado prefill de #36988 (base [9c254df8](https://github.com/sgl-project/sglang/commit/9c254df8cdbe99ef5f58e7fcd932da052f258538) → head [2ee5742a](https://github.com/sgl-project/sglang/commit/2ee5742af92db2727236460473554c2ee8c4ddaa)).** La sonda observó que, antes de la corrección, el resultado final de un abort podía tratarse como caché incompleta y volver a la cola inflight; los resultados tardíos de peticiones ya retiradas podían todavía enviar chunks KV. Después de la corrección, la limpieza se completó como se esperaba y los resultados tardíos dejaron de provocar esos efectos secundarios.
El 7/7 de P2 y los 11 passed de P1 proceden de versiones distintas. P2 usa los siete casos presentes en el head de #36988, **2ee5742a**. La versión fijada **8f3d6944** de P1 añadió después pruebas parametrizadas de sampling-mask, ampliando ese archivo a once casos. Por tanto, **0/7 → 7/7** compara los mismos siete casos antes y después, y no debe sumarse a los once aprobados de P1. Los siete fallos pre-fix de P2 fueron seis excepciones **AttributeError** y una **ValueError**, causadas porque el código cayó en la ruta normal de transfer que el stub de prueba no modelaba. No fueron siete aserciones funcionales fallidas. La evidencia más útil son los efectos observados en la reentrada en cola, la limpieza y el envío tardío.
### Evidencia pública para revisión
He publicado los dos probes diferenciales, cuatro salidas JSON originales, el recibo P2 y una lista de checksums SHA-256 en el [paquete público de evidencia](/evidence/glm53-kv-cache-cross-request-exposure/README.md). Se fijan ambos pares de commits base/head y se documentan los límites de los colaboradores Mock y del entorno solo CPU. El 0/7 pre-fix se debe a stub fall-through (seis `AttributeError` y un `ValueError`), no a siete fallos de aserción. Estos artefactos muestran diferencias observadas entre rutas de código en versiones fijadas; no reproducen una fuga real entre tenants ni un fallo GPU/RDMA.
## Cuatro puertas que conviene validar en producción
Si administras inferencia multi-tenant o una arquitectura SGLang con prefill y decode separados, es tentador decir: «actualizo a v0.5.22, envío un prompt largo, veo HTTP 400 y listo». No basta. La configuración y el ciclo de vida de los recursos tienen rutas que una comprobación de versión no cubre. Separaría la aceptación en cuatro puertas independientes:
1. **Pool / context gate: ¿coincide la configuración con la capacidad en ejecución?** Tras arrancar el worker, compara la capacidad del KV pool que aparece realmente en los logs de inicio con la configuración de context. Revisa de nuevo esos logs después de cambios en configuración, partición de GPU o concurrencia. Incluye un caso negativo en el que la entrada no supera el límite de context, pero sí la capacidad actual del KV pool, y confirma que el sistema la rechaza explícitamente en vez de continuar el handoff.
2. **Reject / admission gate: ¿se aplica el rechazo en la entrada?** Comprueba que una petición rechazada se retire antes de bootstrap, queue admission, asignación de metadata buffer e inicialización de sender/receiver. No pruebes solo peticiones nuevas: incluye peticiones válidas, reentrada, preempción y peticiones que aún mantienen recursos KV, Mamba o metadata. No descartes todas las peticiones con estado abort; podrías romper la responsabilidad de limpieza de sus recursos.
3. **Transfer / read gate: ¿el rango transferido cubre el rango leído?** Compara el número de tokens/páginas reservados con el rango válido realmente escrito y transferido. HTTP 200 y transfer-complete no sustituyen la validación de longitud y propiedad. Si vas a usar --disaggregation-enable-kv-checksum o --kv-canary, confirma primero que el modelo y backend actuales lo soportan y revisa los logs para comprobar que la petición pasó realmente por la validación. Cuando Cloudflare publicó el incidente, estos mecanismos no cubrían todas las arquitecturas, incluida GLM-5.3. Una opción no soportada no cuenta como defensa activa; el checksum de handoff tampoco valida cada lectura de decode.
4. **Lifetime / ownership gate: después de un fallo, ¿cuándo se pueden liberar o reutilizar las páginas?** Añade pruebas negativas para abortos, resultados tardíos y escrituras RDMA en curso. Asegura que las escrituras sin terminar no contaminen páginas reasignadas, que los resultados tardíos de peticiones retiradas no envíen más chunks y que cada recurso se libere una sola vez. Confirma que deferred KV release está activado tanto en prefill como en decode. En Mooncake, revisa también la compatibilidad entre el límite de transfer batch y el release timeout para evitar una cola larga de escrituras en curso tras un timeout. Las versiones que incluyen [PR #41023](https://github.com/sgl-project/sglang/pull/41023) activan deferred release por defecto en los backends compatibles, pero hay que comprobar la versión y configuración reales. #40645 y #41402 tratan las confirmaciones de drain; #41404, la liberación diferida para otros fallos de transferencia. Estos riesgos del ciclo de vida deben verificarse por separado del defecto original de handoff determinista.
SGLang [v0.5.22](https://github.com/sgl-project/sglang/releases/tag/v0.5.22) se publicó el 19 de octubre de 2026. Cloudflare recomendó v0.5.22 o posterior, o aplicar mediante backport las correcciones correspondientes cuando fuera necesario. Pero «actualizado de versión» no significa «despliegue aprobado en aislamiento». Hay que comprobar la versión real del código en ejecución, la configuración pool/context, los casos negativos de admission y el ciclo de vida de las páginas. Si checksum u otra función no está activada, no debe contarse como defensa efectiva.
La lección no es que un booleano estuviera mal. El estado de rechazo, la integridad de los datos y la propiedad de los recursos son fronteras distintas. Que el objeto de petición contenga el motivo del rechazo no significa que admission lo detecte; que una transferencia termine no significa que todas las páginas leídas por decode fueran escritas por la petición actual; que se emita un abort no significa que hayan terminado todas las escrituras en curso. Verificar cada frontera por separado evita tomar una ruta que parece exitosa como prueba de aislamiento real de datos.
*Fecha de las pruebas: 28 de octubre de 2026.*
## Verification context
- Level: source-inspected
- Verified: 2026-10-28T00:00:00.000Z
- Environment: Linux; AMD EPYC 9D25; 2 vCPU; 7 GB RAM
- Environment: Python 3.12.3; pytest 9.2.0; torch 2.14.1+cpu
- Evidence mode: mixed
- Public repository: https://github.com/sgl-project/sglang
- Evidence commit: 8f3d6944b76c428d884582cb6c82a39db1465360
- Evidence receipt: https://vxi.me/evidence/glm53-kv-cache-cross-request-exposure.json