# Warum eine getreue SAE-Replikation trotzdem keine Sparsity erzeugte
> Canonical: https://vxi.me/de/posts/sae-crypto-factor-replication-lambda/
> Locale: de-de
> Published: 2026-11-01
> Updated: 2026-11-01
> Markdown: https://vxi.me/de/posts/sae-crypto-factor-replication-lambda.md
Prüfung, ob der Sparsity-Mechanismus der SAE auf unserem reduzierten Binance-Panel tatsächlich gegriffen hat. Die Werte stammen aus unserer eigenen Replikation und bewerten nicht das ursprüngliche Panel der Autoren.
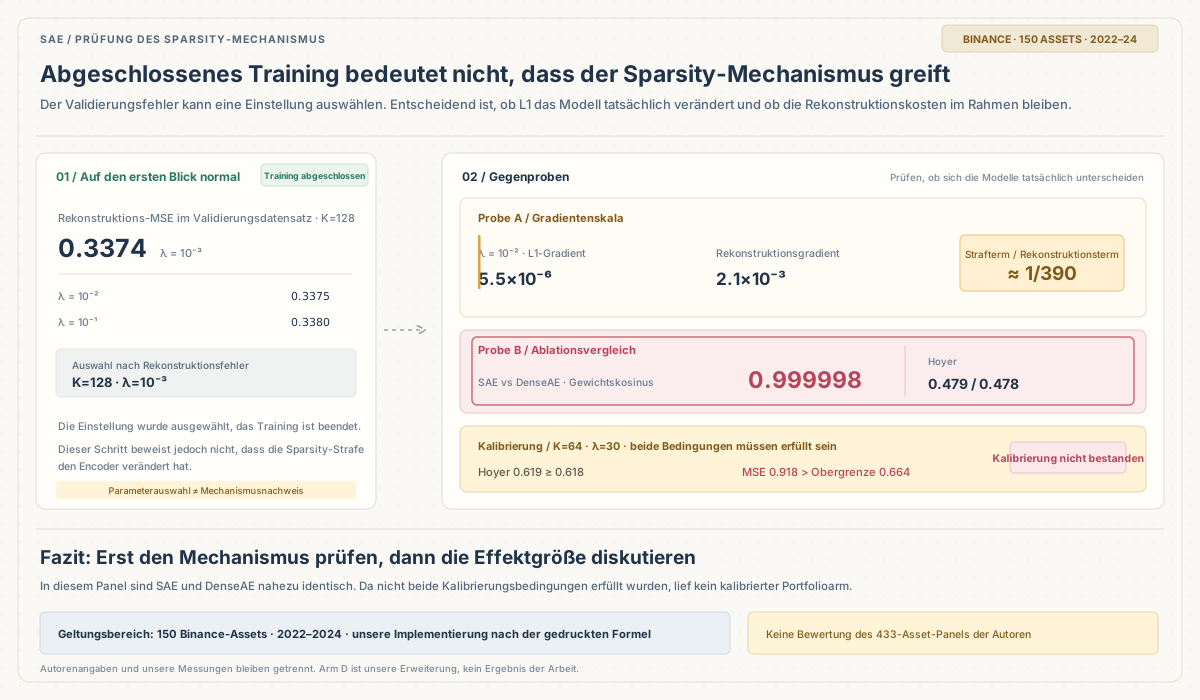
Nachdem das erste Vergleichsmodell trainiert war, habe ich die Gewichte der SAE mit denen ihrer dichten Kontrolle (DenseAE, λ=0) verglichen. Encoder und Decoder teilen sich dieselben Parameter. Die Kosinusähnlichkeit dieser gebundenen Gewichte lag bei 0.999998. Anders gesagt: Das Modell mit Sparsity-Strafe und das Modell ohne Strafe waren praktisch dasselbe Modell. Auch die Hoyer-Sparsity (Skala 0 bis 1, höhere Werte bedeuten stärkere Sparsity) war mit 0.479 gegenüber 0.478 nahezu identisch. Über fünf Folds lag die Prediction-IC bei beiden bei +0.0073; auch die Portfolioergebnisse unterschieden sich kaum.
Damit hatte ich beim ersten Vergleich nicht gerechnet. In der Studie, die ich reproduzieren wollte, ist Sparsity der Motor der gesamten Erklärung: Die L1-Strafe soll die Codes ausreichend dünn machen, sodass die anhand der Rekonstruktionswerte gewählten Baskets weniger miteinander korrelieren und die Volatilität sinkt. Wenn Sparsity gar nicht auftritt, bestätigen ähnlich aussehende Folgekennzahlen nicht den Mechanismus der Studie.
Dieser Artikel dokumentiert den gesamten Replikationslauf: was übereinstimmte, was nicht, und vor allem, worauf die Evidenz bei den Abweichungen tatsächlich hindeutet.
## Was die Studie behauptet – und wie belastbar die Aussagen sind
Die Studie von Han und Qu (University of Washington) wurde für ICAIF '26 angenommen. Die Forschungsfrage ist konkret: Tägliche Querschnittsrenditen werden in einen einschichtigen Sparse Autoencoder eingespeist; dessen Rekonstruktionswerte sortieren die Assets, aus denen konträre Quintil-Portfolios gebildet werden. Sinkt das Risiko durch Sparsity selbst?
Die Autoren unterscheiden drei Evidenzstufen. Diese Trennung ist wichtig:
- **Streng bestätigt:** Nach einer Vorauswahl von K=128 und λ=0.1 auf den ersten 748 Tagen hatten die SAE-Baskets in allen fünf Bestätigungs-Folds eine um 20–26% niedrigere Volatilität auf Rank-Skala als PCA mit demselben K.
- **Explorativ:** Bei K=64 war die Volatilität um 32–37% niedriger (20.0% gegenüber 27.3% auf der Money-Skala). Das Auswahlfenster überlappte jedoch mit frühen Test-Folds; daher ist dies nur explorative Evidenz. Als Mechanismus nennen die Autoren eine niedrigere mittlere paarweise Korrelation innerhalb der Baskets: 0.008 gegenüber 0.039 bei PCA.
- **Von den Autoren ausdrücklich verneint:** SAE lieferte keinen zusätzlichen Sharpe gegenüber der einfachsten Same-Day-Reversal-Baseline (Differenz −2.48 auf Money-Skala). Die Faktoridentität reproduzierte sich nicht über Zufalls-Seeds hinweg (Decoder-Matching-Cosine 0.13 gegenüber einer Zufallsdictionary-Referenz von 0.117). Ein Ledoit–Wolf-Minimum-Variance-Overlay holte außerdem etwa 73% des Volatilitätsvorteils von SAE gegenüber der naiven Baseline zurück.
Die Autoren nennen selbst drei Einschränkungen: Signale werden am Schlusskurs von Tag t gebildet und zum selben Schlusskurs ausgeführt – laut Autoren "praktisch nicht ausführbar". Kosten werden durchgehend ignoriert. Die Auswahl des Krypto-Universums verwendet Informationen aus dem gesamten Zeitraum und ist nicht point-in-time. Eine weitere wichtige Information fehlt: Stand 2026-11-01 verlinkten weder die Studie noch die arXiv-Seite Code; auch die exakte Liste der 433 Assets war nicht veröffentlicht. Eine Replikation muss daher das gedruckte Protokoll selbst implementieren, und das Panel ist zwangsläufig anders. Das bestimmt die Reichweite meiner Schlussfolgerung: Ich prüfe die Übertragbarkeit der Aussagen, nicht, ob der Lauf der Autoren auf ihrem eigenen Panel richtig oder falsch war.
## Mein Replikationsaufbau: Abweichungen zuerst
Ich verwendete tägliche Binance-Spot-USDT-Klines über die öffentliche API. Ein Konto oder API-Key war nicht nötig. Die Regel zur Fixierung des Universums stand vor dem Training fest: Von 519 aktuell gelisteten Paaren hatten 285 Daten im Fenster 2022–2024; 245 erfüllten die Bedingung von mindestens 252 Beobachtungstagen. Daraus wurden die 150 Assets mit dem höchsten Median des täglichen Quote-Volumens ausgewählt. Liste und Hash wurden vor dem Training gespeichert. Pro Tag waren 89 bis 150 Assets verfügbar, im Mittel 119.
Die Abweichungen zur Studie sind explizit: 150 statt 433 Assets, beschränkt auf liquide Werte; 2022–2024 statt 2019–2024; und eine Liste aus heute noch gehandelten Paaren, also mit Survivorship-Tilt. Die Studie behielt delistete Assets bis zu ihrer letzten Notierung. Survivorship-Filter senken die Volatilität dieses Panels systematisch – und genau die Volatilität ist der zentrale Vergleich dieses Artikels. Die Größe dieses Bias lässt sich nicht nachträglich rekonstruieren: Delistete Assets stehen nicht mehr in der aktuellen Handelsliste und können daraus nicht gezählt werden. Die Panel-Verarbeitung folgt der Studie: tägliches Cross-Sectional-Winsorizing bei 1/99%, fehlende Werte höchstens drei Tage vorwärts auffüllen und danach maskieren, anschließend eine geclippte inverse-normal Rank-Transformation. Das Auswahlfenster umfasst die ersten 500 Renditetage (450 Training / 50 Validation). Die Parameter werden ausschließlich anhand des Validierungs-Rekonstruktionsfehlers aus K∈{32,64,128} × λ∈{10⁻³,10⁻²,10⁻¹} × dem Learning-Rate-Raster gewählt. Danach folgen fünf expanding walk-forward-Folds mit je 119 Signaltagen. Der letzte Signaltag jedes Folds entfällt, weil dafür die Rendite des Folgetags benötigt wird; es bleiben 590 Auswertungstage. Die Portfolios sind konträre Quintile nach Rekonstruktionsrang, gleich gewichtet, mit gross 1 pro Leg. Fehlende t+1-Renditen werden als null behandelt. Diese Entscheidungen entsprechen der Studie.
Zwei Gates wurden ebenfalls vorab registriert. Die Abbruchbedingung lautet: Reproduziert sich die Richtung der Volatilität im verkleinerten Universum nicht, wird das ehrlich als non-replication berichtet. Das Universum wird nicht erweitert und die Parameter werden nicht so lange angepasst, bis das Vorzeichen passt. Das Kalibrierungstor erlaubt nur dann einen zusätzlichen Arm, wenn die Diagnose zeigt, dass λ nicht greift: Innerhalb des Auswahlfensters darf ein λ gewählt werden, das "das Sparsity-Ziel erreicht und die Rekonstruktionskosten kontrolliert". Gibt es keinen Wert, der beide Bedingungen erfüllt, wird der Arm nicht ausgeführt. Das Testset darf nicht nachträglich zur Änderung der Regel dienen.
## Das erste Problem: λ ist auf diesem Panel wirkungslos
Zunächst die Parameterauswahl. Bei K=128 ist der Validierungs-MSE über λ hinweg nahezu flach: 0.3374 bei λ=10⁻³, 0.3375 bei 10⁻² und 0.3380 bei 10⁻¹. Die Regel wählte K=128, λ=10⁻³. Auf dem Panel der Autoren wurde dasselbe K gewählt, aber mit dem stärksten λ=0.1. Dieselbe Auswahlregel führte auf den beiden Panels also zu entgegengesetzten Präferenzen für die Strafstärke. Eine Auswahl nur nach Rekonstruktionsfehler bevorzugt systematisch die schwächste Strafe, weil L1 die Rekonstruktion nur erschweren kann. Dass ich 10⁻³ auswählte, war unter dieser Regel fast zwangsläufig. Die Studie berichtet dagegen, unter derselben beschriebenen Regel den stärksten Wert 0.1 gewählt zu haben. Diese Spannung sollte festgehalten werden: Entweder schadete eine starke Strafe auf ihrem Panel der Rekonstruktion tatsächlich nicht, oder ein Teil des Auswahlprozesses wurde nicht beschrieben.
Die direkte Gradientenmessung ist noch eindeutiger. Bei λ=10⁻², der explorativen Einstellung der Studie, beträgt der mittlere Betrag des L1-Gewichtsgradienten 5.5×10⁻⁶, der des Rekonstruktionsterms 2.1×10⁻³. Die Strafe erreicht nur etwa 1/390 des Hauptterms; beide liegen nicht in derselben Größenordnung. In einer separaten Diagnose – erneutes Training auf den ersten 500 Tagen, Auswertung im Fenster des ersten Folds – erhöhte ich λ als Stresstest auf 1.0, also auf das Hundertfache der explorativen 10⁻² der Studie. Hoyer stieg trotzdem nur von 0.474 auf 0.514. Das Modell war weiterhin nicht wirklich sparse.
Kein λ bestand das Kalibrierungstor. In einem Scan über λ∈{0.3,1,3,10,30} (K=64, Auswahlfenster) stieg Hoyer von 0.483 auf 0.619 und sättigte sich dann; der Validierungs-MSE stieg zugleich vom DenseAE-Wert 0.554 auf 0.918, also um 66%. Meine Regel verlangte einen Hoyer-Wert mindestens 0.15 über DenseAE und einen MSE von höchstens dem 1.2-Fachen. Bei λ=30 überschreitet Hoyer 0.619 knapp die Schwelle 0.618 (DenseAE liegt in dieser Auswertung bei 0.468, plus 0.15). Der MSE von 0.918 liegt aber etwa beim 1.4-Fachen der zulässigen Obergrenze von 0.664. Nach der vorab registrierten Regel wurde der Kalibrierungsarm nicht ausgeführt. "Zu wenig Dosis" erklärt allerdings nur die Hälfte: Im selben Protokoll war der Strafgradient bei λ=30 bereits etwa 7.7-mal so groß wie der Rekonstruktionsgradient. Die Dosis war also mehr als ausreichend, dennoch sättigte Hoyer bei etwa 0.62 und zuerst brach die Rekonstruktion ein. Auf diesem Panel sind die λ-Werte aus dem Bereich der Studie wirkungslos; außerhalb dieses Bereichs zeigt sich eine weitere Grenze. Mit diesen Daten scheint sich der Code nicht deutlich sparsamer machen zu lassen, ohne die Rekonstruktionsqualität zu verlieren. Die konkrete Ursache dieser Grenze wurde nicht gemessen und bleibt offen.
Warum kann dieselbe Gleichung mit demselben λ-Raster auf dem Panel der Studie die Korrelation innerhalb der Baskets auf ein Fünftel senken, während sie hier nicht einmal das Modell verändert? Der gemessene Teil ist klar: die relative Größenordnung von Straf- und Rekonstruktionsgradient. Alles Weitere ist eine Schlussfolgerung, deren Grenze ich markiere. Die relative Stärke von L1 hängt von der typischen Codeskala ab, und diese hängt von Asset-Anzahl und Querschnittsstruktur ab: Die Studie umfasst 433 Assets von 2019–2024, mein Panel 150 liquide Assets von 2022–2024. λ=0.1 kann auf ihrer Skala eine wirksame Dosis sein und auf meiner praktisch wie ein Placebo wirken. Eine alternative Erklärung lässt sich ebenfalls nicht ausschließen: Nicht veröffentlichte Implementierungsdetails könnten die tatsächliche Wirkung der Strafe gegenüber der gedruckten Gleichung verändern – etwa Minibatch-Training oder die Reduktionskonvention der Loss-Funktion. Die gedruckten Gleichungen legen nicht fest, ob der Rekonstruktionsterm über N Assets und der L1-Term über K Hidden-Dimensionen summiert oder gemittelt wird. Allein die Kombination dieser beiden Nenner könnte eine implizite Skalierung der effektiven Strafe um mehrere hundertfach erzeugen. Ohne offiziellen Code bleibt das eine Möglichkeit; daraus lässt sich keine Aussage über die Autoren ableiten.
Ein Punkt hängt nicht von diesen Vermutungen ab: Bei einer Standardimplementierung, die den gedruckten Gleichungen folgt, sind die λ-Werte der Studie keine Konstanten, die sich ohne Kalibrierung auf andere Panels übertragen lassen. Wer λ=0.1 unverändert auf eigene Daten anwendet und anschließend den "Diversifikationseffekt von SAE" berichtet, könnte einen Mechanismus beschreiben, der nie gegriffen hat.
## Von der Volatilität bleibt nur die Richtung; der Mechanismus kehrt sich um
Aggregierte Ergebnisse über fünf Folds (590 Tage, Money-Skala):
| Methode | Annualisierte Volatilität | Sharpe |
| --- | ---: | ---: |
| Naive Same-Day-Reversal | 31.39% | +1.69 |
| PCA K=64 | 29.54% | +1.75 |
| PCA K=128 | 30.39% | +1.32 |
| SAE K=64 (λ=10⁻²) | 29.90% | +0.65 |
| SAE K=128 (λ=10⁻³, ausgewählt) | 28.97% | +0.96 |
| DenseAE K=64 (λ=0) | 29.96% | +0.65 |
SAE-128 hat 4.7% niedrigere Volatilität als PCA-128 (pro Fold −4.0, −4.2, +3.1, −3.0, −10.0; in 4 von 5 Folds stimmt die Richtung mit der Studie überein). Das ist ungefähr ein Fünftel des strengen Ergebnisses der Studie von −20 bis −26%. Auch die statistische Einordnung ist wichtig: Der Mittelwert der fünf Fold-Differenzen beträgt −3.6% (nicht identisch mit dem gepoolten −4.7%; einmal wird über Folds gemittelt, einmal über tägliche Beobachtungen gepoolt), der t-Wert liegt bei etwa −1.7 (n=5). Das ist nicht signifikant. Mehr als Richtung und Größenordnung lässt sich hier nicht behaupten. Bei K=64 stimmt nicht einmal die Richtung: Die SAE-Volatilität liegt 1.2% über PCA. Angesichts des vorigen Abschnitts überrascht das nicht. Das ausgewählte "SAE" mit λ=10⁻³ ist nahezu dicht; sein kleiner Vorteil gegenüber PCA dürfte eher aus gewöhnlicher Autoencoder-Rekonstruktion stammen als aus Sparsity.
Zur Einordnung der Fold-Schwankungen hier die annualisierte Volatilität auf Money-Skala je Fold:
| Methode | Fold 1 | Fold 2 | Fold 3 | Fold 4 | Fold 5 |
| --- | ---: | ---: | ---: | ---: | ---: |
| Naive Reversal | 22.12% | 31.31% | 32.00% | 31.37% | 37.93% |
| PCA K=64 | 21.71% | 30.42% | 27.16% | 26.53% | 39.22% |
| SAE K=64 | 20.16% | 30.32% | 30.54% | 30.56% | 35.91% |
| PCA K=128 | 21.65% | 30.88% | 29.05% | 29.51% | 38.26% |
| SAE K=128 | 20.78% | 29.58% | 29.95% | 28.61% | 34.42% |
Auf der Mechanismusebene ist das Ergebnis noch klarer. Nach der Definition der Studie berechnete ich die mittlere paarweise Korrelation innerhalb der Baskets auf Rank-Skala mit einem rollierenden 60-Tage-Fenster. Beim SAE-64-Long-Basket lag sie bei 0.0215, beim Short-Basket bei 0.0297. PCA-64 lag bei 0.0201 / 0.0261. Die naive Reversal-Variante war noch niedriger: 0.0136 / 0.0148. Die Studie berichtet SAE 0.008 gegenüber PCA 0.039. Auf meinem Panel ist die Reihenfolge umgekehrt. Auf der Raw-Return-Skala liegen alle Methoden zwischen 0.56 und 0.60 (der gemeinsame Marktfaktor dominiert); auch dort ist kein SAE-Vorteil zu erkennen. Nur ein Teilbefund weist in dieselbe Richtung wie die Studie: Die individuelle Volatilität der Assets in den SAE-Baskets ist etwas höher als bei PCA (täglich 0.0478 gegenüber 0.0466). SAE wählte also nicht einfach ruhigere Assets – aber die ausgewählten Assets waren auch nicht weniger korreliert.
| Methode | Long-Basket-Korrelation | Short-Basket-Korrelation |
| --- | ---: | ---: |
| SAE K=64 | 0.0215 | 0.0297 |
| PCA K=64 | 0.0201 | 0.0261 |
| Naive Reversal | 0.0136 | 0.0148 |
| Studie: SAE / PCA | 0.008 / 0.039 | 0.010 / 0.044 |
Meine Einordnung der ersten Aussage der Studie lautet daher: Bei K=128 zeigt sich die Richtung teilweise, die Größenordnung reproduziert sich nicht; K=64 und die Mechanismusbehauptung reproduzieren sich nicht. Das widerlegt nicht die Ergebnisse der Autoren auf ihrem eigenen Panel – Panel, Zeitraum und Implementierung unterscheiden sich. Es zeigt aber, dass diese Aussage nicht ohne Kalibrierung als panelübergreifend übertragbar behandelt werden sollte.
## Einige Schlussfolgerungen der Studie stimmen mit meiner Replikation überein, andere nicht
Ein positiver Punkt der Studie ist, dass die Autoren Risikoreduktion nicht mit handelbarem Alpha gleichsetzen. Sie berichten ausdrücklich, dass SAE keinen zusätzlichen Sharpe liefert, die Faktoridentität über Random-Seeds nicht stabil ist und sich der IC nicht verbessert. Außerdem legen sie offen, dass Same-Close-Ausführung nicht umsetzbar ist, Kosten fehlen und die Universumsselektion nicht point-in-time erfolgt. In meiner Replikation stimmt die Richtung dieser negativen Befunde mit dem Autorenbericht überein. Die Sparsity-Trennung reproduziert sich jedoch nicht; das Overlay lässt sich wegen unklarer Konstruktionsdetails nicht sauber beurteilen.
- **Kein zusätzlicher Sharpe:** Die naive Reversal-Variante erreicht einen Money-Sharpe von +1.69, SAE-64 nur +0.65 und SAE-128 +0.96. Auch die Prognosequalität verbesserte sich nicht: Reversal-IC +0.0073 für SAE-64 gegenüber +0.0146 für PCA-64 (die Studie berichtet +0.016 gegenüber +0.021, gleiche Reihenfolge).
- **Faktoridentität reproduziert sich nicht über Seeds:** Hungarian Matching über drei Seed-Paare ergibt Decoder-Cosines von 0.217–0.220, gegenüber einer Random-Dictionary-Referenz von 0.198 (95. Perzentil 0.203). Das liegt nur leicht über Zufall – möglicherweise wegen einer gemeinsamen Marktrichtung –, ist aber weit entfernt von "derselben Faktorgruppe". Die Studie berichtet 0.13 gegenüber 0.117. Die Größenordnung ist wegen der anderen Asset-Anzahl unterschiedlich; die Schlussfolgerung ist dieselbe.
- **Sparsity-Trennung reproduziert sich nicht:** Die Hoyer-Werte der Studie sind 0.497 für SAE und 0.303 für DenseAE; bei mir sind es 0.479 und 0.478. Der Ursprung der fehlenden Lücke ist klar: Auf der SAE-Seite ändert sich kaum etwas (0.497 gegenüber 0.479); die gesamte fehlende Trennung liegt auf der DenseAE-Seite (0.303 gegenüber 0.478). Ich habe auch den Grund gemessen: Der Anteil exakt nuller Codes beträgt 47.7% bei SAE und 47.6% bei DenseAE. Auf diesem Panel sind durch ReLU bereits ohne Strafe fast die Hälfte der Codes null. Das dichte Modell ist konstruktionsbedingt schon "sparse", daher verschwindet der Abstand. Das ist die andere Seite des vorherigen Ergebnisses: Auf dem Panel der Autoren gibt es eine Sparsity-Trennung, auf meinem nicht.
Für das Overlay kann ich kein klares Urteil abgeben; ich halte die Ergebnisse daher unverändert fest. Die vorab registrierte Variante verwendete Ledoit–Wolf-Minimum-Variance-Gewichte je Leg, Raw-Return-Kovarianz und Money-Skala. Nach dem Overlay stieg die Volatilität auf 59.96%, weil sich die Gewichte zu stark konzentrierten. In der Rank-Skala-Variante lag die Volatilität bei 8.19 (Rank-Skala, kein Prozentwert), unter der naiven Variante mit 8.97 und unter beiden SAE-Varianten. Die Studie sagt nur, dass ein rollierendes 60-Tage-LW-Kovarianzmodell auf das naive Quintil-Portfolio angewendet wird; die Konstruktionsdetails sind nicht festgelegt. Welche meiner beiden Varianten "die Methode der Autoren" ist, lässt sich nicht entscheiden. Ich habe meine eigene Konstruktion weiter zerlegt: Jedes Leg enthält etwa 28 Assets, und der Median der Konditionszahl der 60-Tage-LW-Kovarianz liegt bei etwa 94; die Matrix ist also nicht pathologisch. Das Problem sind die Gewichte: Die Minimum-Variance-Lösung konzentriert jedes Leg auf etwa sechs effektive Positionen (Median des maximalen Einzelgewichts 27%). Die Volatilität von 59.96% ist Folge der Gewichtskonzentration, nicht einer singulären Matrix. Dieser Punkt bleibt inconclusive: Die Replikationskonstruktion ist auf meiner Seite nicht eindeutig genug festgelegt.
## Mit ausführbarem Timing verschwinden zuerst die Renditen, nicht die Volatilität
Der nächste Abschnitt stammt nicht aus der Studie, sondern ist meine eigene Erweiterung. Seine Schlussfolgerungen dürfen den Autoren nicht zugerechnet werden.
Die Studie bildet das Signal am Schlusskurs von Tag t und führt es zum selben Schlusskurs aus. Die Autoren kennzeichnen das selbst als nicht ausführbar. Ich habe dieselben Baskets auf die Ausführung zum Schlusskurs des Folgetags verschoben (den frühesten tatsächlich ausführbaren Zeitpunkt in diesem Setup) und stilisierte Kosten von 10 / 25 bps anhand des Turnovers ergänzt. Der tägliche Turnover liegt bei etwa 3.1 (Summe der absoluten täglichen Änderungen der kombinierten Gewichte beider Legs; das Maximum ist 4 – das Portfolio wird also fast täglich vollständig ausgetauscht).
| Methode | Gross-Sharpe gleicher Schlusskurs | Gross nächster Schlusskurs | Netto gleicher Schlusskurs 10 bps | Netto nächster Schlusskurs 25 bps |
| --- | ---: | ---: | ---: | ---: |
| SAE-128 | +0.98 | +0.05 | −2.98 | −10.07 |
| SAE-64 | +0.67 | +0.26 | −3.12 | −9.34 |
| Naive Reversal | +1.71 | −0.10 | −1.86 | −9.62 |
Hinweis: Arm D wurde anhand der gespeicherten Baskets über 589 Tage neu berechnet (einen Tag weniger als die Fünf-Fold-Aggregation). Deshalb weicht der Same-Close-Sharpe leicht von der Aggregattabelle ab, etwa +0.98 gegenüber +0.96 bei SAE-128. Die Differenz stammt ausschließlich von diesem einen Tag.
Wird die Ausführung um einen Tag verschoben, fallen die Gross-Sharpes aller drei Methoden in die Nähe von null. Das überrascht nicht: Die tägliche Reversal-Strategie verdient ihr Geld am ersten Tag nach Signalbildung. Mit 10 bps Kosten werden alle Ergebnisse negativ, bei 25 bps deutlich negativ. Eine Präzisierung zur Marktkonvention: Krypto wird rund um die Uhr gehandelt und kennt keine Schlussauktion. Ein "Tages-Schlusskurs" ist nur ein Snapshot zu einem Zeitpunkt. Daher ist die Spalte mit Same-Close-Ausführung plus Kosten eigentlich die bessere Annäherung an ein ausführbares Setup (reale Latenz und Slippage müssten zusätzlich abgezogen werden). Next-Close überträgt eine konservative Konvention aus dem Aktienmarkt. Sie misst die Obergrenze der Ausführungslücke, nicht das normale Verhalten des Kryptomarkts. Die Volatilität verändert sich über Timing- und Kostenvarianten kaum und bleibt bei 28–31%: Kosten sind ein gleichmäßiger Abschlag, während die Zeitverschiebung die Reversal-Prämie selbst entfernt. Das Risikoniveau ändert sich dadurch nicht.
Die Autoren haben nie behauptet, dass die Strategie handelbar sei. Dieser Abschnitt quantifiziert die praktische Größe ihres Disclaimers: Zwischen "Signal-Evidenz" und einer "handelbaren Schlussfolgerung" liegt ein ganzes Bündel von Ausführungsannahmen. Jedes tägliche Cross-Sectional-Modell, das Sharpe unter Same-Close-Ausführung berichtet, sollte diese Prüfung bestehen, bevor es stärkere Aussagen macht.
## Diese Prüfungen werde ich bei ML-Faktorstudien zuerst durchführen
Aus dieser Replikation bleibt eine nützlichere Checkliste als das Hauptergebnis. Auch die Reihenfolge steht jetzt fest:
1. **Ablation-Identitätsprüfung:** Den behaupteten Mechanismus ausschalten (hier λ=0) und Gewichte, Mechanismusstatistiken (hier Hoyer) sowie nachgelagerte Kennzahlen vergleichen. Sind beide Modelle nicht unterscheidbar, zuerst "Mechanismus hat nicht gegriffen" berichten und nicht sofort über Effektgrößen sprechen. Hätte ich diese Prüfung zuerst gemacht, hätte ich mir einen langen Umweg erspart.
2. **Die einfachste Baseline:** Naive Same-Day-Reversal erzielte auf beiden Panels den höchsten oder fast höchsten Sharpe. Ein komplexes Modell sollte diese Baseline zuerst schlagen.
3. **Das Lehrbuch-Overlay:** Wenn ein Kovarianz-Overlay den Großteil des Vorteils zurückholen kann, bleibt vom Modell nur der inkrementelle Rest. In diesem Lauf konnte ich das nicht sauber reproduzieren, aber die Prüfung gehört trotzdem dazu.
4. **Seed-Stabilität:** Mit anderen Seeds neu trainieren, Faktoren matchen und gegen eine Zufallsreferenz vergleichen. Scheitert diese Prüfung, bedeutet "Faktoren entdeckt" nur, dass "dieser Lauf einige Richtungen erzeugt hat".
Zurück zu den 0.999998 vom Anfang. Das ist vermutlich die aussagekräftigste Zahl dieser Replikation. Gleichungen, Parameter und Evaluationsprotokoll der Studie lassen sich wortgetreu kopieren. Ob der Mechanismus tatsächlich greift, steht nicht auf dem Papier; das muss auf dem eigenen Panel gemessen werden. Ob die Volatilität um ein Viertel oder um 4.7% sinkt: Solange Sparsity nicht bestätigt ist, sind es nur Zahlen eines Rekonstruktionsmodells.
**Replikationsgrenze und Materialien:** Die Schlussfolgerungen gelten nur für das reduzierte Universum (150 liquide Assets, 2022–2024, mit Survivorship-Tilt) und meine eigene Implementierung der gedruckten Gleichungen (NumPy, Gradient per Finite-Differenzen geprüft). Dieser Artikel bestätigt oder widerlegt nicht die Ergebnisse der Autoren auf ihrem 433-Asset-Panel von 2019–2024. Die Daten sind öffentliche Binance-Tagesdaten und lassen sich anhand der beschriebenen Regeln rekonstruieren. Der offizielle Code der Autoren war zum Zeitpunkt der Erstellung nicht veröffentlicht. Zahlen aus der Studie sind als Autorenangaben gekennzeichnet. Dieser Artikel behandelt nur Replikationsmethoden und Evidenzgrenzen; er ist keine Anlageberatung.
Replikationscode, eingefrorene Asset-Liste (mit Hashes), Fold-Ergebnisse und Interpretationsnotizen sind öffentlich. Das Materialpaket enthält SHA256SUMS, sodass sich jede Datei einzeln prüfen lässt.
vxime/sae-crypto-factor-replication
Wer diese Replikation in einen breiteren quantitativen Forschungsablauf einordnen möchte, kann auch [Wie man die Aussagekraft eines quantitativen Faktors prüft](/posts/quant-factor-validation-bucket-spread-rank-ic/) und [Wie man Gewichte in Multi-Faktor-Modellen sicher anpasst](/posts/adaptive-factor-weighting-regime-shadow-drift/) lesen. Der erste Beitrag prüft, ob die Ranginformation trägt; der zweite behandelt die Kontrolle von Gewichtsänderungen, nachdem solche Evidenz in ein Modell gelangt ist.
## Verification context
- Level: first-party
- Verified: 2026-11-01T00:00:00.000Z
- Environment: Python 3.12 / NumPy-Neuimplementierung (Finite-Differenzen-Gradiententest bestanden)
- Environment: Binance-Spot-USDT-Tagesdaten über öffentliche API (kein API-Key)
- Environment: Fixiertes Universum aus 150 liquiden Assets, 2022-01-01 bis 2024-12-31
- Environment: Fünf expanding-walk-forward-Folds / 590 Auswertungstage
- Evidence mode: mixed
- Public repository: https://github.com/vxime/sae-crypto-factor-replication
- Evidence commit: c93188255f57c0ca17d53d9b8f028314672e5dd0
- Evidence receipt: https://vxi.me/evidence/sae-crypto-factor-replication-lambda.json