# 114 Ausführungen in derselben Nanosekunde: Wo die Hawkes-Likelihood falsch wird
> Canonical: https://vxi.me/de/posts/hawkes-itch-nanosecond-ties-likelihood/
> Locale: de-de
> Published: 2026-10-31
> Updated: 2026-10-31
> Markdown: https://vxi.me/de/posts/hawkes-itch-nanosecond-ties-likelihood.md
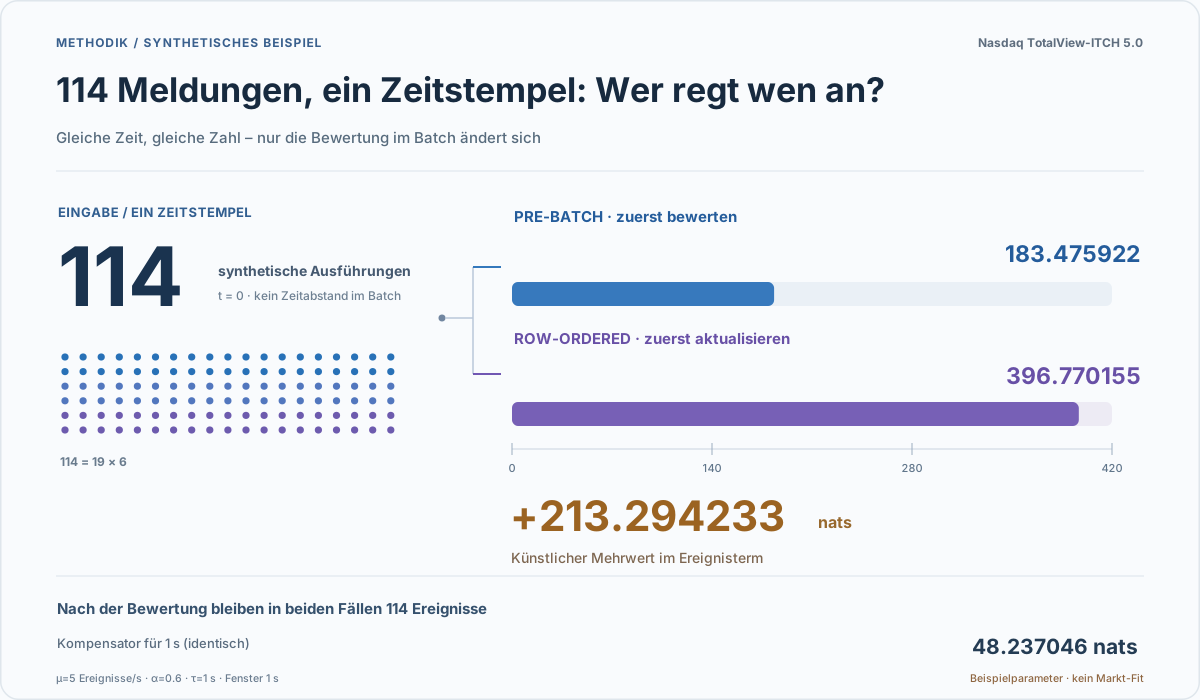
Abbildung: zwei Bewertungsregeln im synthetischen Batch, keine AAPL-Modellanpassung.
Beim Aufbereiten eines NASDAQ-ITCH-Orderstroms stieß ich auf eine Zahl, die ich nicht einfach an eine gewöhnliche Hawkes-Schleife mit Zustandsaktualisierung nach jeder Zeile übergeben wollte: **114**.
In den AAPL-Daten der regulären Handelssitzung vom 30. Juli 2019 haben **114 `execution`-Nachrichten denselben Nanosekunden-Zeitstempel**. Batches mit 131 und 187 Zeilen kommen jeweils ebenfalls einmal vor. Von **49,172 Ausführungsnachrichten teilen sich 30,080 (61.17%) ihren Zeitstempel** mit mindestens einer weiteren Zeile. Gleichstände sind alltäglich; Hunderter-Batches liegen im extremen Rand der Verteilung.
„Ausführungsereignis“ bezeichnet hier eine ITCH-Nachrichtenzeile gemäß unserer Forschungsdefinition, **nicht** 114 verschiedene Aufträge oder den Nachweis, dass 114 Abschlüsse physikalisch gleichzeitig stattfanden.
Das Problem: Aktualisiert ein Algorithmus die Hawkes-Anregung nach jeder Eingabezeile, wird selbst bei Zeitdifferenz null die 114. Zeile von den 113 vorherigen angeregt. Bei einer asymmetrischen Anregungsmatrix zwischen Ereignistypen kann sich der Score allein durch Umordnen der Dateizeilen ändern. **Welche zeitliche Reihenfolge darf das Modell innerhalb desselben aufgezeichneten Zeitstempels unterstellen?**
Unsere Entscheidung fiel **vor** dem Fit: nach Symbol und ganzzahligem Nanosekunden-Zeitstempel gruppieren, sämtliche Ereignisse mit der Historie **vor** dem Batch bewerten und den Zustand erst danach um die tatsächlichen Häufigkeiten aktualisieren. Die Übertragungsreihenfolge der Börsennachrichten ist Information, aber ohne zusätzliches Beobachtungsmodell keine gemessene physikalische Zeit unterhalb einer Nanosekunde.
## Gleiche Zeitstempel sind häufig – 114 Zeilen sind ein Extremfall
Die [offizielle Nasdaq-TotalView-ITCH-5.0-Spezifikation](https://nasdaqtrader.com/content/technicalsupport/specifications/dataproducts/NQTVITCHSpecification.pdf) definiert Zeitstempel als Nanosekunden seit Mitternacht. `E` bedeutet Order Executed, `C` Order Executed With Price. Auch ein und dieselbe Auftragsreferenz kann in mehreren Teilausführungsnachrichten erscheinen.
Für die Studie definieren wir drei Ereignistypen: `add=A/F`, `cancel_delete=X/D` und `execution=E/C`. Bei `C` zählen **`Printable=Y` und `Printable=N`**; es handelt sich nicht bloß um druckbare Trades. `P` (Trade mit nicht angezeigter Order) und `Q` (Cross Trade) bleiben draußen. Das ist eine Forschungsdefinition und keine allgemeingültige Nasdaq-Taxonomie sämtlicher Umsätze.
Die folgende intern geprüfte Aggregation gilt für **AAPL am 2019-07-30, 09:30–16:00 Uhr US-Ostküstenzeit**, also die gesamte reguläre Sitzung:
| Kennzahl | Beobachteter Wert |
| --- | ---: |
| `execution`-Nachrichtenzeilen | 49,172 |
| Verschiedene Nanosekunden-Zeitstempel | 29,379 |
| Zeitstempel mit mehreren Zeilen | 10,287 |
| Zeilen mit identischem Zeitstempel | 30,080 (61.17%) |
| Median / Modus der Batchgröße bei Gleichständen | 2 / 2 Zeilen |
| Batches mit 2–3 Zeilen | 8,439 (82.04% der gleichzeitigen Batches) |
| Ein Batch mit genau 114 Zeilen | 1 |
| Größere Batches mit 131 / 187 Zeilen | Jeweils 1 |
Eine frühere Analyse nutzte das gemeinsame Zeitfenster **09:30–11:00** über mehrere Tage. Diese beiden Abdeckungen dürfen nicht vermischt werden. Das gespeicherte Histogramm enthält Batchgrößen, aber nicht die individuellen Order-Identitäten oder eine rekonstruierbare physikalische Reihenfolge.
Über alle 29,379 Zeitstempel liegen im Mittel **1.67 Zeilen** vor. Für die 10,287 Mehrfach-Batches sind es **2.92**; Median und Modus sind jeweils **2**. Ein Batch mit 114 Zeilen ist rund **39-mal** so groß wie dieser Mittelwert. Nur drei Batches erreichen 114 oder mehr Zeilen (114, 131, 187). Als Stresstest eignet sich das hervorragend, als typischer Fall nicht.
Dass 61.17% der Zeilen Zeitstempel teilen, beweist **nicht allein**, dass Hawkes-Parameter unidentifizierbar sind. Die pre-batch-Konvention verzichtet auf unbekannte Subnanosekunden-Abstände innerhalb des Batches; Abstände und Typkombinationen zwischen Batches liefern weiterhin Information.
## Wer darf zum selben Zeitpunkt wen anregen?
Für einen Hawkes-Prozess mit drei Ereignistypen und exponentiellem Kernel schreiben wir die bedingte Intensität als:
```text
lambda_k(t-) = mu_k(t)
+ sum_j [alpha[k,j] / tau
* sum_{u0` entspricht, erfüllt die zeilenweise Anregungsdifferenz bei Batchgröße `m` folgende Ungleichung:
```text
0 <= Delta(m) = sum_{i=0}^{m-1} log(1 + alpha*i/(tau*lambda^-))
<= sum_{i=0}^{m-1} log(1 + alpha*i/(tau*mu))
```
Die rechte Seite ist eine **bedingte obere Schranke für dieses Ein-Typ-Szenario**, keine allgemeine Fehlerschranke für die vollständige Drei-Typen-Hawkes-Likelihood. Weder die wahre Vorabintensität noch weitere gleichzeitig auftretende Typen sind bekannt.
Mit `mu=5` Ereignissen/s ergeben sich aus den gespeicherten Häufigkeiten:
| Angenommenes alpha | tau=0.1 s | tau=1 s | tau=10 s |
| --- | ---: | ---: | ---: |
| 0.1 | 8,392.65 | 1,436.32 | 178.46 |
| 0.3 | 17,088.26 | 3,472.79 | 500.41 |
| 0.6 | 25,186.19 | 5,837.61 | 928.45 |
Alle Werte sind in **nats** und beruhen auf erfundenen Parameterannahmen. Für `mu=5, alpha=0.3, tau=1` beträgt die kumulierte bedingte Schranke **3,472.79 nats**, geteilt durch 49,172 Ausführungszeilen **0.0706 nats/Zeile**. Ein typischer Batch aus zwei beziehungsweise drei Zeilen hat unter derselben Annahme **0.0583** bzw. **0.1716 nats** als obere Schranke. Ändert man die künstliche Intensitätsuntergrenze `mu` auf 1 oder 20, wird die Summe **11,044.42** bzw. **1,125.70 nats**.
Über die neun Kombinationen liegt die bedingte Schranke zwischen **178.46 und 25,186.19 nats**, entsprechend **0.00363–0.51221 nats/Zeile**. Daraus lassen sich **keine** echten AAPL-Likelihood-Fehler oder gefitteten Marktparameter ableiten.
Entfernt man im mittleren Szenario die größten Batches, erhält man:
| Ausgeschlossene größte Batches | Rückgang der oberen Schranke (nats) | Anteil an ursprünglicher Schranke |
| --- | ---: | ---: |
| 187 Zeilen (Top 1) | 321.54 | 9.26% |
| 187, 131, 114 Zeilen (Top 3) | 665.62 | 19.17% |
| Die 10 größten Batches | 1,123.57 | 32.35% |
Die drei größten Batches umfassen nur **432 Zeilen**, stellen aber nahezu ein Fünftel dieser *speziellen* angenommenen Schranke. Das gespeicherte Histogramm enthält **keine Uhrzeiten** dieser Extrem-Batches; Aussagen über Eröffnungs-/Schlussauktionen, Matchingmechanismen oder Zeitstempel-Encoding sind deshalb nicht möglich.
Diese künstliche Sensitivitätsrechnung und der Abgleich des Histogramms wurden in einer gesonderten **13/13**-Testsuite geprüft. Die nachfolgenden 99 Forschungstests sind eine andere Ausführung.
## Was haben die 99 Tests wirklich bewiesen?
Die reale AAPL-Aggregation zeigt, dass gleich gestempelte Ausführungszeilen existieren und welche Größen sie erreichen. Synthetische Tests mit **bekannten** Parametern prüfen dagegen die Rechenvorschrift für Batch-Score, Zustand und Kompensator. Diese Evidenztypen sind nicht austauschbar.
| Synthetische Tests | Was geprüft wurde |
| --- | --- |
| Batch-Bewertung (10) | Einheitliche Intensität vor Batchbeginn, volle Multiplizität, Invarianz gegenüber der Zeilenfolge |
| Vollständige Likelihood (33) | Basis- und Kernel-Kompensator; analytische gegen numerische Integration |
| M0/M1/M2-Verträge (34) | Homogener Poisson, saisonaler NHPP mit 78 Intervallen und Hawkes mit drei Typen bei bekannten Parametern |
| Synthetische Ereignisfolgen (22) | Ogata-Thinning mit festem Seed, unabhängige Summation, Determinismus zweier Prozesse |
| Gesamt | **99/99 Forschungstests bestanden** (Python 3.13.5, isoliertes Linux x86_64) |
Ein eigens konstruierter Testfall umfasst **209 synthetische Ereignisse in vier Zeitstempelgruppen**: 90 Adds bei Sitzungsbeginn, 114 Executions nach +1 s, 3 Cancel/Delete nach +2 s, nach +3 s noch 1 Add und 1 Execution zusammen. Die Batchgrößen lauten **90/114/3/2**. Gegen einen unabhängig implementierten direkten Historien-Summen-/Integrationspfad betrug die größte absolute Abweichung etwa `1.42e-14`; eine Umkehr der Eingabezeilen änderte den Score nicht.
Zwei weitere durch Ogata-Thinning erzeugte kontinuierliche synthetische Ereignisströme enthielten **285** beziehungsweise **265** Ereignisse. Die unabhängigen Likelihood-Vergleiche wichen höchstens um etwa `7.11e-15` ab. Die simulierten Ströme erzeugten **nicht von selbst 114 exakte Zeitstempel-Gleichstände**: der Extrem-Batch ist absichtlich konstruiert.
Die 99 Tests wurden historisch unter Python 3.13.5 / isoliertem Linux x86_64 ausgeführt. **Das ist kein GitHub-Actions-PASS des gegenwärtigen Redaktions-HEAD.** Weder reale Marktparameter-Fits noch Hold-out-Scores oder eine Überlegenheit gegenüber saisonalem NHPP wurden bisher nachgewiesen.
## Die Grenze: Arbeits-Likelihood statt exakter Beobachtungsdichte
Bei einem einfachen kontinuierlichen Punktprozess haben exakt gleichzeitige Ankünfte normalerweise Wahrscheinlichkeit null. ITCH-Zeitstempel sind beobachtete bzw. kodierte Nanosekundenmarkierungen; die bekannte Nachrichtenreihenfolge enthüllt keine darunterliegende physikalische Zeit. Unsere **pre-batch-Arbeits-Likelihood (auch Pseudo-Likelihood-Score)** ist somit eine offen benannte Konvention, **keine abgeleitete exakte gemeinsame Dichte** für zeitlich quantisierte Beobachtungen. Ohne definierte Teildichten und Abhängigkeitsbehandlung ist auch die Bezeichnung `composite likelihood` nicht gerechtfertigt.
Für Zählungen in festen Zeitintervallen kommt ein diskretes Count-Modell infrage; für nicht beobachtete Ankünfte innerhalb der Intervalle ein Modell mit Intervallzensierung. Das Durchspielen alternativer Reihenfolgen kleiner Batches ist eine Sensitivitätsanalyse, kein universeller Codeersatz.
Wenn bei **identischen Daten, Gruppen und Beobachtungsmodellen** beide verglichenen Scores dieselbe parameterunabhängige Konstante `C(D)` auslassen, hebt sie sich in der **Differenz** auf: `(LL_A+C(D))-(LL_B+C(D))=LL_A-LL_B`. Ein `-sum log(m!)` kann in bestimmten diskreten Zählmodellen so eine Konstante sein. Dadurch bleibt die absolute LL nicht unverändert, und allein das Hinzufügen des Fakultätsterms macht pre-batch nicht zu einer exakten Beobachtungs-Likelihood. Andere Gruppierungen oder Zeitkonventionen verletzen möglicherweise die Voraussetzung.
Ebenso darf ein klassischer Chi-Quadrat-Likelihood-Ratio-Test nicht automatisch angewandt werden: Nichtnegative Anregungsparameter liegen am Rand; Abklingparameter können unter der Nullhypothese unidentifizierbar sein.
## Residuen bei gleichzeitigen Zeitstempeln prüfen
Wer 114 gleich gestempelte Zeilen als 114 aufeinanderfolgende Ankünfte behandelt, erzeugt sehr viele Null-Abstände und verzerrt die Zeitreskalierung. Unser vorab definierter Diagnoseplan bildet Residuen auf Basis der **eindeutigen Zeitstempel je Ereignistyp** und führt die Batch-Multiplizität separat. QQ-Plots, Autokorrelation und KS-Abstände beschreiben die Abweichung; ein klassischer KS-`p`-Wert unter der Annahme kontinuierlicher Ankünfte ohne Ties gilt **nicht** als formaler Test. Für späteres Bootstrap oder Permutationen braucht es zunächst Nullhypothese, Datengenerator und eine Resampling-Einheit, die Batch-Abhängigkeiten erhält.
**Die Reihenfolge der Zeilen in einer Datei darf nicht heimlich zur kausalen Ereigniszeit werden.**
Oeffentliche Reproduktionsdateien: [Python-Skripte, Histogramm, Tests und SHA-256-Pruefsummen](/evidence/hawkes-itch-nanosecond-ties-likelihood/README.md).
## Verification context
- Level: first-party
- Verified: 2026-10-31T00:00:00.000Z
- Environment: Python 3.13.5; Linux x86_64; historical synthetic research tests
- Environment: Python 3 standard-library public reproducer and aggregated histogram
- Evidence mode: mixed
- Evidence receipt: https://vxi.me/evidence/hawkes-itch-nanosecond-ties-likelihood.json